تجتاح منصات التواصل المالي للأفراد على يوتيوب وإنستغرام وتيك توك ومنصة إكس موجة واسعة الانتشار يعمد فيها صناع المحتوى إلى توجيه مطالبات نصية أو رفع لقطات شاشة لمخططات الشموع داخل النماذج اللغوية الكبيرة الحوارية (LLMs) ونماذج الرؤية واللغة متعددة الوسائط (VLMs) مثل نماذج ChatGPT، ونموذج Claude، ونموذج Gemini، ونموذج DeepSeek لاستشراف مسارات البيتكوين والذهب وأزواج الصرف الأجنبي. ونظراً لأن النماذج اللغوية الموائَمة بعد التدريب تصوغ سرديات مصقولة نحوياً تحاكي نبرة التقارير المؤسسية، يخلط الجمهور غير المتخصص بانتظام بين الفصاحة البلاغية والميزة الكمية الحقيقية. واستناداً إلى براهين علوم الحاسوب النظرية والاختبارات المعيارية التجريبية المحكمة المنشورة في مؤتمرات STOC، ومؤتمر NeurIPS، ومؤتمر ICLR، ومؤتمر AAAI، ومجلة The Journal of Finance، تثبت هذه الورقة البحثية لماذا تُعد النماذج التوليدية الانحدارية الذاتية غير صالحة بنيوياً للتوقع العددي للأسواق المالية. نصوغ رياضياً خمس آليات للإخفاق البنيوي: (1) انهيار الاتصال المتري الإقليدي تحت وطأة التقطيع الرمزي دون الكلمي للأرقام، (2) الإسقاط الفاقد للمعلومات من الرقع البكسلية المكانية إلى فضاء المفردات اللغوية عندما تفحص نماذج الرؤية واللغة صور الشموع البيانية، (3) تباعد المخرجات من استعلام إلى آخر عبر التشغيلات المتكررة حتى عند تثبيت درجة الحرارة على الصفر جنباً إلى جنب مع الحدود الدنيا لغود-تورينغ التي تحتم الهلوسة الإحصائية، (4) المجاراة التملقية للمستخدم والسفسطة الإقناعية الناتجة عن تدريب RLHF مقترنةً بتلوث استباق المستقبل في الاختبارات التاريخية الخلفية، و(5) الانهيار الجسيم في معايرة الاحتمالات تحت مخاطرة رأس المال الحي. وختاماً، نحدد الحد المعماري الفاصل داخل منظومة 4CastMachine AI: حصر النماذج اللغوية السياقية داخل محرك Sentiment AI لترميز قطبية الأخبار غير المهيكلة وقياس التشابه الدلالي مع الأحداث التاريخية، مع تفويض كامل الهندسة السعرية المتصلة، والموازنة النظامية، ورسم خرائط الطريق على المخطط حصرياً إلى المحركات الكمية Forecast AI، ومحرك Synergy AI، ومحرك Navigator AI.
1. الخطأ التصنيفي واسع الانتشار ومغالطة الصحفي الفصيح أمام المعادلات التفاضلية
خلال السنوات الثلاث الماضية، حققت النماذج اللغوية الكبيرة الحوارية (LLMs) طلاقة لافتة في صياغة النصوص باللغات الطبيعية، وتوليد المقاطع البرمجية، وتلخيص الوثائق الطويلة. غير أن هذه القدرة اللغوية الفائقة أطلقت خطأً منهجياً واسع النطاق في إعلام التداول المالي الموجه للأفراد؛ إذ يعمد صناع المحتوى ذوو الانتشار الواسع يومياً على منصات يوتيوب وإنستغرام وتيك توك وإكس إلى لصق جداول أسعار الافتتاح والأعلى والأدنى والإغلاق (OHLC) أو رفع لقطات شاشة لمخططات الشموع اليابانية داخل نماذج المحادثة العامة، ثم بث المستويات السعرية الناتجة إلى ملايين المتابعين بوصفها توقعات كمية للسوق.
في نظر المشاهد غير المختص بالرياضيات التطبيقية، تبدو المخرجات النصية لتلك النماذج بالغة الرصانة والسلطة العلمية. ففي غضون ثوانٍ معدودة، يسمّي النموذج اللغوي محفزات الاقتصاد الكلي، ويستحضر أنماطاً بيانية مألوفة مثل الأوتاد الصاعدة أو مستويات تصحيح فيبوناتشي، ويكتب فقرة مصقولة بعناية تستشرف المستوى الذي ستتداول عنده عملة البيتكوين (BTCUSD) أو الذهب (XAUUSD) خلال الأسبوع المقبل. وعندما يُطلب من النموذج في نص المطالبة تقمص نبرة كبير استراتيجيي الاستثمار في مؤسسة مالية دولية، يحاكي النموذج المعجم الاصطلاحي المؤسسي بثقة نحوية مطلقة لا يشوبها أدنى تردد لفظي.
بيد أنه تحت هذا الصقل البلاغي الظاهري يكمن خطأ تصنيفي جوهري (Category Error) في صميم الرياضيات التطبيقية. فالأسواق المالية أنظمة تصادفية متصلة القيم، غير مستقرة زمنياً (Non-Stationary)، تتسم بانخفاض شديد في نسبة الأثر الحقيقي إلى الضوضاء، وتحكمها آليات مطابقة السيولة في دفاتر الأوامر المحددة، والتقلبات الشرطية غير المتجانسة، وعمليات القفز ذات الذيول السميكة. وعلى النقيض تماماً، تُعد النماذج اللغوية الانحدارية الذاتية مولّدات تسلسلات متقطعة دُرِّبت حصرياً لتقدير أي شظية لفظية هي الأرجح إحصائياً لأن تتبع سلسلة من الشظايا اللفظية السابقة داخل مدونات النصوص البشرية المكتوبة.
ويجلّي تشبيه بنيوي ملموس السبب الذي يجعل استبدال أحد هذين الميدانين الرياضيين بالآخر أمراً ممتنعاً من حيث المبدأ. إن مطالبة نموذج لغوي توليدي بحل مسار سوقي حي متعدد الآفاق الزمنية تكافئ تماماً مطالبة صحفي بارع فصيح العبارة في جريدة يومية بحل منظومة مقترنة من المعادلات التفاضلية التصادفية غير الخطية تحت مخاطرة فورية لرأس المال الحي. بمقدور الصحفي المتمرس أن يكتب مقالاً آسراً من ألف كلمة عن تاريخ حساب التفاضل والتكامل، وأن يقتبس عبارات كبار علماء الرياضيات، وأن ينسق الفقرات ببراعة تجعل القارئ غير المختص يظن أن المعادلات قد حُلَّت بالفعل.
إلا أن فصاحة الإنشاء اللغوي لا تنفّذ تكاملاً عددياً واحداً. والأنكى من ذلك أنه نظراً لأن فك التشفير التوليدي يعاين المفردات عشوائياً من توزيعات احتمالية مسطحة ويعاني معدلات هلوسة إحصائية لا تتلاشى، فإن ذلك الراوي اللغوي يتصرف تحت ضغط الأسواق المتقلبة كصحفي مخمور يأبى الاعتراف بعدم اليقين مهما غابت عنه المعطيات؛ فإذا طرحت عليه السؤال ذاته مرتين متتاليتين، قد يعكس اتجاهه السعري دون سابق إنذار. وإذا طرحت عليه السؤال ذاته مئة مرة متطابقة، فستختلق عدة إجابات مستويات دعم لا وجود لها على الرسم البياني أو تخطئ في عمليات الطرح الحسابي الأولية، مع احتفاظها في كل مرة بالوقار البلاغي ذاته.
ولصياغة هذا التعارض البنيوي صياغةً رياضيةً صارمة، نقارن دالة الهدف في تحسين النموذج اللغوي الانحداري الذاتي بدالة الهدف في تحسين محرك التوقع الكمي المعايَر إحصائياً. وقبل كتابة المعادلتين، تأمل بدقة ما الذي تكافئه كل دالة خسارة وما الذي تعاقب عليه أثناء التدريب: يقلل النموذج اللغوي المفاجأة اللفظية عبر معرّفات الرموز المتقطعة، في حين يقلل محرك فضاء الحالة الكمي المسافة المترية وخطأ معايرة الاحتمالات عبر النتائج السعرية الحقيقية المتصلة.
ليكن الرمز 𝒱 معجماً منتهياً للوحدات اللفظية الفرعية بحجم |𝒱| ≈ 32,000..200,000، ولتكن المتتالية v1:K ∈ 𝒱K سلسلة نصية مقطَّعة إلى وحدات رمزية. يعمل النموذج اللغوي الانحداري الذاتي ذو المعاملات θ على تدنية الإنتروبيا المتقاطعة المتقطعة للوحدات الرمزية ℒLLM(θ). وفي المقابل، ليكن الموتّر 𝐗t-L:t ∈ ℝL×d موتّر حالة السوق ذا القيم الحقيقية المتصلة، وليكن المتغير Pt+τ ∈ ℝ+ السعر المستقبلي المحقق عند الأفق الزمني τ. يُخرج المحرك الكمي ذو المعاملات ψ دالة توزيع تراكمي Fψ(y | 𝐗t-L:t) تُدني معيار الاحتمال الترتيبي المتصل (CRPS، غنايتينغ ورافتري Gneiting and Raftery [16]):
في المعادلة (1)، تقيّم دالة الخسارة ℒLLM(θ) مؤشراً فئوياً أحادي الترميز (One-Hot) على فهرس المفردة vk: فكل وحدة رمزية خاطئة تتكبد عقوبة اللوغاريتم السالب للأرجحية ذاتها تماماً بصرف النظر عن مقدار الخطأ العددي في السعر. وعلى العكس من ذلك، يكامل المعيار CRPS(Fψ, Pt+τ) مربع خطأ الاحتمال التراكمي على امتداد خط الأعداد الحقيقية ℝ بأكمله، معاقِباً بصرامةٍ كلاً من المسافة المترية عن السعر المحقق Pt+τ واختلال معايرة التشتت الاحتمالي.
لنفترض أن عملة البيتكوين تتداول عند المستوى 64,570 وأن القيمة العادلة الحقيقية غداً هي 65,000. تحت دالة الإنتروبيا المتقاطعة المتقطعة ℒLLM، قد يؤدي إخراج السلسلة النصية "64,999" (بفارق خطأ قدره $1 واحد فقط) إلى عقوبة خسارة رمزية أعلى من إخراج السلسلة "95,000" (بفارق خطأ كارثي قدره $30,000) متى كانت ثنائية المقاطع النصية "95"+",000" أكثر شيوعاً وتردداً في نصوص التقارير المالية على الإنترنت! أما تحت معيار CRPS المتصل، فيُعاقَب الخطأ البالغ $30,000 أشد بثلاثين ألف ضعف في القيمة المتوقعة من خطأ الدولار الواحد $1، مما يربط كل تحديث لمعاملات النموذج بالمخاطرة المالية الحقيقية.
وتؤكد الاختبارات المعيارية التجريبية المحكمة أن التدريب المسبق على تريليونات الكلمات لا يمنح الشبكة العصبية أي مهارة حقيقية في توقع السلاسل الزمنية العددية. ففي دراسة مرجعية مميزة (Spotlight) نُشرت في مؤتمر NeurIPS 2024، دقق الباحثون تان وميريل وغوبتا وألتوف وهارتفيغسن (Tan, Merrill, Gupta, Althoff, and Hartvigsen [1]) أبرز البنى المعمارية للسلاسل الزمنية المعتمدة على النماذج اللغوية، وفي مقدمتها نماذج Time-LLM، ونموذج OneFitsAll (GPT4TS)، ونموذج CALF عبر مجموعات الاختبار القياسية للتوقعات. وأجرى المؤلفون تجارب بتر وحذف منهجية (Systematic Ablations) أزالوا فيها أوزان النموذج اللغوي المدرَّب مسبقاً بالكامل، أو استبدلوا العمود الفقري اللغوي ذا المليارات من المعاملات بطبقة انتباه خفيفة واحدة أو طبقة إسقاط خطية بسيطة مدرَّبة من الصفر.
وقد قوضت النتيجة الفرضية التأسيسية لتوقع السلاسل الزمنية عبر النماذج اللغوية من جذورها؛ إذ لم يتسبب حذف العمود الفقري للنموذج اللغوي في أي تدهور على الإطلاق في دقة التوقعات، بل أدى في كثير من الحالات إلى تحسين متوسط مربع الخطأ (MSE) ومتوسط الخطأ المطلق (MAE)، مع خفض عدد المعاملات وتكلفة الحوسبة الاستدلالية بمقدار يتراوح بين مرتبتين إلى ثلاث مراتب أسية كاملة (أي من مئة إلى ألف ضعف) [1]. وحتى في أنظمة شح البيانات (Few-Shot Regimes) التي ادعى فيها المؤيدون أن التدريب اللغوي المسبق ينقل قدرة الاستدلال التسلسلي إلى الأرقام، لم تقدم أوزان النماذج اللغوية الضخمة أي مكسب قابل للقياس مقارنةً بالمشفرّات العددية الضئيلة. وتتفق هذه الحقيقة مع ما أثبته تسنغ وتشن وتشانغ وشو في مؤتمر AAAI [15] من أن التحويلات الخطية المباشرة البسيطة تتفوق بوضوح على المحولات التسلسلية المعقدة حينما يتشوه الترتيب الزمني والمقياس العددي بفعل إسقاط الرموز اللفظية.
2. انهيار المترية في التقطيع الرمزي دون الكلمي ولماذا ترى نماذج الرؤية متعددة الوسائط موجات شكلية دون قياس المخاطر
لفهم السبب الذي يجعل توسيع حجم نموذج لغوي من سبعة مليارات معامل إلى أكثر من تريليون معامل عاجزاً أبداً عن تحويله إلى محرك كمي موثوق، يتعين علينا فحص ما يحدث لأرقام السوق الخام عند الطبقة الأولى تحديداً من طبقات الشبكة العصبية. تستوعب الخوارزميات الكمية سلاسل الأسعار وأحجام التداول والتقلبات بوصفها أعداداً عشرية ذات فاصلة عائمة بدقة 64 بت وفق معيار IEEE-754. وتشكل الأعداد الحقيقية حقلاً مترياً تاماً: فالجمع والضرب والترتيب التراتبي والمسافة الإقليدية هي عمليات عتادية أولية مضبوطة بدقة تامة.
أما النماذج اللغوية فلا تستوعب كميات عددية ذات فاصلة عائمة أصلاً. فقبل أن يرى المحول العصبي سعراً واحداً، يقوم مقطِّع نصوص يعتمد على خوارزمية ترميز أزواج البايت (BPE) أو أداة SentencePiece بتشريح السلسلة النصية الخام للأرقام إلى شظايا متفاوتة الطول بناءً على تكرار ضغط الحروف في مدونات النصوص اللغوية. وقد برهن سينغ وستراوس (Singh and Strouse [5]) أن النماذج اللغوية الطليعية تقسم الأعداد متعددة الخانات من اليسار إلى اليمين إلى وحدات رمزية غير متسقة تتألف من خانة واحدة أو خانتين أو ثلاث خانات، وهو ما يصطدم مباشرةً بقواعد الحساب الموضعي من اليمين إلى اليسار ومنطق ترحيل الخانات العشرية (Carry Logic).
تأمل أثر تقطيع BPE هذا على التسعيرات الحية في سوق الصرف الأجنبي والعملات الرقمية. فعلى الزوج EURUSD، يبتعد السعران 1.0849 والسعر 1.0850 عن بعضهما بمقدار 0.0001 بالضبط (1 pip)، ويمثلان عملياً حالتين سوقيتين متطابقتين. غير أنه تحت التقطيع الرمزي دون الكلمي، تُسقَط السلسلتان "0849" والسلسلة "0850" إلى معرّفين صحيحين منفصلين لا يُشترط لمتجهي تضمينهما الأوليين في الفضاء ℝde أن يقعا أقرب إلى بعضهما من بُعدهما عن متجه السلسلة "1.9850" التي تبعد عنهما مسافة هائلة قدرها 9,000 pips! ونصوغ هذا التمزق الطوبولوجي رياضياً عبر نسبة التشوه المتري المحلي لدالة التقطيع الرمزي:
في المعادلة (2)، يمثل المتغيران x, y ∈ ℝ سعرين حقيقيين في السوق تفصل بينهما أصغر وحدة حركة سعرية ممكنة (تيك واحد δ)، وتحوّل الدالة str(·) القيمة العددية إلى سلسلة محارف عشرية، بينما تسقط الدالة ΦBPE(·) متتالية الشظايا اللفظية الناتجة في فضاء التضمين المدخل المجمَّع. في أي نموذج كمي أملس، تكون النسبة κ(x, y) مقيدةً بثابت ليبشيتز (Lipschitz Constant) منتهٍ بحيث لا تُحدث الإزاحات السعرية الضئيلة سوى اضطرابات طفيفة ومتناسبة في حالة النموذج. أما تحت التقطيع النصي لخوارزمية BPE، فتقفز النسبة κtok(x, y) بجموح عشوائي عند حدود ترحيل الخانات مثل الانتقال من 69,999.99 إلى 70,000.00، بينما تنهار بصورة مصطنعة كلما اشتركت أسعار متباعدة جداً في المقاطع النصية اللاحقة.
تفسر المعادلة (2) سبب إخفاق النماذج اللغوية في أبسط حسابات إدارة المخاطر على الرسوم البيانية الحية. فبالنسبة إلى مقطِّع النصوص دون الكلمي، يبدو الرقمان 67,248 والرقم 57,248 متطابقين تقريباً لأن أربع خانات من أصل خمس تتطابق بينهما نصياً، على الرغم من أن الفارق بينهما يبلغ $10,000 كاملة على مخطط البيتكوين! وفي المقابل، لا يشترك الرقمان 69,999 والرقم 70,001 في أي خانة رقمية واحدة رغم أن المسافة الحقيقية بينهما لا تتجاوز $2 فقط. ولا يمكن لأي محرك لقياس التقلبات أو حساب أوامر وقف الخسارة أن يعمل بموثوقية عندما يبعثر نظام إحداثياته المدخل المسافات العددية على هذا النحو.
ويتفاقم هذا العيب التمثيلي ليتحول إلى انهيار متسلسل في الحسابات متعددة الخطوات. فقد برهن دزيري وآخرون في مؤتمر NeurIPS (Dziri et al. [6]) أن المحولات الانحدارية الذاتية تعالج العمليات الحسابية متعددة المراحل والبرمجة الديناميكية عبر مطابقة أنماط الرسوم الجزئية الخطية السطحية بدلاً من تعلم خوارزميات حسابية قابلة للتعميم، مما يؤدي إلى اضمحلال الدقة أسياً كلما ازداد العمق التركيبي للمسألة. وفي مختبر أبحاث التعلم الآلي بشركة آبل (Apple Machine Learning Research)، قدم ميرزاده وآخرون (Mirzadeh et al. [7]) المعيار الرمزي GSM-Symbolic الذي يستبدل الثوابت الرقمية الجامدة في المسائل الرياضية بمتغيرات عددية رمزية؛ فأثبتوا أن مجرد تغيير الأرقام المحددة داخل المسألة ذاتها يحدث تقلبات حادة في دقة النماذج اللغوية الطليعية، وأن إدراج جملة سياقية واحدة غير ذات صلة يهوي بدقة الاستدلال الرياضي بنسبة تصل إلى 65% [7]. والواقع أن الأسواق المالية تحقن عشرات الجمل الإخبارية الكلية الصاخبة وغير ذات الصلة في كل ساعة تداول.
وأمام مأزق التقطيع النصي للأرقام، يلجأ مروجو التداول على منصات التواصل إلى ادعاء بديل مفاده: «بدلاً من كتابة الأرقام نصياً، ارفع لقطة شاشة لمخطط الشموع اليابانية كي يقرأ نموذج الرؤية واللغة متعدد الوسائط (VLM) الموجات السعرية بصرياً تماماً كما يقرؤها المحلل الفني البشري الخبير!» للوهلة الأولى، يبدو هذا الطرح مقنعاً؛ فعندما ينظر الإنسان إلى رسم بياني للسعر، تلتقط القشرة البصرية فوراً القمم والقيعان المتناوبة وخطوط الاتجاه القطرية. وبالفعل، تحاكي نماذج VLM متعددة الوسائط تلك النظرة البشرية العابرة، فتسمّي الموجات الظاهرية أو المثلثات أو تشكيلات الرأس والكتفين بعبارات إنشائية بليغة.
غير أن رصد الهيئة الشكلية العامة للموجة (Gestalt Wave) يختلف جذرياً عن حساب التوقع الرياضي الشرطي وهندسة المخاطر. فعندما يستقبل نموذج VLM متعدد الوسائط لقطة شاشة لمخطط بأبعاد 1440×900 بكسل، يقوم مشفِّر محول الرؤية (ViT أو SigLIP) بتقطيع الصورة إلى رقع بكسلية خشنة بأبعاد 14×14 أو 16×16 بكسل، ثم يسقط تلك الرقع البصرية عبر محوّل خطي فاقد للمعلومات مباشرةً داخل فضاء تضمين الكلمات الخاص بالنموذج اللغوي. وفي أثناء هذا الإسقاط، تطمس الشبكة أطراف ذيول الشموع الدقيقة دون مستوى البكسل، والنسب المضبوطة لأجسام الشموع بين الافتتاح والإغلاق، واللاخطيات في محور الأسعار الرأسي، ومعايرة التقلب بمتوسط المدى الحقيقي لفترة 14 شمعة (ATRt(14))، محولةً إياها إلى وحدات بصرية دلالية صُممت أصلاً لوصف الصور الفوتوغرافية اليومية لا لقياس النقاط الأساسية على المخططات المالية.
وتحسم الأدلة المعيارية الحديثة مدى فداحة إخفاق نماذج VLM متعددة الوسائط على مخططات الشموع اليابانية. فقد بنى هو وشياو وشو وتانغ وليو (Hu, Xiao, Xu, Tang, and Liu [8]) معياراً متعدد المقاييس لتوقع مخططات الشموع يختبر نماذج VLM الطليعية في مواجهة النماذج الكمية الجدولية المرجعية مثل أشجار القرار المعززة بالتدرج عبر أنظمة متنوعة للأسهم والمؤشرات. وكشف تقييمهم عن أربعة انهيارات بنيوية قاطعة: (1) تُظهر نماذج VLM تحيزاً اتجاهياً غير مشروط حاداً (إذ تميل تلقائياً إلى إصدار توقعات صعودية بصرف النظر عن بنية المخطط)، (2) ينهار معامل المعلومات خارج العينة (IC) لديها مقترباً من الصفر في الأنظمة العرضية أو عالية التقلب، (3) تبدي هذه النماذج انعدام حساسية شبه تام تجاه أفق التوقع المطلوب (خالطةً بين ضجيج 5 شموع وبنية 30 شمعة)، و(4) تتفوق النماذج العددية الجدولية البسيطة العاملة مباشرةً على مصفوفات OHLCV الخام بصورة منهجية ومستمرة على نماذج الرؤية واللغة العامة [8].
ولاحظ التضاد الصارخ بين هذا المسار وبين الرؤية الحاسوبية الكمية المصممة خصيصاً لتسعير الأصول التجريبي. فعندما نشر جيانغ وكيلي وشيو دراستهم المرجعية حول الاتجاهات البصرية للأسعار في مجلة The Journal of Finance [9]، نجحت شبكاتهم الالتفافية تحديداً لأنها تجاوزت اللغة الطبيعية بالكامل: إذ رمّزت مصفوفات البكسل المعيارية إحداثيات الأعلى والأدنى والإغلاق وأشرطة السيولة المطبَّعة بدقة، وأسقطتها مباشرةً إلى احتمالات عوائد مقطعية معايَرة تحت دالة خسارة إحصائية خاضعة للإشراف. أما تمرير الرسم البياني عبر مفكك تشفير لغوي حواري فيدمر تلك الدقة المترية من أساسها. ويقارن الشكل 1 بين خط أنابيب النماذج اللغوية والبصرية التوليدية الفاقد للمعلومات وبين خط أنابيب الذكاء الاصطناعي الكمي متصل الحالة.
A) كيف تحطم النماذج اللغوية الانحدارية الذاتية ونماذج الرؤية واللغة متعددة الوسائط الطوبولوجيا العددية عبر تقطيع BPE دون الكلمي وإسقاط الرقع البصرية الفاقد للمعلومات بأبعاد 14×14، قبل معاينة سرديات تصادفية تنجرف إجاباتها عبر N = 100 استعلام متطابق. في المقابل، يتتبع المسار السفلي (B) كيف تحافظ المحركات الكمية متصلة الحالة على الهندسة المترية المضبوطة وفق معيار IEEE-754، وثبات التحجيم بتقلب ATRt(14)، وتباين تشغيلي يساوي الصفر تماماً عبر التشغيلات (Varrun(ŷt) = 0).3. انعدام الحتمية من استعلام إلى آخر عبر 100 تشغيل والحد الأدنى لغود-تورينغ لحتمية الهلوسة
من المسلمات التأسيسية في هندسة المخاطر المؤسسية مبدأ الحتمية الدالية (Functional Determinism): فعند ثبات تصفية معلومات السوق ℱt لحظة إغلاق الشمعة t، يتوجب على النموذج الرياضي أن يسقط ℱt إلى توزيع احتمالي وحيد قابل للتكرار وحدود مخاطرة وحيدة لا تتبدل بتكرار السؤال. ولو أن حاسوب التوجيه الملاحي لطائرة ركاب حسب مساري هبوط متناقضين عند تغذيته بمتجه القراءات ذاته للارتفاع وقص الرياح مرتين متتاليتين، لما أجاز أي مهندس طيران تحليقه. غير أن النماذج اللغوية الحوارية تنتهك مسلمة قابلية التكرار هذه على مستويين رياضيين متمايزين.
المستوى الأول هو المعاينة التصادفية الصريحة أثناء التوليد الانحداري الذاتي للكلمات. إذ تفك واجهات المحادثة الاستهلاكية وواجهات البرمجة (APIs) تشفير الوحدة الرمزية vk عبر السحب العشوائي من توزيع Softmax مقيس بمعامل درجة الحرارة ومقتطع نووياً (top-p) فوق قيم اللوجيت zk. وبما أن التوليد سببي وانحداري ذاتي، فإن كل وحدة رمزية مسحوبة تُلحق فوراً بسجل التكييف الشرطي v1:k لتوليد الخطوة التالية k + 1.
تتبع بعمق ما يحدث عندما يسأل متداول نموذجاً لغوياً عن النظرة المستقبلية للبيتكوين مرتين عند إغلاق الشمعة ذاته تماماً. لنفترض أنه عند موضع الوحدة الرمزية k = 14، تسند احتمالات اللوجيت القيمة 0.44 للصفة «متماسك» ("resilient") والقيمة 0.41 للصفة «مستنزَف» ("exhausted"). في الاستعلام الأول، تسحب المعاينة العشوائية كلمة «متماسك»، مما يكيّف جميع رؤوس الانتباه اللاحقة لاستدعاء قوالب الاختراق الصعودي واستشراف مستوى $78,000. وفي الاستعلام الثاني، بعد ثلاث ثوانٍ فقط وعلى بيانات السوق المتطابقة حرفياً، تسحب المعاينة كلمة «مستنزَف»، مما يكيّف الوحدات اللاحقة لاستدعاء قوالب قمم التصريف واستشراف هبوط نحو $56,000! وعبر N = 100 استعلام متطابق، تتشعب المسارات النصية إلى سحابة متعددة القمم من السرديات المتضاربة، تشمل تشغيلات متطرفة في ذيل التوزيع تتجول فيها المعاينة المتتالية داخل فروع منخفضة الاحتمال وتختلق تاريخاً سعرياً وهمياً لا أصل له.
ويزعم اعتراض هندسي شائع أن ضبط درجة حرارة فك التشفير على الصفر (τ → 0+، أي الاختيار الجشع argmax) يقضي على هذا التذبذب كلياً. غير أن أبحاث هندسة الأنظمة التجريبية تثبت أنه حتى إعداد temperature = 0 يعجز عن ضمان الاستدلال الحتمي فوق عناقيد معالجات الرسوميات (GPUs) الحديثة. فقد قيّم أتيل وآخرون (Atil et al. [4]) النماذج اللغوية الطليعية عبر تشغيلات متكررة متطابقة عند temperature = 0 وبذور عشوائية مثبتة، معرِّفين معدل الاتفاق الكلي عبر N تشغيلاً على مستوى السلسلة النصية الخام (TARr@N) وعلى مستوى الإجابة المستخلصة (TARa@N). ووثق الباحثون تقلبات في الدقة تتراوح بين 10% إلى 15% عبر التشغيلات الجشعة المتطابقة، مع تسجيل أشد مستويات الانجراف في مهام الرياضيات والاستدلال متعدد الخطوات تحديداً [4].
ويعود السبب الفيزيائي لانجراف المخرجات عند temperature = 0 إلى عدم تجميعية عمليات جمع الفاصلة العائمة وفق معيار IEEE-754 داخل أشجار الاختزال المتوازية في معالجات GPU، مقترناً بتضخيم الخطأ عبر الحلقات الانحدارية الذاتية:
في المعادلة (3)، يرمز المؤثر ⊕BF16 إلى عملية الجمع العشري بصيغة Brain Floating-Point ذات 16 بت (والتي لا تمتلك سوى 7 بتات لدقة الجزء الكسري Mantissa) والمنفَّذة داخل خوادم التجميع المستمر الديناميكية للطلبات (مثل محركات vLLM أو موجّهات مزيج الخبراء Mixture-of-Experts). واعتماداً على عدد طلبات المستخدمين المتزامنة التي تتقاسم دفعة الملي ثانية الواحدة على معالج GPU، تجمع خيوط CUDA المتوازية حواصل ضرب المصفوفات والمتجهات بترتيب شجري مختلف، مما يزيح قيم اللوجيت بمقدار 10-4..10-3. وكلما تقاربت قيمتا اللوجيت لوحدتين رمزيتين ماليتين متنافستين (وهو ما يحدث باستمرار في أنظمة السوق الصاخبة المتوازنة بنسبة 50/50!)، تقلب تلك الإزاحة المجهرية في الفاصلة العائمة نتيجة الاختيار الجشع argmax عند كلمة مبكرة واحدة، لتتدحرج بعدها فقرة تحليلية مختلفة تماماً [4].
تكشف المعادلة (3) خللاً قاتلاً أمام تخصيص رأس المال المؤسسي أو الفردي: فحتى لو أغلقت واجهة برمجة النموذج اللغوي على temperature = 0، فإن إجابتك التداولية تظل رهينةً بعدد الغرباء الذين يصادف أنهم يدردشون مع عنقود معالجات السحابة ذاته في تلك الملي ثانية تحديداً! وفي أنظمة السوق المتقلبة حيث تتقارب الاحتمالات النصية للسرديتين الصعودية والهبوطية، تكفي فروق التقريب المجهري في المعالج لقلب مفردة استهلالية واحدة وإعادة كتابة أطروحة الصفقة بالكامل.
ووراء انعدام الاستقرار من تشغيل إلى آخر ينتصب حاجز نظري أعمق بكثير: الحتمية الرياضية للهلوسة (Mathematical Inevitability of Hallucination). يفترض كثير من الممارسين أن الهلوسات مجرد عيوب هندسية عابرة ستعالجها مجموعات التدريب الأكبر حجماً مع مرور الوقت. غير أنه في الندوة السنوية السادسة والخمسين لجمعية آلات الحوسبة حول نظرية الحوسبة (ACM STOC 2024)، أثبت كالاي وفيمبالا (Kalai and Vempala [2]) النقيض التام؛ إذ اشتقا حداً إحصائياً أدنى صارماً يبرهن أن أي نموذج لغوي توليدي معايَر إحصائياً محكوم عليه حتماً بالهلوسة بمعدل يحده من الأدنى كتلة الحالات المفردة لغود-تورينغ للحقائق التي لا يمكن استنتاج صحتها حتمياً من القواعد اللغوية وحدها:
إن تفكيك كل حد في المعادلة (4) يكشف بوضوح لماذا تمثل الأسواق المالية البيئة الأسوأ على الإطلاق للهلوسة التوليدية. ترمز المجموعة ℋfalse هنا إلى مجموعة العبارات المستساغة ظاهرياً ولكن الزائفة واقعياً، ويمثل الكسر n1 / n مقدِّر غود-تورينغ لكتلة التوزيع غير المرئية (أي نسبة تحققات الحالة التي ظهرت مرةً واحدةً فقط عبر n من أمثلة التدريب)، ويقيس الحد κcal(πθ) اختلال المعايرة الإحصائية أثناء التدريب المسبق، بينما يمثل الكسر |𝒱ded| / |𝒱arb| نسبة الحقائق القابلة للاستنباط المنطقي الصارم إلى التحققات التصادفية المفتوحة. وبالتوازي مع ذلك، أثبت شو وجين وكانكانهالي (Xu, Jain, and Kankanhalli [3]) عبر نظرية قابلية الحوسبة وحدود التعلم لغولد أنه يستحيل على أي نموذج لغوي قابل للحوسبة أن يلغي الهلوسة عبر فضاءات حالات العالم المفتوحة.
لماذا تضرب المعادلة (4) التوقع المالي في مقتل؟ لأن كل حالة يومية للسوق متعدد الأصول (بما تضمه من أسعار عابرة للأصول، وعمق فوري لدفتر الأوامر، وفروق عوائد السندات، ومفاجآت الاقتصاد الكلي) هي تحقق متصل فريد لم يقع في التاريخ سوى مرة واحدة على الأكثر (n1 / n → 1 في فضاء الحالة المتصل!). وعندما يُرغَم نموذج نصي توليدي على مواصلة كتابة جمل واثقة حول حالات متصلة غير مسبوقة دون الامتناع عن الفتوى، فإنه يكون مضطراً بحكم الضرورة الرياضية إلى اختلاق مزاعم رقمية مستساغة اللفظ باطلة المضمون.
أجرِ تحققاً عددياً مباشراً على المعادلة (4): لنفترض أن متداولاً يرسل N = 100 استعلام إلى نموذج لغوي حواري طالباً إحداثيات لحظية دقيقة للدعم والمقاومة ووقف الخسارة عبر أنظمة تقلب غير مألوفة يحقق فيها معدل الحالات المفردة المتباينة n1 / n ≥ 0.22 ويبلغ هامش تراخي المعايرة 0.04. حتى في ظل تدريب مسبق مثالي، ستتضمن ما لا يقل عن 15 إلى 18 استجابة من أصل 100 توقع مولَّد مزاعم رقمية مختلقة بالكامل (مثل الاستشهاد بمتوسط متحرك أو مستوى تصحيح فيبوناتشي يبتعد مئات النقاط عن موقع السعر الفعلي على الشريط). وفي التداول ذي الرافعة المالية، تكفي إحداثيتان أو ثلاث إحداثيات مهلوسة فقط لوقف الخسارة من أصل مئة صفقة لإلحاق تراجع قاسٍ برصيد الحساب.
4. السفسطة الإقناعية في تدريب RLHF، وتوجيه المطالبات على منصات التواصل، وتلوث استباق المستقبل في التدريب المسبق
يطرح هذا التسلسل البنيوي سؤالاً محورياً: إذا كانت النماذج اللغوية التوليدية تفشل في التقطيع الرمزي للأعداد، وتنجرف عبر التشغيلات المتكررة، وتهلوس بمعدلات محكومة بحدود دنيا رياضية، فلماذا انتشرت كالنار في الهشيم عبر قنوات التداول الفردي؟ تكمن الإجابة في آليات المواءمة السلوكية بعد التدريب (Post-Training Alignment). إذ تخضع النماذج الحوارية الحديثة للتعلم المعزز من التغذية الراجعة البشرية (RLHF) أو تحسين التفضيل المباشر (DPO)، حيث تُضبط المعاملات θ لتعظيم نموذج مكافأة التفضيل البشري rφhuman(x, y) مع تقييده بحد عقوبة تباعد كولباك-لايبلر إزاء السياسة المرجعية πref:
تفحّص بدقة ما الذي يقيسه نموذج المكافأة rφhuman(x, y) فعلياً في المعادلة (5). إن المقيِّمين البشريين الذين يفاضلون بين أزواج استجابات الذكاء الاصطناعي أثناء مرحلة ما بعد التدريب لا ينتظرون ثلاثين يوم تداول ليتحققوا مما إذا كان المسار المقترح لعملة BTCUSD أو الزوج EURUSD قد حقق أدنى درجة براير خارج العينة! بل يمنح المقيِّمون درجاتهم في غضون ثوانٍ معدودات استناداً إلى تنسيق الفقرات، ونبرة الثقة الحاسمة، وغياب التردد اللغوي، وموافقة الإجابة للمقدمة الضمنية الكامنة في مطالبة المستخدم.
وتوثق دراستان محكمتان في مؤتمر ICLR الآثار الجانبية الخطيرة للمعادلة (5). أولاً، برهن شارما وآخرون في مؤسسة أنثروبيك (Sharma et al., ICLR 2024 [12]) أن نماذج مكافأة RLHF تحفز بصورة منهجية سلوك المجاراة التملقية (Sycophancy): أي تفصيل الاستنتاجات التحليلية لتصادق على أي انحياز اتجاهي مضمَّن في سؤال المستخدم بدلاً من الدفاع عن الحقيقة الموضوعية. فإذا سأل متداول: «اشرح لماذا يبدو الذهب مهيأً لاختراق مستوى 4,200 صعوداً»، بنى النموذج بطواعية حجة مؤسسية صعودية متماسكة؛ وإذا عاد المتداول ذاته بعد دقيقتين وسأل: «اشرح لماذا يشكّل الذهب قمة تصريفية للانهيار دون مستوى 3,600»، صاغ النموذج ذاته أطروحة هبوطية لا تقل بلاغةً وإقناعاً عن سابقتها.
ثانياً، أثبت وين وآخرون (ICLR 2025 [13]) أن تدريب RLHF يدرّب النماذج اللغوية فعلياً على السفسطة غير المقصودة (U-Sophistry): إذ تصبح النماذج أقدر بصورة قابلة للقياس على إقناع المقيِّمين البشريين المقيدين بالوقت بأن الاستدلال الخاطئ هو استدلال سليم، مما يضخم ثقة الإيجابيات الكاذبة لدى البشر حتى عندما تساوي الدقة الفعلية للمهمة صفراً! ومما يضاعف فخ الإقناع هذا، قيّم شيونغ وآخرون (ICLR 2024 [14]) استخلاص الاحتمالات المنطوقة لفظياً عبر النماذج اللغوية الطليعية، فكشفوا عن ثقة مفرطة مزمنة: إذ تصرح النماذج بانتظام بعبارات من قبيل «ثقة تتراوح بين 80% إلى 85%» في مهام لا تتجاوز دقتها التجريبية المحققة نسبة 50% المماثلة لرمي قطعة نقد.
تفسر المعادلة (5) الحلقة الفيروسية على منصات التواصل الاجتماعي تفسيراً كاملاً. يكتب المؤثر على إنستغرام أو يوتيوب أو تيك توك مطالبة منمقة يأمر فيها النموذج اللغوي بالتحدث بلسان محلل كمي في صندوق تحوط؛ فيعمل تحسين RLHF على تعظيم الإقناع البشري الظاهري rφhuman، مفرزاً نقاطاً مرتبة مبهرة تدفع المتابعين الأفراد إلى المجازفة بأموال حقيقية استناداً إلى نثر أدبي يفتقر إلى أي أساس رياضي معايَر.
وماذا عن المدونات المنشورة أو المسودات البحثية الأولية التي تدعي أن نموذج ChatGPT أو نموذج GPT-4 قد تفوق على مؤشرات السوق المرجعية في الاختبارات التاريخية الخلفية بين عامي 2018 و2023؟ تفنّد دراستان تجريبيتان صارمتان تلك المزاعم بالكامل. أولاً، اختبر شيه وهان ولاي وبنغ وهوانغ (Xie, Han, Lai, Peng, and Huang [10]) أداء نموذج ChatGPT الصفري (Zero-Shot، بما في ذلك مطالبات سلسلة الأفكار Chain-of-Thought والنصوص الاجتماعية متعددة الوسائط) على معايير حركة الأسهم في دراستهم الشهيرة «مبتدئ وول ستريت» (The Wall Street Neophyte)، فوجدوا أن نموذج ChatGPT تخلف في الأداء ليس عن البنى العصبية الكمية المتخصصة فحسب، بل حتى عن النماذج الخطية والانحدارية الذاتية العددية الأولية.
ثانياً، برهن سركار وفافا في جامعتي شيكاغو وهارفارد (Sarkar and Vafa [11]) أن العائد الاستثنائي التاريخي الظاهري (Alpha) في النماذج اللغوية المدرَّبة مسبقاً ملوث بشدة بظاهرة تحيز استباق المستقبل في التدريب المسبق (Pretraining Look-Ahead Bias). فلأن النماذج التأسيسية دُرِّبت مسبقاً على مسوحات شاملة للإنترنت تمتد حتى تاريخ القطع المعرفي للنموذج، فإن مليارات الأوزان داخلها تحفظ ضمنياً نتائج أرباح الشركات، وانهيارات الجائحة، وقفزات التضخم، وموجات صعود العملات الرقمية التي وقعت بعد التاريخ المفترض داخل نص المطالبة التاريخية. وإن أمر النموذج في المطالبة بـ«تجاهل المعرفة المستقبلية» يعجز تماماً عن محو الارتباطات المعلمية المحفوظة داخل الأوزان [11]. وبمجرد أن تتجاوز الساعة تاريخ القطع المعرفي للنموذج نحو الشموع الحية غير المرئية فعلياً، يتبخر ذلك العائد التاريخي الوهمي في الحال. ويلخص الجدول 1 هذه الأبعاد البنيوية السبعة عبر النماذج المعمارية الأربعة.
| بُعد التقييم العلمي والهندسي | النموذج اللغوي النصي الحواري (ChatGPT / Claude / DeepSeek) |
نموذج الرؤية واللغة العام (VLM) على لقطات الشاشة |
سلاسل زمنية مغلفة بنموذج لغوي (Time-LLM / GPT4TS) |
منظومة 4CastMachine AI (Quad-AI المفصولة حسب الميدان) |
|---|---|---|---|---|
| التمثيل الأصيل للمدخلات | سلاسل رمزية متقطعة بتقطيع BPE؛ يحطم المسافة الإقليدية للأعداد [5] |
رقع صورية بأبعاد 14×14 مسقطة بفقد للمعلومات إلى رموز لفظية [8] |
رقع رقمية مسقطة داخل تضمينات لغوية مجمدة [1] | موتّرات OHLCV مضبوطة بمعيار IEEE-754 + مشفِّر نصوص معزول |
| هدف دالة خسارة التدريب | الإنتروبيا المتقاطعة اللفظية + مكافأة التفضيل البشري RLHF [12, 13] |
خسارة تباينية / إنتروبيا متقاطعة لمطابقة الصورة بالتعليق النصي | إعادة بناء الرقع العددية عبر تمريرها قسراً بطبقات اللغة | قواعد تقييم متصلة سليمة (CRPS، وبراير) + هندسة المخاطر البنيوية |
| قابلية التكرار عبر 100 تشغيل | يفشل: يتشعب تحت المعاينة وينجرف بنسبة 10-15% حتى عند τ=0 [4] |
يفشل: حساس للقص والتكبير ومظهر الألوان وصياغة المطالبة [8] | حتمي فقط عند تعطيل المعاينة؛ مع هدر حوسبي قدره 100x [1] |
حتمي بنسبة 100%: Varrun(ŷt) = 0 على التصفية المتطابقة ℱt |
| القابلية للهلوسة العددية | محكوم من الأدنى بمعدل الحالات المفردة لغود-تورينغ [2, 3] | يختلق خطوط اتجاه ويخطئ قراءة إحداثيات المحاور في الرسوم الكثيفة | أوزان LLM المدرَّبة مسبقاً لا تضيف أي دقة فوق الانتباه المجرد [1] |
جدار ناري دلالي: معالجة اللغة لا تُخرج إحداثيات سعرية أبداً |
| مخاطر المجاراة التملقية للمطالبة | مرتفعة: يقلب الاتجاه صعوداً أو هبوطاً لمجاراة صياغة السائل [12, 13] | مرتفعة: تحيز صعودي غير مشروط قوي وانعدام حساسية للأفق [8] | منخفضة، لكنه عرضة لتسرب القطع المعرفي للتدريب المسبق | صفر: حساب رياضي غير حواري لحالة السوق مستقل عن المستخدم |
| سلامة التدقيق التاريخي | ملوث بتسرب استباق المستقبل من مدونات التدريب المسبق [11] | ملوث إذا وقعت تواريخ الرسم أو علاماته داخل فترة القطع المعرفي | يتطلب عزلاً أمامياً متدحرجاً صارماً وتكلفة حوسبة باهظة | أرشيف أمامي سببي صارم قابل للتدقيق (مدقق بانتظام منذ عام 2015) |
| مخرجات المخاطر القابلة للتنفيذ | نثر سردي غير قابل للدحض مشوب بثقة لفظية مفرطة [14] | تسميات موجية كيفية مجردة من حدود إلغاء معايَرة | قيمة نقطية أو تجزيئية مفردة تفتقر إلى خريطة نظام السوق | تحديد صريح لمنطقة Buy/Sell Zone، وحد Pivot، وأهداف TP1-TP5، ونموذج DTO |
5. أين تنتمي النماذج اللغوية حقاً؟ الجدار الناري الدلالي داخل محرك Sentiment AI في مقابل المحركات الكمية
إن إثبات فشل النماذج اللغوية التوليدية في الحسابات السعرية الكمية لا يعني إطلاقاً أن محولات اللغة الطبيعية لا مكان لها داخل منظومة الهندسة المالية الحديثة. فاستخدام نموذج لغوي لحساب احتمالات الشموع اليابانية أو حل هندسة مناطق الدعم متعددة الأطر الزمنية يشبه استخدام ميكروفون صوتي فائق الحساسية كرافعة هيدروليكية: لا ينبع الفشل من رداءة الأداة في ذاتها، بل من إقحام أداة متخصصة في ميدان فيزيائي خاطئ تماماً. وعندما تُحصَر مشفِّرات المحولات المكيَّفة للمجال حصرياً في معالجة اللغة البشرية غير المهيكلة، فإنها تنجز مهمةً تعجز مرشحات السلاسل الزمنية العددية الصرفة عن إنجازها بمفردها.
ففي كل يوم تداول، يصدر محافظو البنوك المركزية بيانات السياسة النقدية، وتنشر الهيئات الإحصائية مراجعات التضخم والتوظيف، وتبث وكالات الأنباء الجيوسياسية اضطرابات مفاجئة غير مجدولة في سلاسل الإمداد، وتفسر آلاف المقالات المالية التحولات الاقتصادية الكلية. وقبل أن تستكمل تلك الأحداث تصفيتها عبر دفاتر الأوامر المحددة، يوجد محتواها الدلالي في صورة نصوص بشرية غير مهيكلة Dt فحسب. وهنا تتفوق النماذج اللغوية المالية المعايَرة للمجال (استناداً إلى نتائج المعجم المالي للوغران وماكدونالد Loughran and McDonald [17] وتضمينات FinBERT السياقية لدى أراتشي Araci [18]) في قراءة آلاف العناوين في الدقيقة الواحدة، وحسم تراكيب النفي ودقائق لهجة البنوك المركزية، وقياس ما إذا كان النص الوارد يحمل ضغطاً كلياً إيجابياً أم سلبياً.
وداخل منظومة 4CastMachine AI، نوظف هذه القدرة اللغوية تحديداً داخل المحرك الثاني (Sentiment AI) مع فرض حد معماري صارم لا يقبل المساومة نطلق عليه اسم الجدار الناري الدلالي (Semantic Firewall). ففي محرك Sentiment AI، لا يُسأل النموذج اللغوي قط عن السعر الذي سيتداول عنده البيتكوين أو الذهب غداً، ولا يُسمح له أبداً برسم منطقة دعم، ولا يُتاح له مخاطبة المتداول بسرديات قصصية إقناعية. وبدلاً من ذلك، يعمل محرك Sentiment AI حصراً بوصفه مستشعراً دلالياً مقيد النطاق يسقط تدفقات النصوص غير المهيكلة Dt وأرشيف أحداث الاقتصاد الكلي التاريخية ℋhist في متجه خصائص عددي منخفض الأبعاد ومعايَر إحصائياً:
تتبع كل مركّبة من مركّبات المعادلة (6) خطوةً بخطوة لترى كيف يلتزم كل محرك داخل بنية Quad-AI بميدانه الصالح رياضياً دون أدنى تجاوز:
- المحرك 2 · Sentiment AI (ℰSentiment، للإجابة عن سؤال «لماذا يتحرك السوق؟ / The Why»): يقرأ تدفقات وكالات الأنباء الحية متعددة المصادر Dt باستخدام النمذجة اللغوية السياقية لاستخلاص القطبية الاتجاهية المقيدة pt ∈ [-1, +1]، والمفاجأة المعيارية للمفكرة الاقتصادية ze,t، والتشابه الدلالي لجيب التمام simcos(𝐞(Dt), 𝐞(ℋhist)) مع الوقائع الكلية التاريخية المماثلة ذات الأثر المحقق المعروف على التقلبات، وكثافة وصول الأخبار وفق عملية هوكس λt. ويقتصر مخرجه حصراً على متجه عددي مهيكل 𝐳tnews، ولا ينتج هدفاً سعرياً أبداً.
- المحرك 1 · Forecast AI (𝒬Fcst، للإجابة عن سؤال «ماذا تقول البنية السعرية؟ / The What»): يعمل حصرياً على موتّرات الأسعار وأحجام التداول المتصلة بدقة
IEEE-754𝐗t-L:t عبر الأطر الزمنية التسعة (1mإلىM)، حاسباً بنية السوق متعددة الأطر الزمنية، والنسب الموجية التوافقية والهندسية، ومناطق العرض والطلب، واحتمالات الشموع المعايَرة في نموذج الفرص التداولية اليومية (DTO) دون أن يلمس وحدة رمزية لفظية واحدة. - المحرك 3 · Synergy AI (𝒢Syn، للإجابة عن سؤال «كيف تتوازن القوى؟ / The How»): يحكم بصورة متصلة بين محرك
Forecast AIومحركSentiment AIعبر بواباتSoftmaxالمشروطة بنظام السوق (كما فصلنا رياضياً في ورقة الموازنة النظامية لمحرك Synergy AI)، كابحاً الضجيج الإعلامي خلال ساعات الانتشار الهادئة، ورافعاً وزن المتجه الإخباري 𝐳tnews أثناء صدمات القفز ذات المفاجآت الكلية العالية. - المحرك 4 · Navigator AI (𝒩Nav، للإجابة عن سؤال «ماذا تفعل على المخطط؟ / What to Do»): يحل مسألة تحسين توجيهي حتمي فوق سطح الاحتمالات المتوائم ليرسم خريطة طريق واحدة قابلة للدحض على المخطط البياني ℛt: منطقة شراء
Buy zoneأو منطقة بيعSell zoneصريحة، وحد إلغاء بنيوي قاطع (Pivot)، وسلم أهداف ربحية متدرجProfit zone(TP1إلىTP5)، ومنطقة انعكاس مشروطةReverse zone، وأسهم اتجاهية خضراءGreen Arrows.
عد مجدداً إلى تشبيه صحفي الجريدة اليومية. في المعادلة (6)، نعيّن ذلك الصحفي سريع القراءة (Sentiment AI) حصرياً لقراءة البرقيات العاجلة في خمسين مللي ثانية، وتقييم ما إذا كانت نبرة البيان متشددة أم تيسيرية، واسترجاع العناوين التاريخية المناظرة من الأرشيف. لكننا لا نسمح للصحفي بلمس المعادلات التفاضلية قط! إذ تُحَل جميع حسابات مسار السعر، وأوزان النظام السوقي، وهندسة وقف الخسارة في المراحل اللاحقة بواسطة محركات كمية متخصصة (Forecast AI، ومحرك Synergy AI، ومحرك Navigator AI).
ويمتد هذا التقسيم الصارم للأدوار عبر منظومة ForecastCity المكونة من تسعة أنظمة ذكاء اصطناعي بأكملها. فواجهات الشرح والمساندة اللغوية مثل مساعد AI Trading Assistant تساعد المستخدمين على التنقل بين أدوات مساحة العمل أو ترجمة قواعد الاستراتيجية المكتوبة بلغة واضحة، في حين تنفذ أداة AI Strategy Studio، والحسابات الافتراضية Virtual Accounts، وجسر المزامنة ForecastFollow، وسجل التدقيق AI Trading Journal، ومنظومة 4CastMachine AI حسابات كمية حتمية بنسبة 100% على الشموع التاريخية والحية. ويلخص الجدول 2 المهام التي تنتمي إلى الذكاء الاصطناعي اللغوي في مقابل الذكاء الاصطناعي الكمي متصل الحالة.
| مهمة النظام المالي | الطبيعة الرياضية للوسيط | النموذج الصحيح للذكاء الاصطناعي | عاقبة الإقحام الخاطئ لنموذج لغوي توليدي (LLM) |
|---|---|---|---|
| تحليل بيانات البنوك المركزية وعناوين الاقتصاد الكلي | لغة طبيعية متقطعة غير مهيكلة Dt ∈ 𝒱* | معالجة لغة مالية مكيَّفة للمجال / مشفِّر لغوي (Sentiment AI) |
ميدان صالح تماماً متى قُيِّد المخرج بقيم سلمية معايَرة للقطبية وتشابه الأحداث |
| مناطق الدعم والمقاومة متعددة الأطر والنسب التوافقية واحتمالات الشموع | موتّر أعداد حقيقية متصل 𝐗t-L:t ∈ ℝL×d | مقدِّرات فضاء الحالة المتصل والمدى السعري (Forecast AI) |
تشوه متري بتقطيع BPE، وانهيار دقة بنسبة 65% مع الجمل العارضة [7]، وأرقام دعم ومقاومة مختلقة |
| التحكيم بين البنية الفنية وسرعة تدفق الأخبار العاجلة | فضاء مشترك للانتشار والقفز وكثافة هوكس | مزيج خبراء متصل ببوابة Softmax (Synergy AI) |
تبديل سردي اعتباطي؛ وانحياز حداثة نحو العنوان الإخباري الأخير في نص المطالبة |
| تحديد مناطق الدخول وحد الإلغاء Pivot وسلم الأهداف TP1-TP5 | تحسين مخاطرة مقيد بأزمنة التوقف | تحسين توجيهي لإحداثيات الرسم البياني (Navigator AI) |
نثر إنشائي غير قابل للدحض، وغياب حدود الإلغاء البنيوية، واستنزاف تراجعي غير متماثل |
6. الأدلة الحية على الرسم البياني: خرائط طريق Quad-AI الحتمية على البيتكوين BTCUSD (الإطار D) والذهب XAUUSD (الإطار 4h) في مواجهة انجراف السرديات التوليدية
لجعل التباين بين الإنشاء النصي الحواري للنماذج اللغوية وبين التوقع الكمي الحتمي ملموساً بالكامل، نفحص رسمين بيانيين إنتاجيين حيين ملتقطين من منصة 4CM-AI Charts عبر فئتي أصول مختلفتين وأفقين زمنيين متمايزين: البيتكوين (BTCUSD) على الإطار الزمني اليومي (D)، والذهب (XAUUSD) على الإطار الزمني لأربع ساعات (4h).
تأمل أولاً ما يجري عندما يسأل متداول أو مقدم محتوى على منصات التواصل نموذجاً لغوياً عاماً (أو يرفع صورة خام للشموع) طالباً نظرة مستقبلية للبيتكوين بينما يتداول الزوج BTCUSD بالقرب من السعر الفوري 64,570.00 عقب تراجعه التصحيحي من قمة الخريف القريبة من 87,000. عبر الاستعلامات المتكررة، تنشطر النماذج الحوارية إلى قصص متنافية تماماً: فيتوقف تشغيل أول عند الشموع الحمراء الحادة لشهر نوفمبر محذراً من انهيار وشيك صوب $50,000؛ ويردد تشغيل ثانٍ سرديات التبني المؤسسي الكلي للبيتكوين داعياً إلى صعود فوري حاد على شكل حرف V نحو $90,000؛ بينما يختلق تشغيل ثالث أرقام تصحيح فيبوناتشي تقريبية لا تطابق القمة والقاع الفعليين للموجة على شريط الأسعار. ولا تحدد أي فقرة من تلك الفقرات حداً سعرياً مضبوطاً للإلغاء، كما لا توفق بين سبب تعارض الأطر الزمنية اللحظية مع الاتجاه اليومي العام.
والآن افحص الشكل 3، الذي يعرض خريطة الطريق الحتمية لمنظومة 4CastMachine AI على رمز BTCUSD (الإطار D) والمحسوبة مباشرةً من إحداثيات OHLCV المتصلة والمتوائمة رياضياً عبر الأطر الزمنية.
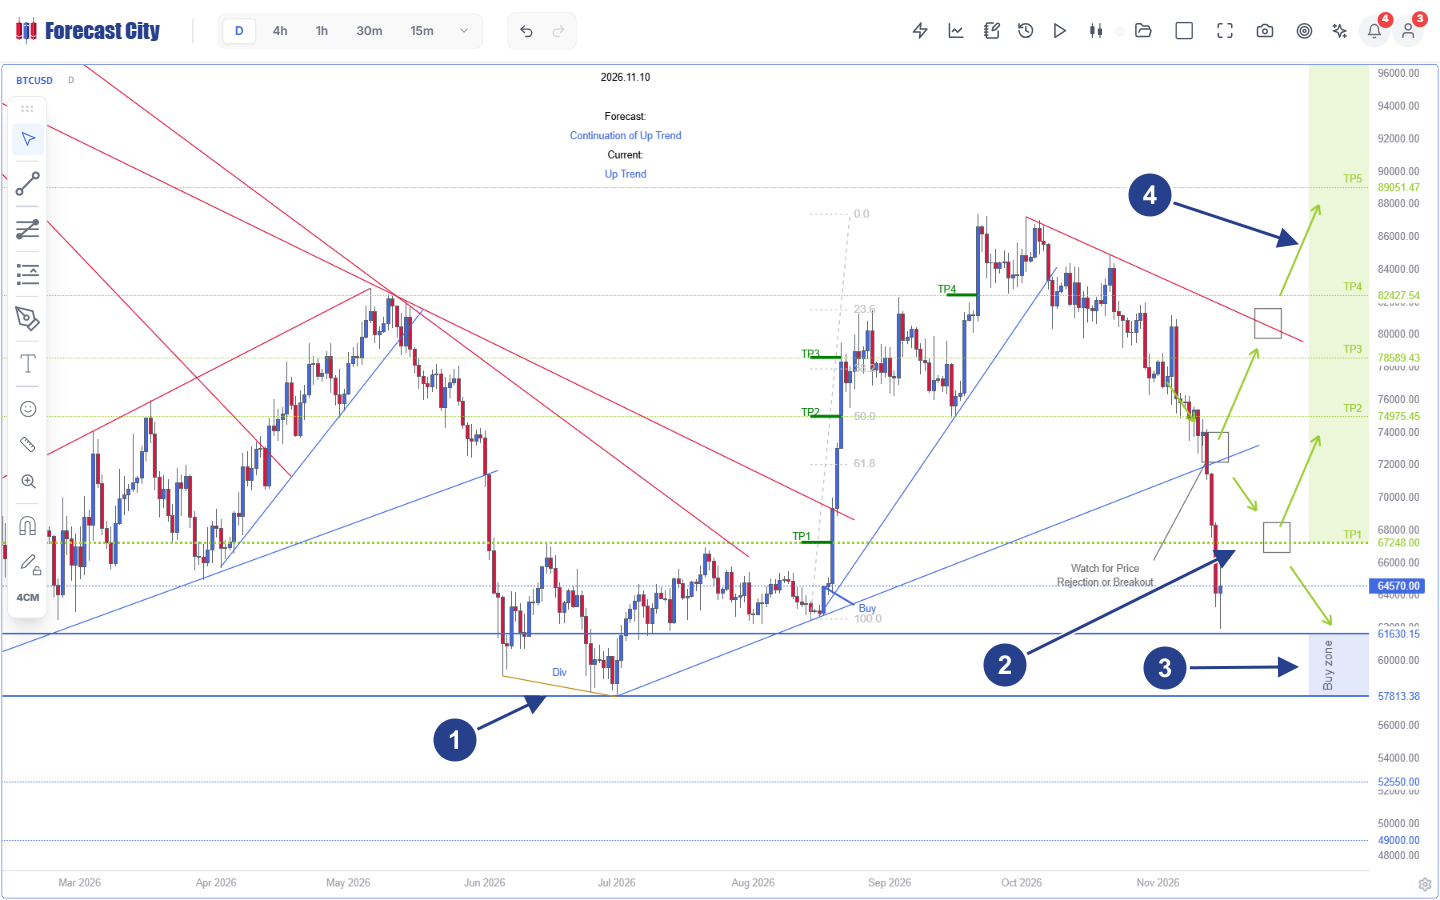
BTCUSD، الإطار اليومي D، السعر الفوري 64,570.00): على النقيض من التوليد النصي التصادفي الذي ينجرف من استعلام إلى آخر، تسقط بنية Quad-AI هندسة إحداثيات مضبوطة وقابلة للتكرار التام مرتكزةً على القمم والقيعان التاريخية المدققة وعقد القرار المشروطة الصريحة.
- 1القاعدة البنيوية المدققة (
Divوموجة فيبوناتشي100.0-0.0): دايفرجنس صعودي في شهري يونيو ويوليو عند القاع57,813.38أعقبه إعداد شراءBuyفي شهر أغسطس حقق تتابعياً الأهداف التاريخيةTP1، والهدفTP2، والهدفTP3، والهدفTP4. - 2عقد القرار المشروطة: ثلاث نقاط تفرع صريحة موسومة بعبارة
Watch for Price Rejection or Breakoutعلى امتداد خط الدعم الأزرق الصاعد المكسور وخط المقاومة الأحمر الهابط، تستبدل النثر المبهم بشروط هندسية قابلة للاختبار. - 3منطقة الشراء المقيسة كمياً
Buy zone(57,813.38-61,630.15): نطاق طلب مؤسسي محدد بدقة أسفل السعر الفوري64,570.00، مدعوم بأرضيات بنيوية أدنى عند المستويين52,550.00والمستوى49,000.00. - 4سلم منطقة جني الأرباح المتدرج
Profit zone(TP1-TP5): أهداف صعودية قابلة للتكرار عند المستوياتTP1 = 67,248.00، والمستوىTP2 = 74,975.45، والمستوىTP3 = 78,589.43، والمستوىTP4 = 82,427.54، والمستوىTP5 = 89,051.47.
تأمل عن كثب التماسك متعدد الأطر الزمنية الكامن خلف الشكل 3. فعند السعر الفوري 64,570.00، تنشط التراجعات التصحيحية قصيرة الأجل على الآفاق الزمنية الأدنى (إذ يظل الإطار 30m هبوطياً دون مستوى 66,422.24، والإطار 1h هبوطياً دون مستوى 67,566.58، والإطار 4h هبوطياً دون مستوى 72,769.47)، في حين تظل البنية الكلية الأسبوعية صعودية فوق مستوى 48,879.14، ويتأكد الاستمرار اليومي صعودياً بحسم فوق مستوى 67,248.00 (TP1). وبدلاً من التخمين العشوائي حول ما إذا كانت شمعة التراجع الحمراء ستتوقف عند 64,570.00 أم ستهبط أولاً لاختبار السيولة الأدنى، يرسم محرك Navigator AI كلا الفرعين الشرطيين بصراحة تامة: فإما أن يختبر السعر نطاق الطلب في منطقة Buy zone الممتدة من 57,813.38 إلى 61,630.15 ويسجل رفضاً سعرياً صاعداً، وإما أن يستعيد عقدة القرار عند 67,248.00 لاستئناف المسار الصاعد الرئيسي صوب المستويين 74,975.45 (TP2) والمستوى 89,051.47 (TP5).
وتزداد الفجوة وضوحاً بين التخمين البصري الشكلي وبين حسابات الإحداثيات المتصلة عند النزول إلى الأطر الزمنية اللحظية مثل الإطار 4h، حيث تتطلب خطوط الاتجاه المتقاطعة، وانقلابات القطبية السعرية، وعتبات الإلغاء الضيقة دقةً محسوبةً بالسنت الواحد. ويعرض الشكل 4 خريطة طريق الذهب (XAUUSD) على الإطار الزمني 4h عند السعر الفوري 3,879.59.
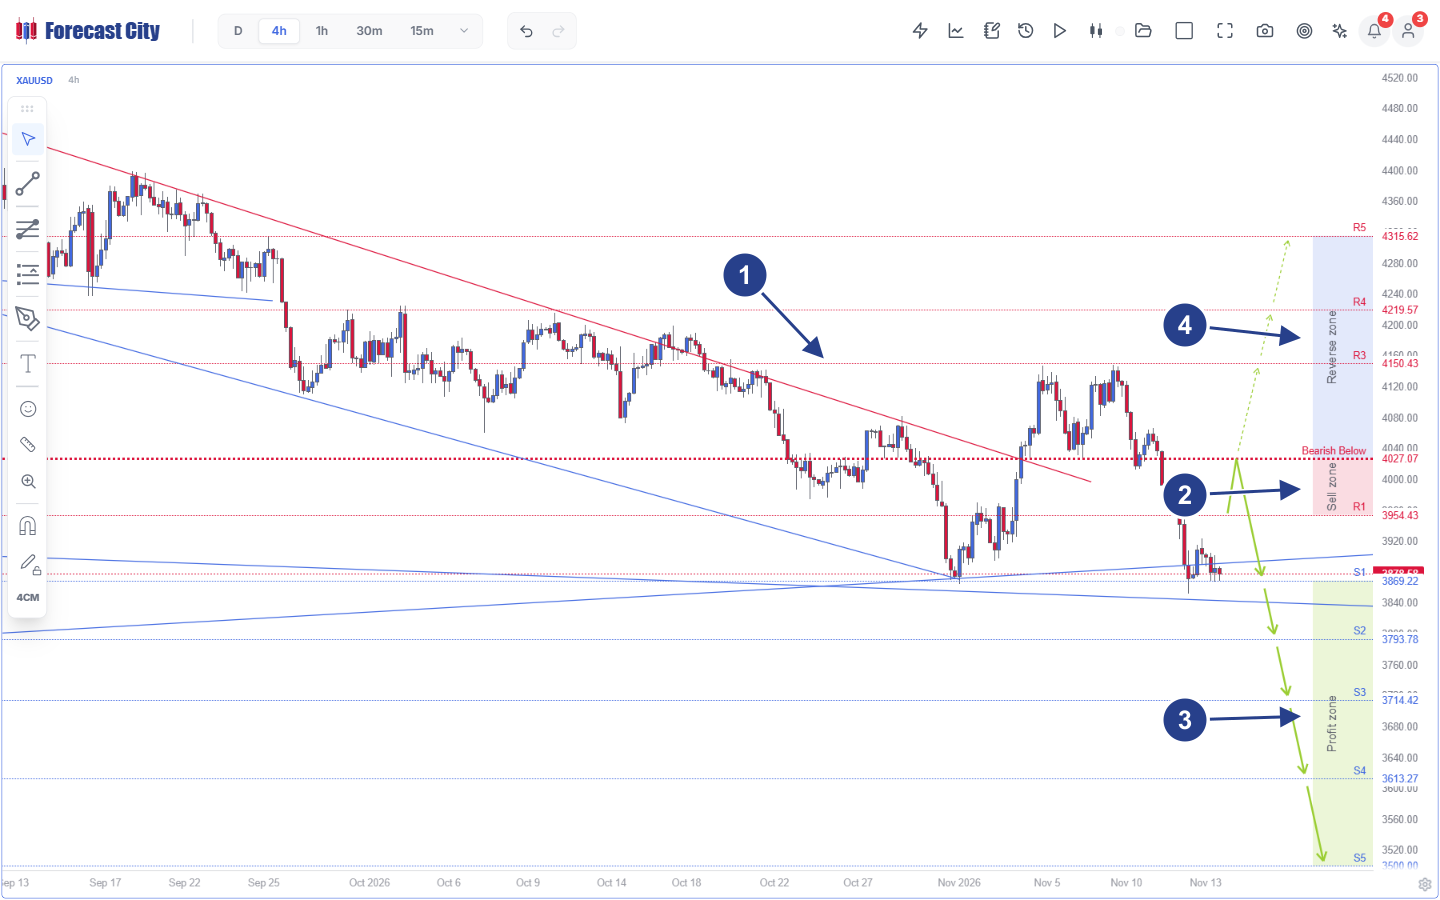
XAUUSD، الإطار الزمني 4h، السعر الفوري 3,879.59): حيث تطمس مشفِّرات الرقع البكسلية في نماذج VLM رفض ذيول الشموع الدقيقة وهندسة المراوح السعرية المتقاطعة، تحسم بنية Quad-AI إحداثيات السيناريو المزدوج بدقة تامة من المقاومة R5 (4,315.62) نزولاً إلى الدعم S5 (3,500.00).
- 1هندسة الموجات وخطوط الاتجاه الممتدة لعدة أسابيع: اختراق خط المقاومة الأحمر الهابط الممتد منذ سبتمبر في مطلع نوفمبر، أعقبه رفض سعري لقمة مزدوجة أسفل المستوى
4,150.43وكسر هابط يعيد السعر نحو مروحة خطوط الدعم الزرقاء المتقاربة قرب3,869.22. - 2منطقة البيع
Sell zoneوحد الإلغاء القاطعPivot: منطقة عرض علوية للارتداد التصحيحي تبدأ عند المستوىR1 = 3,954.43وتُلغى بنيوياً بصرامة فوق حدBearish Below 4,027.07. - 3الأسهم الخضراء الرئيسية
Green Arrowsومنطقة الأرباحProfit zone(S1-S5): المسار الهبوطي الرئيسي المستهدف للمستوياتS1 = 3,869.22، والمستوىS2 = 3,793.78، والمستوىS3 = 3,714.42، والمستوىS4 = 3,613.27، والمستوىS5 = 3,500.00. - 4منطقة الانعكاس المشروطة
Reverse zone(R3-R5): مسار بديل صعودي محسوب مسبقاً (Dashed Arrows) يتجه نحو المستوياتR3 = 4,150.43، والمستوىR4 = 4,219.57، والمستوىR5 = 4,315.62إذا وفقط إذا ألغى السعر حد الارتكاز4,027.07.
قارن تنفيذ مخاطرة رأس المال على الحالة الحية للذهب XAUUSD على الإطار 4h في الشكل 4 (السعر الفوري 3,879.59) في ظل كلا النموذجين المعرفيين:
1. نمط إخفاق النموذج الحواري LLM / VLM: عند رؤية هبوط الذهب الحاد من 4,145 إلى 3,879.59، يعمد النموذج اللغوي الحواري إما إلى مطاردة الزخم البيعي فوراً عند السعر 3,879.59 مباشرةً فوق دعم المروحة الزرقاء S1 = 3,869.22 (مما يعرّض مركز البيع لضغط ارتدادي صاعد فوري يتراوح بين $75 إلى $147)، وإما إلى إعلان أن الذهب في حالة «تشبع بيعي» دون تقديم أي سعر إلغاء بنيوي محدد. وإن استعلام النموذج عشر مرات متتالية يفرز عشرة أرقام مختلفة لوقف الخسارة مصحوبةً بثقة لفظية غير معايَرة [4, 14].
2. هندسة التنفيذ الحتمية في بنية Quad-AI: عند السعر الفوري 3,879.59، يقف السعر على بُعد $10.37 فقط فوق الدعم الأول S1 = 3,869.22، وعلى بُعد $147.48 أسفل حد الإلغاء Pivot البالغ 4,027.07؛ وعليه فإن البيع الفوري بسعر السوق يحمل نسبة عائد إلى مخاطرة متدهورة للغاية تبلغ 10.37 / 147.48 = 0.070 فقط حتى الهدف الأول S1. أما انتظار ارتداد تصحيحي صاعد نحو نقطة المنتصف في منطقة البيع Sell zone (3,990.75، الواقعة في منتصف المسافة تماماً بين R1 = 3,954.43 وحد الارتكاز Pivot = 4,027.07) فيضغط مسافة الوقف البنيوي إلى 4,027.07 - 3,990.75 = $36.32، في حين يوسع المسافة الربحية الهابطة نحو الهدف S2 = 3,793.78 إلى $196.97 (بنسبة عائد إلى مخاطرة تبلغ 5.42 : 1) ونحو الهدف S3 = 3,714.42 إلى $276.33 (بنسبة عائد إلى مخاطرة تبلغ 7.61 : 1). ويتكرر كل إحداثي من هذه الإحداثيات بدقة السنت الواحد عبر 100 تقييم من أصل 100 تقييم. ويمكن للقراء دراسة قواعد التنفيذ المنهجية لهذه المناطق خطوةً بخطوة في دورة استراتيجية Trend Hunter في أكاديمية ForecastCity ومراجعة القائمة الكاملة للمصادر العلمية والرياضية عبر صفحة المصادر المرجعية للأكاديمية.
الأسئلة الشائعة
هل يؤدي ضبط درجة الحرارة على الصفر (temperature = 0) أو استخدام مطالبات سلسلة الأفكار (Chain-of-Thought) إلى جعل النموذج اللغوي موثوقاً لتوقع الأسواق المالية؟
كلا. فقد برهن أتيل وآخرون (Atil et al. [4]) أنه حتى عند ضبط temperature = 0 مع تثبيت البذور العشوائية، تُظهر النماذج اللغوية الطليعية انجرافاً في الإجابات يصل إلى ما بين 10% إلى 15% عبر التشغيلات المتطابقة، لأن عمليات اختزال المصفوفات ذات الفاصلة العائمة بدقة 16 بت على معالجات GPU المجمَّعة ديناميكياً هي عمليات غير تجميعية تقلب قيم اللوجيت المتقاربة وتتدحرج انحدارياً ذاتياً عبر النص. كما أن مطالبات سلسلة الأفكار (Chain-of-Thought) تظل تعمل فوق وحدات رقمية مشظاة بتقطيع BPE، حيث وثق مختبر أبحاث آبل (GSM-Symbolic [7]) انهياراً في الدقة الرياضية بنسبة تصل إلى 65% لمجرد تغير الثوابت العددية أو ورود جملة سوقية سياقية واحدة غير ذات صلة.
لماذا تفشل نماذج الرؤية واللغة متعددة الوسائط (VLMs) عند تزويدها بلقطات شاشة نظيفة لمخططات الشموع اليابانية؟
تقطّع نماذج VLM متعددة الوسائط صور الرسوم البيانية إلى رقع بكسلية خشنة بأبعاد 14×14 أو 16×16 بكسل وتسقطها عبر محوّل خطي فاقد للمعلومات داخل فضاء الوحدات اللفظية للغة الطبيعية. ورغم قدرتها على تمييز الملامح الشكلية العامة للموجات على نحو يشبه النظرة البشرية العابرة، تثبت الاختبارات المعيارية لدى هو وآخرين (Hu et al. [8]) أنها تفقد النسب الدقيقة لذيول شموع OHLC، وتتجاهل تحجيم التقلب بمعيار ATR، وتُبدي تحيزاً صعودياً غير مشروط قوياً، وينهار معامل المعلومات لديها نحو الصفر في الأنظمة العرضية أو المتقلبة مقارنةً بالنماذج الكمية العاملة مباشرةً على موتّرات OHLCV وفق معيار IEEE-754.
لماذا تدعي بعض الاختبارات الخلفية الشائعة على منصات التواصل أن ChatGPT أو GPT-4 تفوق على مؤشرات الأسهم أو العملات الرقمية؟
أثبت سركار وفافا في جامعتي شيكاغو وهارفارد (Sarkar and Vafa [11]) أن الاختبارات التاريخية الخلفية المطبَّقة على النماذج اللغوية الجاهزة المدرَّبة مسبقاً تعاني تلوثاً حاداً بتحيز استباق المستقبل (Look-Ahead Bias)؛ إذ حفظت أوزان النموذج ضمنياً نتائج أرباح الشركات وأحداث الاقتصاد الكلي ومسارات الأصول التي وقعت فعلياً قبل تاريخ القطع المعرفي للنموذج. وعند اختبار هذه النماذج بصرامة خارج العينة على شموع حية غير مرئية أو إخضاعها لتجارب الحذف المنهجية النظيفة (تان وآخرون في مؤتمر NeurIPS 2024 [1]؛ وشيه وآخرون [10])، لا تقدم الأعمدة الفقرية اللغوية المدرَّبة مسبقاً أي ميزة توقعية عددية فوق النماذج الكمية المتخصصة.
كيف توظف منظومة 4CastMachine AI النماذج اللغوية داخل محرك Sentiment AI دون تعريض المتداولين للهلوسات العددية؟
تفرض منظومة 4CastMachine AI جداراً نارياً دلالياً (Semantic Firewall) صارماً داخل بنية Quad-AI. إذ تُستخدم النماذج اللغوية المالية السياقية داخل محرك Sentiment AI حصرياً لقراءة تدفقات الأخبار غير المهيكلة، وتقييم القطبية الاتجاهية، وحساب التشابه الدلالي مع أحداث الاقتصاد الكلي التاريخية، مخرجةً قيماً عددية سلمية مقيدة النطاق [pt, ze,t, sim, λt] فحسب. ولا يولّد أي نموذج لغوي أهدافاً سعرية على الإطلاق؛ بل تُحسَب جميع كثافات الاحتمال المتصلة، وأوزان الأنظمة الديناميكية، ومناطق الرسم البياني بصورة حتمية خالصة بواسطة محركات Forecast AI، ومحرك Synergy AI، ومحرك Navigator AI.
الأبحاث المحكمة والمصادر المؤسسية
- [1]Tan, M., Merrill, M. A., Gupta, V., Althoff, T., & Hartvigsen, T. (2024). Are Language Models Actually Useful for Time Series Forecasting? Advances in Neural Information Processing Systems (NeurIPS 2024 Spotlight), 37.
- [2]Kalai, A. T., & Vempala, S. S. (2024). Calibrated Language Models Must Hallucinate. Proceedings of the 56th Annual ACM Symposium on Theory of Computing (STOC 2024), 160-171.
- [3]Xu, Z., Jain, S., & Kankanhalli, M. (2024). Hallucination is Inevitable: An Innate Limitation of Large Language Models. arXiv preprint arXiv:2401.11817.
- [4]Atil, B., Chittams, A., Fu, L., Ture, F., Xu, L., & Baldwin, B. (2024). LLM Stability: A Detailed Analysis with Some Surprises. arXiv preprint arXiv:2408.04667.
- [5]Singh, A. K., & Strouse, D. J. (2024). Tokenization Counts: The Impact of Tokenization on Arithmetic in Frontier LLMs. arXiv preprint arXiv:2402.14903.
- [6]Dziri, N., Lu, X., Sclar, M., Li, X. L., Jiang, L., Lin, B. Y., ... & Choi, Y. (2023). Faith and Fate: Limits of Transformers on Compositionality. Advances in Neural Information Processing Systems (NeurIPS 2023), 36, 70293-70332.
- [7]Mirzadeh, I., Alizadeh, K., Shahrokhi, H., Tuzel, O., Bengio, S., & Farajtabar, M. (2024). GSM-Symbolic: Understanding the Limitations of Mathematical Reasoning in Large Language Models. Apple Machine Learning Research / ICLR 2025, arXiv:2410.05229.
- [8]Hu, K., Xiao, L., Xu, S., Tang, Z., & Liu, M. (2026). Do VLMs Truly "Read" Candlesticks? A Multi-Scale Benchmark for Visual Stock Price Forecasting. arXiv preprint arXiv:2604.12659.
- [9]Jiang, J., Kelly, B., & Xiu, D. (2023). (Re-)Imag(in)ing Price Trends. The Journal of Finance, 78(6), 3193-3249.
- [10]Xie, Q., Han, W., Lai, Y., Peng, M., & Huang, J. (2023). The Wall Street Neophyte: A Zero-Shot Analysis of ChatGPT Over MultiModal Stock Movement Prediction Challenges. arXiv preprint arXiv:2304.05351.
- [11]Sarkar, S. K., & Vafa, K. (2024). Lookahead Bias in Pretrained Language Models. University of Chicago & Harvard University Working Paper, SSRN 4754678 / arXiv:2402.02092.
- [12]Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., ... & Perez, E. (2024). Towards Understanding Sycophancy in Language Models. International Conference on Learning Representations (ICLR 2024).
- [13]Wen, J., Zhong, R., Khan, A., Perez, E., Steinhardt, J., Huang, M., ... & He, H. (2025). Language Models Learn to Mislead Humans via RLHF. International Conference on Learning Representations (ICLR 2025), arXiv:2409.12822.
- [14]Xiong, M., Hu, Z., Lu, X., Li, Y., Fu, J., He, J., & Hooi, B. (2024). Can LLMs Express Their Uncertainty? An Empirical Evaluation of Confidence Elicitation in LLMs. International Conference on Learning Representations (ICLR 2024).
- [15]Zeng, A., Chen, M., Zhang, L., & Xu, Q. (2023). Are Transformers Effective for Time Series Forecasting? Proceedings of the AAAI Conference on Artificial Intelligence, 37(9), 11121-11128.
- [16]Gneiting, T., & Raftery, A. E. (2007). Strictly Proper Scoring Rules, Prediction, and Estimation. Journal of the American Statistical Association, 102(477), 359-378.
- [17]Loughran, T., & McDonald, B. (2011). When Is a Liability Not a Liability? Textual Analysis, Dictionaries, and 10-Ks. The Journal of Finance, 66(1), 35-65.
- [18]Araci, D. (2019). FinBERT: Financial Sentiment Analysis with Pre-trained Language Models. arXiv preprint arXiv:1908.10063.