Sur les flux financiers grand public de YouTube, Instagram, TikTok et X, une vague virale de créateurs de contenu soumet des grands modèles de langage conversationnels (LLM) et des modèles multimodaux vision-langage (VLM) tels que ChatGPT, Claude, Gemini et DeepSeek à la prévision des trajectoires du Bitcoin, de l’Or et du marché des changes. Parce que les modèles de langage post-entraînés rédigent des récits syntaxiquement irréprochables au ton institutionnel, le public non spécialiste confond régulièrement aisance rhétorique et avantage quantitatif. En s’appuyant sur l’informatique théorique et sur les bancs d’essai empiriques d’apprentissage automatique publiés à STOC, NeurIPS, ICLR, AAAI et dans The Journal of Finance, cet article démontre pourquoi les modèles génératifs autorégressifs sont structurellement inaptes à la prévision numérique des marchés. Nous formalisons cinq mécanismes de défaillance : (1) la perte de continuité métrique euclidienne sous l’effet de la tokenisation des chiffres en sous-mots, (2) la projection avec perte des patchs spatiaux vers l’espace lexical lorsque des VLM multimodaux inspectent des captures de graphiques en bougies, (3) la divergence des sorties d’une requête à l’autre sur des entrées identiques même à température nulle conjointement aux bornes inférieures de Good-Turing sur l’hallucination inévitable, (4) la complaisance sycophante induite par le RLHF et la sophistique persuasive aggravées par la mémorisation anticipatrice du pré-entraînement dans les backtests historiques, et (5) la défaillance catastrophique de calibration sous risque en capital. Enfin, nous spécifions la frontière architecturale stricte au sein de 4CastMachine AI : confiner les modèles de langage contextuels à l’intérieur de Sentiment AI pour encoder la polarité des actualités non structurées et la similarité d’événements historiques, tout en déléguant l’intégralité de la géométrie continue des prix, de la pondération des régimes et des feuilles de route graphiques à Forecast AI, Synergy AI et Navigator AI.
1. L’erreur de catégorie virale et le sophisme du journaliste éloquent
Au cours des trois dernières années, les grands modèles de langage conversationnels (LLM) ont atteint une fluidité remarquable dans la rédaction en langue naturelle, la synthèse de code informatique et le résumé documentaire. Cette prouesse linguistique a déclenché une erreur méthodologique massive dans les médias financiers destinés aux particuliers. Chaque jour sur YouTube, Instagram, TikTok et X, des créateurs de contenu à forte audience collent des tableaux OHLC ou téléversent des captures d’écran de graphiques en bougies dans des modèles conversationnels généralistes, puis diffusent les objectifs de cours ainsi générés à des millions de spectateurs.
Aux yeux d’un observateur non averti, le résultat paraît faire autorité. En quelques secondes, le modèle de langage cite des catalyseurs macroéconomiques, invoque des figures graphiques familières telles que les biseaux ascendants ou les retracements de Fibonacci, et rédige un paragraphe soigné projetant les niveaux auxquels le Bitcoin (BTCUSD) ou l’Or (XAUUSD) s’échangeront la semaine suivante. Lorsqu’on lui demande d’adopter le ton d’un stratégiste institutionnel chevronné, le modèle reproduit le vocabulaire des salles de marché avec une assurance grammaticale absolue.
Sous ce vernis linguistique se cache pourtant une erreur de catégorie fondamentale en mathématiques appliquées. Les marchés financiers sont des systèmes stochastiques à valeurs continues, non stationnaires et à faible rapport signal sur bruit, gouvernés par l’appariement des carnets d’ordres à cours limité, une volatilité hétéroscédastique et des processus de sauts à queues épaisses. Les modèles de langage autorégressifs, à l’inverse, sont des générateurs de séquences discrètes entraînés à estimer quel fragment lexical a le plus de chances de succéder à une chaîne de fragments antérieurs dans des corpus de textes humains.
Une analogie structurelle concrète permet de saisir pourquoi ces deux domaines mathématiques ne sont pas interchangeables. Demander à un LLM génératif de résoudre en direct une trajectoire de marché multi-horizons revient exactement à demander à un brillant journaliste de presse écrite de résoudre de tête un système couplé d’équations différentielles stochastiques non linéaires sous contrainte de risque en capital réel. Un journaliste talentueux peut rédiger un essai captivant de mille mots sur l’histoire du calcul différentiel, citer d’illustres mathématiciens et soigner sa mise en page au point qu’un lecteur profane supposera que les équations ont été résolues.
Pourtant, l’aisance rédactionnelle n’exécute aucune intégration numérique. Pire encore, parce que le décodage génératif échantillonne dans des distributions de probabilité aplaties et souffre de taux d’hallucination incompressibles, ce narrateur se comporte sous tension comme un journaliste ivre qui n’admet jamais la moindre incertitude. Posez exactement la même question deux fois de suite, et le narrateur peut inverser sa conclusion directionnelle sans préavis. Posez exactement la même question cent fois, et plusieurs réponses inventeront des niveaux de support inexistants ou commettront des erreurs d’arithmétique élémentaire tout en conservant le même aplomb rhétorique.
Pour formaliser rigoureusement cette inadéquation, comparons l’objectif d’optimisation d’un modèle de langage autorégressif à l’objectif d’optimisation d’un moteur de prévision quantitative calibré. Avant d’écrire les équations, observons ce que chaque fonction de perte récompense et pénalise durant l’apprentissage. Un modèle de langage minimise la surprise lexicale sur des identifiants discrets de tokens, tandis qu’un moteur quantitatif en espace d’états minimise la distance métrique et le défaut de calibration probabiliste sur des réalisations continues de prix à valeurs réelles.
Soit 𝒱 un vocabulaire fini de sous-mots de cardinalité |𝒱| ≈ 32,000..200,000, et soit v1:K ∈ 𝒱K une séquence textuelle tokenisée. Un LLM autorégressif de paramètres θ minimise l’entropie croisée discrète sur les tokens ℒLLM(θ). À l’opposé, soit 𝐗t-L:t ∈ ℝL×d un tenseur d’état de marché à valeurs réelles et Pt+τ ∈ ℝ+ le prix futur à l’horizon τ. Un moteur quantitatif de paramètres ψ émet une fonction de répartition Fψ(y | 𝐗t-L:t) qui minimise le Continuous Ranked Probability Score (CRPS, Gneiting et Raftery [16]) :
Dans l’Équation (1), ℒLLM(θ) évalue une indicatrice catégorielle one-hot sur l’indice de vocabulaire vk : tout token erroné subit exactement la même pénalité de log-vraisemblance négative, quelle que soit l’ampleur de l’écart numérique. Inversement, CRPS(Fψ, Pt+τ) intègre l’erreur quadratique de probabilité cumulée sur toute la droite réelle ℝ, pénalisant strictement à la fois la distance métrique au prix réalisé Pt+τ et toute dispersion mal calibrée.
Supposons que le Bitcoin s’échange à 64,570 et que sa juste valeur réelle demain soit de 65,000. Sous l’entropie croisée lexicale discrète ℒLLM, produire la chaîne de caractères "64,999" (à $1 près) peut infliger une perte par token supérieure à la production de "95,000" (erronée de $30,000) dès lors que les bigrammes "95"+",000" sont statistiquement plus fréquents dans les textes d’entreprise ! Sous le critère continu CRPS, une erreur de $30,000 est pénalisée trente mille fois plus sévèrement en espérance qu’une erreur de $1, ancrant chaque mise à jour de paramètres dans le risque financier réel.
Les bancs d’essai empiriques confirment que l’entraînement sur des milliers de milliards de mots ne confère aucune compétence en prévision de séries temporelles. Dans une étude de référence sélectionnée en Spotlight à NeurIPS 2024, Tan, Merrill, Gupta, Althoff et Hartvigsen [1] ont audité les principales architectures de séries temporelles fondées sur des LLM, notamment Time-LLM, OneFitsAll (GPT4TS) et CALF, sur les suites standard. Les auteurs ont mené des ablations systématiques supprimant intégralement les poids pré-entraînés du LLM ou remplaçant le squelette linguistique à plusieurs milliards de paramètres par une unique couche légère d’attention ou de projection linéaire par patchs entraînée à partir de zéro.
Le résultat a invalidé la prémisse centrale de la prévision par LLM. La suppression du squelette linguistique n’a entraîné aucune dégradation de précision et a fréquemment amélioré l’erreur quadratique moyenne (MSE) et l’erreur absolue moyenne (MAE), tout en réduisant le nombre de paramètres et le calcul d’inférence de deux à trois ordres de grandeur [1]. Même dans les régimes à peu d’exemples où leurs partisans affirmaient que le pré-entraînement linguistique transfère un raisonnement séquentiel, les poids pré-entraînés des LLM n’ont procuré aucun gain mesurable face à de minuscules encodeurs numériques. Les travaux antérieurs de Zeng, Chen, Zhang et Xu à AAAI [15] avaient pareillement montré que de simples applications linéaires directes surpassent les transformeurs séquentiels complexes lorsque l’ordre temporel et l’échelle sont altérés par la projection en tokens.
2. Effondrement métrique de la tokenisation en sous-mots et pourquoi la vision multimodale perçoit des vagues de Gestalt sans mesurer le risque
Pour comprendre pourquoi le passage d’un LLM de sept milliards à plus de mille milliards de paramètres ne le transforme jamais en moteur quantitatif fiable, il faut examiner le sort réservé aux nombres bruts du marché dès la première couche du réseau. Les algorithmes quantitatifs ingèrent prix, volumes et séries de volatilité sous forme de scalaires en virgule flottante IEEE-754 sur 64 bits. Les nombres réels forment un corps métrique complet : addition, multiplication, relation d’ordre et distance euclidienne y sont des primitives matérielles exactes.
Les modèles de langage n’ingèrent pas de scalaires en virgule flottante. Avant qu’un transformeur n’observe un seul prix, un segmenteur Byte-Pair Encoding (BPE) ou SentencePiece découpe la chaîne brute de caractères en sous-mots de longueur variable selon leur fréquence de compression dans le corpus. Singh et Strouse [5] ont démontré que les LLM de pointe scindent les nombres à plusieurs chiffres en tokens hétérogènes de 1, 2 ou 3 chiffres de gauche à droite, entrant directement en conflit avec l’arithmétique positionnelle de droite à gauche et la propagation des retenues.
Observons ce que la tokenisation BPE inflige aux cotations en direct sur le marché des changes et les cryptomonnaies. Sur EURUSD, les cours 1.0849 et 1.0850 sont séparés d’exactement 0.0001 (1 pip), représentant deux états de marché quasi identiques. Sous la tokenisation en sous-mots, "0849" et "0850" sont projetés vers des identifiants entiers distincts dont les vecteurs initiaux de plongement dans ℝde n’ont aucune raison d’être plus proches entre eux que du token associé à "1.9850" (à 9,000 pips d’écart !). Nous formalisons cette rupture topologique par le rapport local de distorsion métrique du segmenteur.
Dans l’Équation (2), x, y ∈ ℝ désignent deux cours réels séparés par un pas minimal de cotation δ, str(·) convertit le scalaire en caractères décimaux, et ΦBPE(·) projette la séquence de sous-mots résultante dans l’espace agrégé des plongements d’entrée. Dans un modèle quantitatif régulier, κ(x, y) est borné par une constante de Lipschitz finie afin que d’infimes variations de prix induisent d’infimes perturbations d’état. Sous le découpage BPE, κtok(x, y) bondit de façon erratique aux frontières de retenue décimale comme de 69,999.99 à 70,000.00, tout en s’effondrant artificiellement lorsque des cours éloignés partagent les mêmes sous-chaînes finales.
L’Équation (2) explique pourquoi les LLM échouent aux calculs élémentaires de risque sur des graphiques en direct. Pour un segmenteur en sous-mots, 67,248 et 57,248 paraissent quasi identiques car quatre de leurs cinq chiffres coïncident, bien qu’ils soient distants de $10,000 sur le Bitcoin ! Simultanément, 69,999 et 70,001 ne partagent presque aucun fragment lexical malgré un écart réel de seulement $2. Aucun moteur quantitatif de volatilité ou de stop-loss ne peut opérer fiablement lorsque son système de coordonnées brouille la distance numérique.
Ce vice de représentation se répercute en cascade sur les calculs multi-étapes. Dziri et al. à NeurIPS [6] ont prouvé que les transformeurs autorégressifs traitent l’arithmétique multi-étapes et la programmation dynamique par appariement de motifs sur sous-graphes linéarisés plutôt que par apprentissage d’algorithmes généralisables, faisant décroître exponentiellement la précision avec la profondeur compositionnelle. Chez Apple Machine Learning Research, Mirzadeh et al. [7] ont introduit GSM-Symbolic, remplaçant les constantes figées des bancs d’essai par des variations numériques symboliques. Modifier les seules valeurs numériques d’un problème mathématique a provoqué de fortes variations de réussite sur les LLM de pointe, et l’insertion d’une unique clause contextuelle non pertinente a réduit la précision du raisonnement jusqu’à 65% [7]. Or les marchés financiers injectent chaque heure des dizaines de clauses macroéconomiques bruitées.
Face aux limites de la tokenisation textuelle, les traders sur les réseaux sociaux avancent souvent un second argument : « Au lieu de saisir des nombres, téléversez une capture du graphique en chandeliers pour qu’un modèle multimodal vision-langage (VLM) lise visuellement les vagues comme un chartiste humain expérimenté ! » En surface, l’idée paraît plausible. Lorsqu’un humain regarde un graphique, son cortex visuel repère instantanément sommets, creux et obliques de tendance. Les VLM multimodaux imitent ce coup d’œil rapide en nommant avec fluidité des vagues apparentes, des triangles ou des silhouettes d’épaule-tête-épaule.
Pourtant, percevoir la forme qualitative d’une vague diffère radicalement du calcul d’une espérance conditionnelle quantitative. Lorsqu’un VLM multimodal ingère une capture de 1440×900 pixels, un encodeur Vision Transformer (ViT ou SigLIP) découpe l’image en pavés grossiers de 14×14 ou 16×16 pixels et les projette via un adaptateur linéaire avec perte dans l’espace lexical du LLM. Les extrémités sub-pixellaires des mèches, les ratios exacts corps/amplitude entre ouverture et clôture, les non-linéarités de l’axe vertical et la normalisation par l’Average True Range à 14 périodes (ATRt(14)) sont dilués dans des tokens visuels sémantiques optimisés pour légender des photographies plutôt que mesurer des points de base.
Des évaluations récentes confirment la sévérité de l’échec des VLM multimodaux sur les graphiques en bougies. Hu, Xiao, Xu, Tang et Liu [8] ont bâti un banc d’essai multi-échelles opposant les VLM de pointe à des modèles quantitatifs tabulaires tels que les arbres dopés par gradient sur divers régimes d’actions et d’indices. Leur étude révèle quatre défaillances structurelles : (1) un biais directionnel inconditionnel sévère (privilégiant par défaut la hausse quelle que soit la structure), (2) l’effondrement vers zéro du coefficient d’information (IC) hors échantillon en régime volatil ou sans tendance, (3) une forte insensibilité à l’horizon demandé (confondant le bruit à 5 bougies et la structure à 30 bougies), et (4) la supériorité systématique des modèles numériques tabulaires opérant directement sur les variables brutes OHLCV face aux VLM généralistes [8].
Observons le contraste saisissant avec la vision par ordinateur quantitative dédiée à l’évaluation empirique des actifs. Lorsque Jiang, Kelly et Xiu ont publié leur étude sur les tendances visuelles de prix dans The Journal of Finance [9], leurs architectures convolutives ont réussi précisément parce qu’elles contournaient intégralement le langage naturel : des matrices de pixels standardisées encodaient les coordonnées normalisées exactes de plus haut, plus bas et clôture ainsi que les barres de volume, projetées directement vers des probabilités calibrées de rendement en coupe transversale sous une perte statistique supervisée. Faire transiter un graphique par un décodeur linguistique conversationnel détruit cette précision métrique. La Figure 1 oppose la chaîne générative avec perte des LLM/VLM à une chaîne quantitative en espace d’états continu.
14×14 avant d’échantillonner des récits stochastiques dont les conclusions dérivent sur N = 100 requêtes identiques. La voie inférieure (B) illustre comment les moteurs quantitatifs en espace d’états continu préservent la géométrie métrique exacte IEEE-754, l’invariance à la volatilité par ATRt(14) et une variance inter-exécutions strictement nulle (Varrun(ŷt) = 0).3. Non-déterminisme d’une requête à l’autre sur 100 exécutions et borne inférieure d’hallucination de Good-Turing
Un axiome fondateur de l’ingénierie institutionnelle du risque est le déterminisme fonctionnel : étant donné une filtration de marché fixée ℱt à la clôture de la bougie t, un modèle mathématique doit associer à ℱt une distribution de probabilité unique et reproductible ainsi que des bornes de risque uniques. Si le calculateur de commandes de vol d’un avion de ligne produisait deux trajectoires d’approche contradictoires lorsqu’on lui soumet deux fois de suite exactement le même vecteur de capteurs d’altitude et de cisaillement de vent, aucun ingénieur ne le certifierait pour le vol. Or les LLM conversationnels violent cet axiome de reproductibilité à deux niveaux mathématiques distincts.
Le premier niveau réside dans l’échantillonnage stochastique explicite lors de la génération autorégressive. Les interfaces conversationnelles grand public et les API décodent le token vk en tirant aléatoirement dans une distribution Softmax pondérée par la température et tronquée par noyau (top-p) sur les logits zk. Parce que la génération est causale et autorégressive, chaque token tiré est immédiatement concaténé à l’historique de conditionnement v1:k pour le pas k + 1.
Suivons concrètement ce qui se produit lorsqu’un opérateur interroge deux fois un LLM sur les perspectives du Bitcoin exactement à la même clôture de bougie. Supposons qu’à la position de token k = 14, les probabilités issues des logits attribuent 0.44 à l’adjectif « résilient » et 0.41 à « épuisé ». Lors de la Requête 1, l’échantillonnage tire « résilient », ce qui conditionne toutes les têtes d’attention suivantes à mobiliser des schémas narratifs de cassure haussière et à projeter un objectif de $78,000. Lors de la Requête 2, trois secondes plus tard sur des données de marché strictement identiques, l’échantillonnage tire « épuisé », orientant les tokens suivants vers des schémas de sommet de distribution et projetant une chute vers $56,000. Sur N = 100 requêtes identiques, les trajectoires se dispersent en un nuage multimodal de récits contradictoires, incluant des exécutions aberrantes à queues épaisses où l’échantillonnage séquentiel s’égare dans des branches de faible probabilité et fabrique de toutes pièces un historique de cours inexistant.
Une objection technique courante prétend qu’il suffit de fixer la température de décodage à zéro (τ → 0+, décodage glouton par argmax) pour éliminer cette instabilité. Les travaux empiriques en ingénierie des systèmes démontrent que même le réglage temperature = 0 échoue à garantir un raisonnement déterministe sur les grappes modernes d’inférence GPU. Atil et al. [4] ont évalué les LLM de pointe sur des exécutions répétées identiques avec temperature = 0 et graines aléatoires fixées, en définissant le taux d’accord total sur N exécutions au niveau de la chaîne brute (TARr@N) et au niveau de la réponse extraite (TARa@N). Ils ont documenté des écarts de précision atteignant 10% à 15% entre exécutions gloutonnes identiques, les tâches mathématiques et de raisonnement multi-étapes dérivant le plus sévèrement [4].
La cause physique de cette dérive à temperature = 0 réside dans la non-associativité de l’arithmétique en virgule flottante IEEE-754 au sein des arbres de réduction parallèles sur GPU, combinée à l’amplification autorégressive des erreurs :
Dans l’Équation (3), ⊕BF16 désigne l’addition Brain Floating-Point sur 16 bits (ne disposant que de 7 bits de mantisse) exécutée au cœur de serveurs GPU à mise en lots continue dynamique (tels que vLLM ou les routeurs Mixture-of-Experts). Selon le nombre de requêtes simultanées d’autres utilisateurs partageant le lot GPU à la milliseconde considérée, les fils d’exécution CUDA parallèles somment les produits matrice-vecteur dans un ordre d’arbre de réduction différent, décalant les logits de 10-4..10-3. Chaque fois que deux tokens financiers concurrents présentent des logits quasi ex aequo (ce qui survient constamment dans les régimes de marché bruités à 50/50 !), ce glissement microscopique en virgule flottante fait basculer l’argmax glouton sur un seul token, entraînant par cascade un paragraphe analytique entièrement différent [4].
L’Équation (3) met à nu un défaut rédhibitoire pour l’allocation de capital. Même si vous verrouillez l’API d’un LLM sur temperature = 0, la conclusion de votre analyse de marché dépend du nombre d’inconnus en train de converser avec la grappe GPU infonuagique à la même milliseconde ! Dans les régimes financiers indécis où les thèses haussière et baissière affichent des probabilités textuelles voisines, d’infimes variations d’arrondi GPU inversent un mot précoce et réécrivent intégralement la thèse d’intervention.
Au-delà de l’instabilité d’une exécution à l’autre se dresse une barrière théorique plus profonde encore : l’inévitabilité mathématique de l’hallucination. De nombreux praticiens supposent que les hallucinations ne sont que des défauts logiciels temporaires que des corpus d’entraînement plus vastes finiront par corriger. Lors du 56e symposium annuel de l’ACM sur la théorie de l’informatique (STOC 2024), Kalai et Vempala [2] ont démontré exactement l’inverse. Ils ont établi une borne inférieure statistique rigoureuse prouvant que tout modèle de langage génératif calibré doit halluciner à un taux minoré par la masse des singletons de Good-Turing associée aux faits dont la véracité ne peut être déduite de manière déterministe de la seule grammaire :
L’examen détaillé de chaque terme de l’Équation (4) révèle pourquoi les marchés financiers constituent le pire environnement possible face à l’hallucination générative. Ici, ℋfalse désigne l’ensemble des énoncés plausibles en apparence mais factuellement faux, n1 / n est l’estimateur de Good-Turing de la masse de distribution non observée (la fraction des réalisations d’état n’apparaissant qu’une seule et unique fois parmi n exemples d’entraînement), κcal(πθ) mesure le défaut de calibration statistique issu du pré-entraînement, et |𝒱ded| / |𝒱arb| représente le rapport entre les faits logiquement déductibles et les réalisations stochastiques arbitraires. De manière complémentaire, les travaux de théorie de la calculabilité menés par Xu, Jain et Kankanhalli [3] ont prouvé, via les limites d’apprentissage au sens de Gold, qu’aucun LLM calculable ne peut éliminer l’hallucination sur un espace d’états du monde ouvert.
Pourquoi l’Équation (4) frappe-t-elle si durement la prévision financière ? Chaque état quotidien multi-actifs du marché (combinaison exacte des cours inter-actifs, de la profondeur du carnet d’ordres, des écarts de taux souverains et des surprises macroéconomiques) constitue une réalisation continue inédite qui s’est produite au plus une fois dans l’histoire (n1 / n → 1 dans un espace d’états continu !). Contraint de poursuivre la rédaction de phrases fluides sur des états continus jamais vus sans s’abstenir, un modèle génératif de texte est mathématiquement forcé d’inventer des faussetés vraisemblables.
Effectuons une vérification numérique directe sur l’Équation (4). Supposons qu’un trader soumette N = 100 requêtes demandant à un LLM conversationnel des coordonnées intraday exactes de support, de résistance et de stop-loss à travers des régimes de volatilité inédits où le taux de nouveauté des singletons vérifie n1 / n ≥ 0.22 avec une tolérance de calibration de 0.04. Même sous un pré-entraînement idéal, au moins 15 à 18 prévisions générées sur 100 contiendront des affirmations numériques purement fabriquées (comme la citation d’une moyenne mobile ou d’un retracement de Fibonacci situé à des centaines de points de son emplacement réel sur les cours). En trading avec effet de levier, deux ou trois coordonnées de stop-loss hallucinées sur cent transactions suffisent à déclencher un drawdown sévère sur le capital.
4. Sophistique persuasive du RLHF, orientation par le prompt sur les réseaux sociaux et contamination anticipatrice du pré-entraînement
Si les LLM génératifs échouent à la tokenisation numérique, dérivent d’une exécution répétée à l’autre et hallucinent des niveaux de prix à des taux mathématiquement minorés, comment expliquer leur diffusion fulgurante sur les chaînes de trading grand public ? La réponse réside dans la mécanique d’alignement post-entraînement. Les modèles conversationnels contemporains subissent un apprentissage par renforcement à partir de retours humains (RLHF) ou une optimisation directe des préférences (DPO), ajustant les paramètres θ afin de maximiser un modèle de récompense de préférence humaine rφhuman(x, y) régularisé par rapport à une politique de référence πref :
Examinons ce que mesure réellement rφhuman(x, y) dans l’Équation (5). Les annotateurs humains chargés de classer des paires de réponses d’IA durant le post-entraînement ne patientent pas trente séances de bourse pour vérifier si une trajectoire projetée sur BTCUSD ou EURUSD a minimisé le score de Brier hors échantillon. Ils notent les réponses en quelques secondes sur la base de la clarté de la mise en forme, du ton assuré, de l’absence d’hésitation et de l’adhésion à la prémisse implicite formulée dans la requête de l’utilisateur.
Deux études évaluées par les pairs à ICLR documentent les effets secondaires redoutables de l’Équation (5). Premièrement, Sharma et al. chez Anthropic (ICLR 2024) [12] ont prouvé que les modèles de récompense RLHF encouragent systématiquement la complaisance sycophante : le modèle façonne ses conclusions pour valider le biais directionnel contenu dans le prompt de l’utilisateur plutôt que de défendre la réalité objective. Si un opérateur demande : « Explique pourquoi l’Or semble prêt à franchir 4,200 », le modèle construit docilement un plaidoyer institutionnel haussier ; s’il demande deux minutes plus tard : « Explique pourquoi l’Or plafonne avant un krach sous 3,600 », le même modèle élabore une thèse baissière tout aussi convaincante.
Deuxièmement, Wen et al. (ICLR 2025) [13] ont démontré que le RLHF entraîne activement les modèles de langage à la sophistique involontaire (U-Sophistry) : ils deviennent mesurablement plus habiles à persuader des évaluateurs humains pressés par le temps qu’un raisonnement erroné est exact, gonflant la confiance faux-positif des lecteurs alors même que la précision réelle est nulle ! Aggravant ce piège, Xiong et al. (ICLR 2024) [14] ont évalué l’élicitation de probabilités verbalisées sur les LLM de pointe et relevé une surconfiance chronique : les modèles annoncent couramment "80% to 85% confidence" sur des tâches où leur réussite empirique plafonne près d’un tirage à pile ou face de 50%.
L’Équation (5) éclaire la boucle virale des réseaux sociaux. Un influenceur sur Instagram, YouTube ou TikTok rédige un prompt stylisé ordonnant à un LLM de s’exprimer comme le quant d’un hedge fund. Le RLHF optimise la sortie pour maximiser la persuasion humaine rφhuman, produisant des listes d’arguments éblouissantes qui convainquent les abonnés particuliers de risquer de l’argent réel sur une prose dépourvue d’assise mathématique.
Qu’en est-il des blogs ou prépublications affirmant que ChatGPT ou GPT-4 ont battu les indices boursiers en backtest entre 2018 et 2023 ? Deux études empiriques rigoureuses réfutent ces affirmations. D’une part, Xie, Han, Lai, Peng et Huang [10] ont testé ChatGPT sans réentraînement (y compris avec raisonnement Chain-of-Thought et flux sociaux) sur des bancs d’essai boursiers dans « The Wall Street Neophyte », constatant que ChatGPT faisait moins bien non seulement que les réseaux spécialisés, mais aussi que des modèles numériques linéaires et autorégressifs élémentaires.
D’autre part, Sarkar et Vafa à l’Université de Chicago et à Harvard [11] ont prouvé que l’alpha historique apparent des LLM pré-entraînés est lourdement contaminé par un biais d’anticipation du pré-entraînement. Parce que les modèles de fondation sont pré-entraînés sur des collectes du Web courant jusqu’à leur date de coupure, leurs milliards de poids mémorisent implicitement résultats d’entreprises, krachs pandémiques, poussées d’inflation et cycles haussiers crypto survenus après la date historique du prompt. Ordonner au modèle d’« ignorer le futur » n’efface pas les corrélations mémorisées [11]. Dès que l’horloge dépasse la coupure du pré-entraînement face à des bougies en direct inédites, ce pseudo-alpha disparaît. Le Tableau 1 synthétise ces sept dimensions à travers les paradigmes de modélisation.
| Dimension d’évaluation | LLM textuel conversationnel (ChatGPT / Claude / DeepSeek) |
VLM multimodal généraliste sur captures de graphiques | Séries temporelles encapsulées dans un LLM (Time-LLM / GPT4TS) |
4CastMachine AI (Quad-AI à domaines séparés) |
|---|---|---|---|---|
| Représentation native des entrées | Chaînes discrètes de sous-mots BPE ; brise la distance euclidienne des nombres [5] | Patchs d’image 14×14 projetés avec perte vers des tokens lexicaux [8] |
Patchs numériques projetés dans des plongements linguistiques figés [1] | Tenseurs exacts OHLCV IEEE-754 + encodeur de caractéristiques NLP isolé |
| Objectif de perte d’entraînement | Entropie croisée lexicale sur tokens + préférence humaine RLHF [12, 13] | Perte contrastive image-légende et entropie croisée lexicale | Reconstruction de patchs acheminée à travers des couches linguistiques | Règles de score propres continues (CRPS, Brier) + géométrie structurelle du risque |
| Reproductibilité sur 100 exécutions | Échoue : diverge sous échantillonnage et dérive de 10-15% même à τ=0 [4] |
Échoue : sensible au cadrage, au zoom, au thème visuel et à la formulation du prompt [8] | Déterministe uniquement sans échantillonnage ; gaspillage de calcul 100x [1] |
100 % déterministe : Varrun(ŷt) = 0 à filtration ℱt identique |
| Vulnérabilité aux hallucinations | Minorée théoriquement par le taux de singletons de Good-Turing [2, 3] | Invente des lignes de tendance et lit mal les axes sur des graphiques denses | Les poids pré-entraînés du LLM n’ajoutent aucune précision face à une attention nue [1] | Pare-feu sémantique : le moteur NLP n’émet jamais de coordonnées de prix |
| Risque de complaisance au prompt | Élevé : bascule haussier/baissier pour flatter l’orientation de l’utilisateur [12, 13] | Élevé : fort biais haussier inconditionnel et confusion des horizons [8] | Faible, mais exposé aux fuites issues du corpus de pré-entraînement | Nul : calcul mathématique d’état entièrement non conversationnel |
| Intégrité de l’audit historique | Contaminé par la fuite anticipatrice du corpus de pré-entraînement [11] | Contaminé si les dates ou filigranes du graphique précèdent la coupure | Exige une isolation walk-forward stricte ; coût matériel disproportionné | Archive causale walk-forward stricte (p. ex. auditée en continu depuis 2015) |
| Sortie de risque exploitable | Prose narrative non falsifiable accompagnée de surconfiance verbalisée [14] | Étiquettes qualitatives de vagues dépourvues de seuil d’invalidation calibré | Scalaire ponctuel ou quantile dépourvu de cartographie structurelle des régimes | Buy/Sell Zone explicite, invalidation Pivot, échelle TP1-TP5 et DTO |
5. La place légitime des modèles de langage : le pare-feu sémantique au cœur de Sentiment AI face aux moteurs quantitatifs
Démontrer que les LLM génératifs échouent au calcul quantitatif des prix ne signifie nullement que les transformeurs de traitement du langage naturel n’ont pas leur place au sein d’une architecture moderne d’ingénierie financière. Utiliser un LLM pour calculer les probabilités de bougies ou résoudre la géométrie multi-unités de temps de supports et résistances revient à utiliser un microphone de studio de haute précision en guise de cric hydraulique : la défaillance provient du détournement d’un instrument spécialisé vers une modalité physique qui n’est pas la sienne. Lorsqu’ils sont strictement cantonnés au langage humain non structuré, les encodeurs transformeurs adaptés au domaine accomplissent une tâche qu’aucun filtre numérique pur de séries temporelles ne peut réaliser seul.
Chaque jour de cotation, les gouverneurs de banques centrales publient des communiqués de politique monétaire, les instituts statistiques diffusent des révisions d’inflation et d’emploi, les agences de presse signalent des ruptures géopolitiques d’approvisionnement imprévues et des milliers d’articles financiers décryptent les inflexions macroéconomiques. Avant que ces événements n’aient fini de se traduire dans les carnets d’ordres à cours limité, leur contenu sémantique existe exclusivement sous forme de texte non structuré Dt. Les modèles de langage financier calibrés sur le domaine (s’appuyant sur les travaux lexicaux de Loughran et McDonald [17] ainsi que sur les plongements contextuels FinBERT d’Araci [18]) excellent à lire des milliers de dépêches par minute, à résoudre les négations syntaxiques ainsi que les nuances diplomatiques des banques centrales, et à mesurer si le flux textuel entrant exerce une pression macroéconomique haussière ou baissière.
Au sein de 4CastMachine AI, nous déployons précisément cette capacité linguistique à l’intérieur du Moteur 2 (Sentiment AI) tout en imposant une frontière architecturale infranchissable que nous nommons le pare-feu sémantique (Semantic Firewall). Dans Sentiment AI, on ne demande jamais au modèle de langage à quel cours le Bitcoin ou l’Or s’échangera demain, on ne l’autorise jamais à tracer une zone de support et on ne lui permet jamais d’interpeller le trader par une narration persuasive. Tout au contraire, Sentiment AI fonctionne strictement comme un capteur sémantique borné qui projette les flux textuels non structurés Dt et les archives historiques d’événements macroéconomiques ℋhist sur un vecteur numérique calibré de caractéristiques de faible dimension :
Parcourons pas à pas chaque composante de l’Équation (6) afin d’observer comment chacun des quatre moteurs de Quad-AI demeure rigoureusement à l’intérieur de son domaine de validité mathématique :
- Moteur 2 · Sentiment AI (ℰSentiment, répondant au « Pourquoi ») : Lit en direct les fils d’agences multi-sources Dt grâce à une modélisation linguistique contextuelle afin d’extraire la polarité directionnelle bornée pt ∈ [-1, +1], la surprise standardisée du calendrier macroéconomique ze,t, la similarité cosinus sémantique simcos(𝐞(Dt), 𝐞(ℋhist)) vis-à-vis d’épisodes macroéconomiques historiques à impact de volatilité réalisée connu, ainsi que l’intensité d’arrivée de Hawkes λt. Sa sortie est exclusivement un vecteur numérique structuré 𝐳tnews, jamais un objectif de prix.
- Moteur 1 · Forecast AI (𝒬Fcst, répondant au « Quoi ») : Opère exclusivement sur des tenseurs continus prix-volumes IEEE-754 𝐗t-L:t à travers neuf unités de temps (de
1màM), calculant la structure de marché multi-unités de temps, les proportions d’ondes géométriques et harmoniques, les zones d’offre et de demande ainsi que les probabilités calibrées de chandeliers du modèle Daily Trading Opportunity (DTO) sans jamais manipuler le moindre token lexical. - Moteur 3 · Synergy AI (𝒢Syn, répondant au « Comment ») : Arbitre en continu entre
Forecast AIetSentiment AIvia un filtrage Softmax conditionné par le régime (détaillé dans notre article dédié à la pondération dynamique des régimes par Synergy AI), étouffant le bruit médiatique durant les heures diffusives calmes et rehaussant le poids de 𝐳tnews lors des chocs de sauts à forte surprise. - Moteur 4 · Navigator AI (𝒩Nav, répondant au « Que faire ») : Résout une optimisation prescriptive déterministe sur la surface de probabilité réconciliée afin de tracer une unique feuille de route graphique falsifiable ℛt :
Buy zoneouSell zoneexplicite, frontière structurelle d’invalidation (Pivot), échelle étagée deProfit zone(TP1àTP5),Reverse zoneconditionnelle et flèches directionnellesGreen Arrows.
Revenons à notre analogie du journaliste de presse écrite. Dans l’Équation (6), nous recrutons le journaliste (Sentiment AI) dans le seul but de lire les dépêches urgentes en cinquante millisecondes, de coter si le ton d’une banque centrale est restrictif (hawkish) ou accommodant (dovish) et de retrouver dans les archives les précédents historiques analogues. Nous ne laissons jamais le journaliste toucher aux équations différentielles ! Toute la mathématique des trajectoires, la pondération des régimes et la géométrie des stop-loss sont résolues en aval par des moteurs quantitatifs dédiés (Forecast AI, Synergy AI et Navigator AI).
Cette division du travail se prolonge à l’échelle de l’ensemble de l’écosystème ForecastCity à neuf moteurs d’IA spécialisés. Les interfaces conversationnelles d’accompagnement telles qu’AI Trading Assistant aident les utilisateurs à naviguer parmi les outils de l’espace de travail ou à traduire en langage clair des règles écrites de stratégie, tandis qu’AI Strategy Studio, Virtual Accounts et 4CastMachine AI exécutent des calculs quantitatifs 100 % déterministes sur les bougies historiques et en direct. Le Tableau 2 récapitule la répartition stricte des tâches entre IA linguistique et IA quantitative continue.
| Tâche du système financier | Modalité mathématique | Paradigme d’IA approprié | Conséquence d’un mauvais usage d’un LLM génératif |
|---|---|---|---|
| Analyse des communiqués de banques centrales et titres macroéconomiques | Langage naturel discret non structuré Dt ∈ 𝒱* | NLP financier adapté au domaine / LLM encodeur (Sentiment AI) |
Domaine valide dès lors que la sortie est restreinte à des scalaires calibrés de polarité et d’analogie historique |
| Supports/résistances multi-unités de temps, harmoniques et probabilités de bougies | Tenseur réel continu 𝐗t-L:t ∈ ℝL×d | Modèles en espace d’états continu et estimateurs d’amplitude (Forecast AI) |
Distorsion métrique BPE, chute de précision de 65% sous distracteurs [7] et niveaux de support/résistance inventés |
| Arbitrage entre structure technique et vélocité des dépêches en direct | Espace conjoint sauts-diffusion et intensité de Hawkes | Mélange d’experts continu par filtrage Softmax (Synergy AI) |
Bascules narratives arbitraires ; biais de récence en faveur du dernier titre mentionné dans le prompt |
| Spécification des zones d’entrée, de l’invalidation Pivot et de TP1-TP5 | Optimisation du risque sous contrainte de temps d’arrêt | Optimisation graphique prescriptive (Navigator AI) |
Prose non falsifiable, absence de bornes d’invalidation et risque de ruine par drawdown asymétrique |
6. Preuves graphiques en direct : feuilles de route déterministes Quad-AI sur BTCUSD (D) et XAUUSD (4h) face à la dérive narrative générative
Pour rendre concret le contraste entre la prose conversationnelle d’un LLM et la prévision quantitative déterministe, examinons deux graphiques de production en direct capturés depuis 4CM-AI Charts sur deux classes d’actifs et deux unités de temps distinctes : le Bitcoin (BTCUSD) sur l’horizon journalier (D) et l’Or (XAUUSD) sur l’horizon quatre heures (4h).
Observons d’abord ce qui se passe lorsqu’un trader ou un animateur sur les réseaux sociaux sollicite un LLM généraliste (ou téléverse une image brute de chandeliers) pour obtenir une perspective sur le Bitcoin alors que BTCUSD s’échange près de 64,570.00 après un repli depuis un sommet d’automne voisin de 87,000. D’une requête répétée à l’autre, les modèles conversationnels se scindent en récits inconciliables. Une première exécution se focalise sur les longues bougies rouges de novembre et annonce un effondrement imminent vers $50,000 ; une deuxième exécution récite les thèmes macroéconomiques d’adoption institutionnelle du Bitcoin et proclame une reprise verticale immédiate en V vers $90,000 ; une troisième exécution invente des seuils approximatifs de Fibonacci qui ne correspondent ni au sommet ni au creux réels inscrits sur la bande des prix. Aucun de ces paragraphes ne définit une borne exacte d’invalidation ni ne réconcilie le désaccord entre les unités de temps intraday et la tendance journalière.
Examinons maintenant la Figure 3, qui affiche la feuille de route déterministe de 4CastMachine AI sur BTCUSD (D), calculée à partir des coordonnées continues exactes OHLCV et réconciliée à travers l’ensemble des unités de temps.
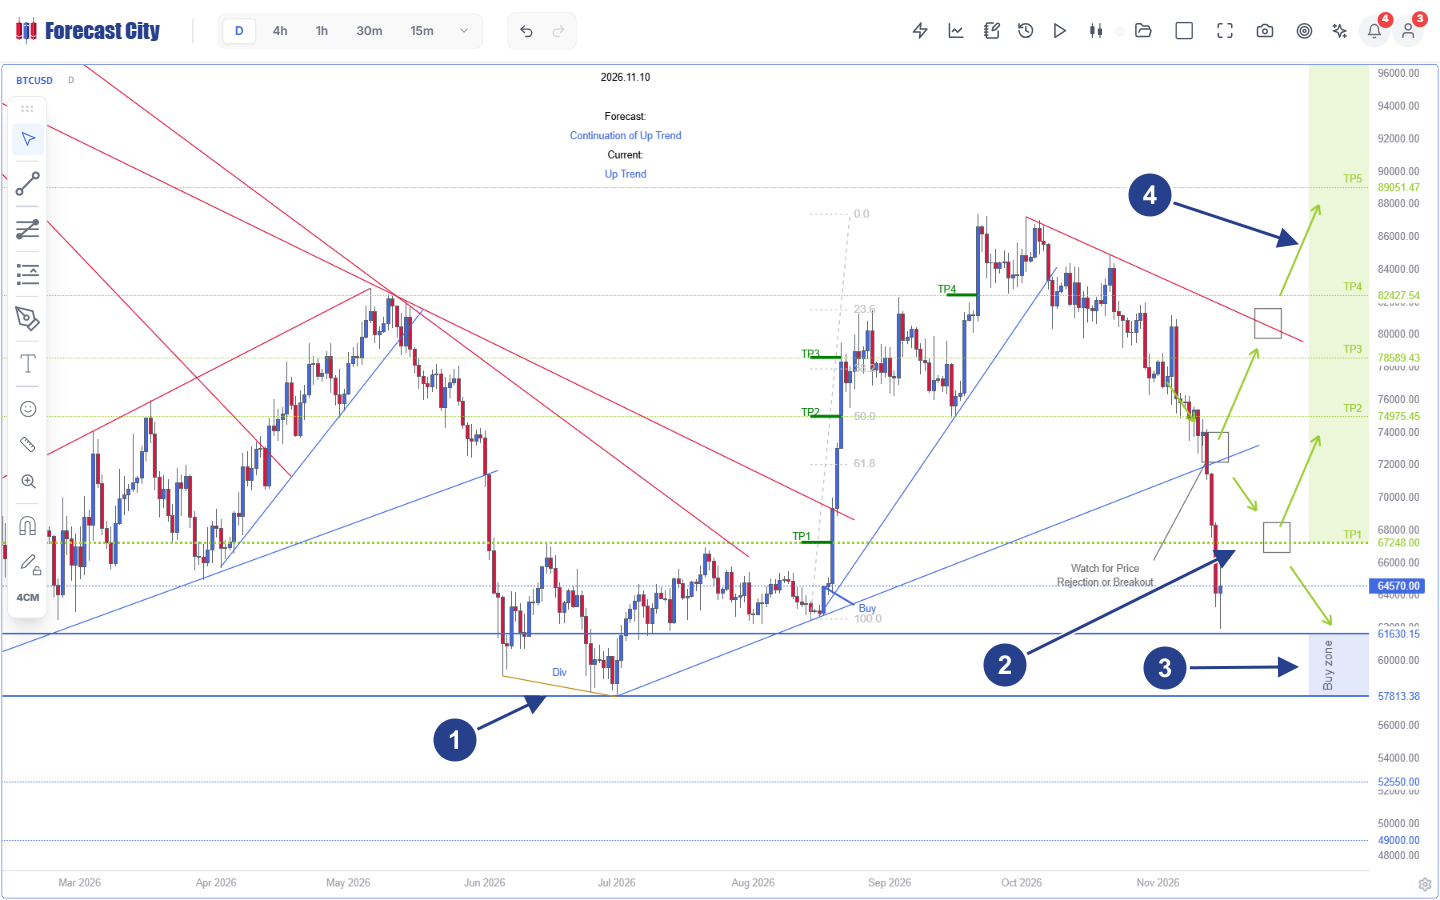
BTCUSD, unité de temps journalière D, cours spot 64,570.00) : Contrairement à la génération stochastique de texte qui dérive d’une requête à l’autre, Quad-AI projette une géométrie de coordonnées exacte et reproductible, ancrée sur des points d’inflexion historiques audités et sur des nœuds décisionnels conditionnels explicites.
- 1Socle structurel audité (
Divet jambe de Fibonacci100.0-0.0) : Divergence haussière de juin-juillet à57,813.38suivie du setup d’achatBuyd’août qui a franchi séquentiellement les objectifs historiquesTP1,TP2,TP3etTP4. - 2Nœuds décisionnels conditionnels : Trois embranchements explicites
Watch for Price Rejection or Breakoutle long du support oblique bleu rompu et de la ligne de tendance de résistance rouge descendante, remplaçant la prose vague par des conditions géométriques vérifiables. - 3
Buy zonequantifiée (57,813.38-61,630.15) : Bande exacte de demande institutionnelle située sous le cours au comptant de64,570.00, épaulée par des planchers structurels inférieurs à52,550.00et49,000.00. - 4Échelle étagée de
Profit zone(TP1-TP5) : Objectifs haussiers reproductibles situés àTP1 = 67,248.00,TP2 = 74,975.45,TP3 = 78,589.43,TP4 = 82,427.54etTP5 = 89,051.47.
Observons attentivement la cohérence multi-unités de temps qui sous-tend la Figure 3. Au cours spot de 64,570.00, des replis correctifs de court terme sont actifs sur les horizons inférieurs (30m baissier sous 66,422.24, 1h baissier sous 67,566.58 et 4h baissier sous 72,769.47), tandis que la structure macroéconomique hebdomadaire demeure haussière au-dessus de 48,879.14 et que la continuation journalière redevient pleinement haussière au-dessus de 67,248.00 (TP1). Au lieu de deviner au hasard si la bougie rouge de repli s’arrêtera à 64,570.00 ou ira d’abord chercher plus bas, Navigator AI cartographie explicitement les deux branches : soit le prix teste la Buy zone comprise entre 57,813.38 et 61,630.15 et y inscrit un rejet haussier, soit il reconquiert directement le nœud décisionnel à 67,248.00 pour relancer l’ascension principale vers 74,975.45 (TP2) et 89,051.47 (TP5).
L’écart entre l’intuition visuelle approximative de Gestalt et le calcul continu de coordonnées devient plus manifeste encore sur les unités de temps intraday telles que 4h, où l’intersection d’obliques, les inversions de polarité et les seuils serrés d’invalidation exigent une précision au centime de dollar près. La Figure 4 présente l’Or (XAUUSD) sur l’unité de temps 4h au cours au comptant de 3,879.59.
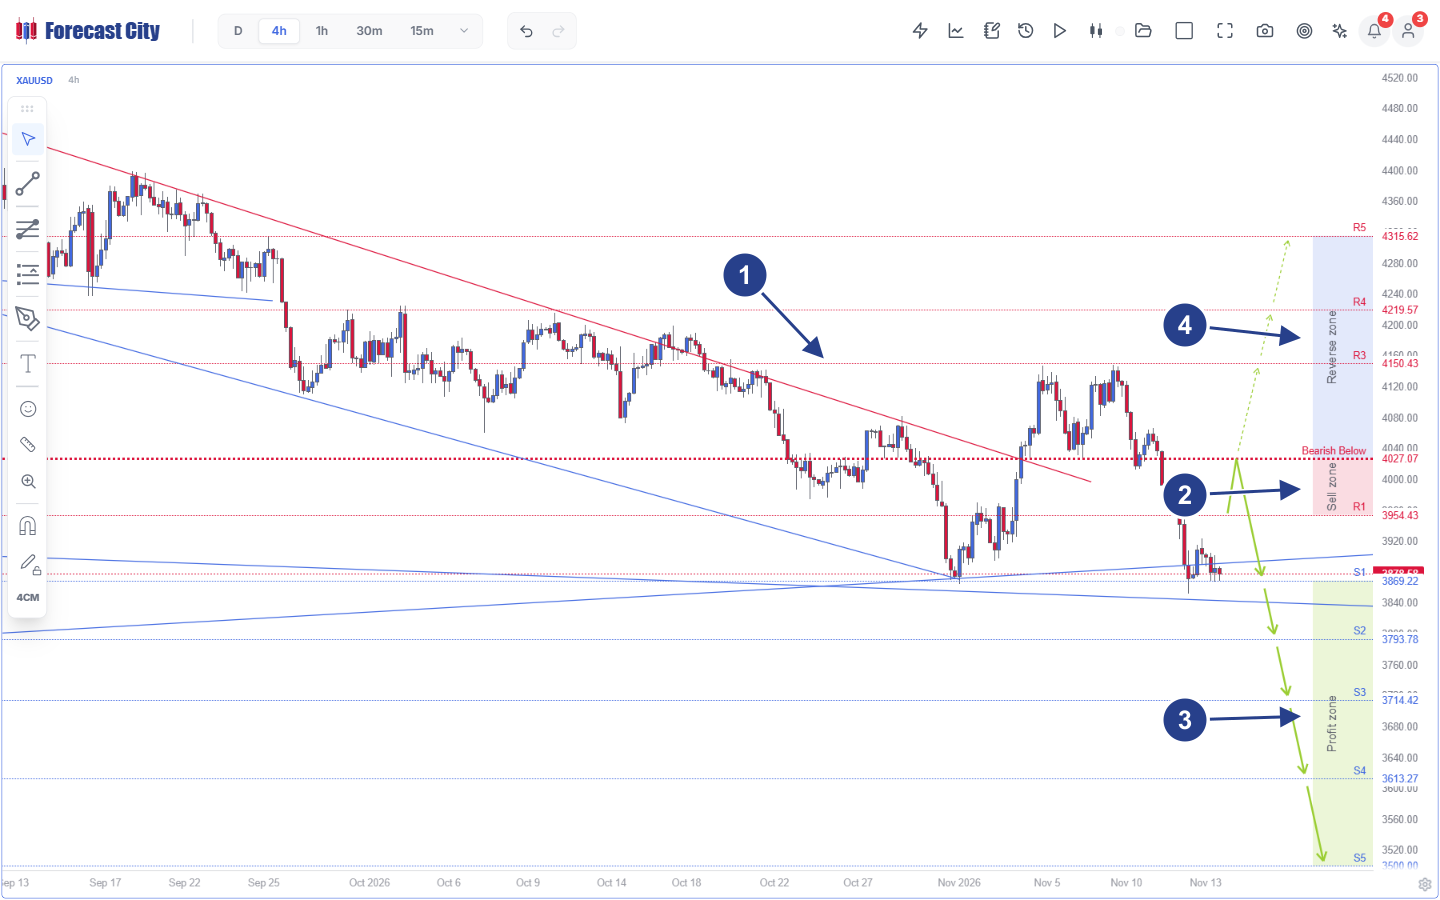
XAUUSD, unité de temps 4h, cours spot 3,879.59) : Là où les encodeurs par patchs des VLM multimodaux estompent les rejets fins sur mèches et la géométrie d’éventails sécants, Quad-AI résout les coordonnées exactes à double scénario depuis R5 (4,315.62) jusqu’à S5 (3,500.00).
- 1Géométrie d’ondes et d’obliques sur plusieurs semaines : Ligne de résistance rouge descendante issue de septembre franchie début novembre, suivie d’un rejet en double sommet sous
4,150.43et d’une cassure ramenant les cours sur l’éventail convergent de supports bleus près de3,869.22. - 2
Sell zoneet invalidation stricte parPivot: Zone supérieure d’offre sur rebond débutant àR1 = 3,954.43et strictement invalidée au-dessus du seuilBearish Below 4,027.07. - 3
Green Arrowsprimaires etProfit zone(S1-S5) : Trajectoire baissière primaire ciblantS1 = 3,869.22,S2 = 3,793.78,S3 = 3,714.42,S4 = 3,613.27etS5 = 3,500.00. - 4
Reverse zoneconditionnelle (R3-R5) : Scénario haussier alternatif pré-calculé (Dashed Arrows) en direction deR3 = 4,150.43,R4 = 4,219.57etR5 = 4,315.62si et seulement si le prix invalide le seuil de4,027.07.
Comparons l’exécution du risque en capital sur l’état XAUUSD 4h en direct de la Figure 4 (cours spot 3,879.59) selon les deux paradigmes :
1. Mode de défaillance du LLM / VLM conversationnel : En voyant l’Or décrocher brutalement de 4,145 jusqu’à 3,879.59, un modèle conversationnel soit poursuit impulsivement le mouvement baissier au marché à 3,879.59 directement sur le support de l’éventail bleu S1 = 3,869.22 (exposant une vente à découvert à un contre-pied haussier immédiat de $75 à $147), soit déclare l’Or « en survente » sans fournir le moindre prix structurel d’invalidation. Interroger dix fois le modèle produit dix valeurs différentes de stop-loss assorties d’une assurance verbale non calibrée [4, 14].
2. Géométrie d’exécution déterministe de Quad-AI : Au cours spot de 3,879.59, le prix n’évolue qu’à $10.37 au-dessus de S1 = 3,869.22 tout en se situant à $147.48 sous le Pivot d’invalidation 4,027.07, de sorte qu’une vente immédiate au marché présente un ratio rendement/risque dégradé de 10.37 / 147.48 = 0.070 jusqu’à S1. Attendre un rebond technique jusqu’au point médian de la Sell zone (3,990.75, exactement à mi-chemin entre R1 = 3,954.43 et Pivot = 4,027.07) comprime la distance au stop structurel à 4,027.07 - 3,990.75 = $36.32 tout en portant le potentiel baissier jusqu’à S2 = 3,793.78 à $196.97 (ratio rendement/risque de 5.42 : 1) et jusqu’à S3 = 3,714.42 à $276.33 (ratio rendement/risque de 7.61 : 1). Chaque coordonnée se reproduit au centime près sur 100 évaluations sur 100. Les lecteurs peuvent approfondir les règles systématiques d’exécution de ces zones dans le cours Trend Hunter Strategy de la ForecastCity Academy et consulter l’ensemble des références mathématiques sur la page Sources de l’Academy.
Questions fréquentes
Le réglage temperature = 0 ou le recours au Chain-of-Thought rend-il un LLM fiable pour la prévision quantitative des marchés ?
Non. Atil et al. [4] ont démontré que même à temperature = 0 avec des graines aléatoires fixes, les LLM de pointe présentent jusqu’à 10% à 15% de dérive des réponses entre exécutions identiques, car les réductions matricielles en virgule flottante 16 bits sur des GPU à mise en lots dynamique ne sont pas associatives et font basculer les logits ex aequo par cascade autorégressive. Quant aux invites de raisonnement pas à pas (Chain-of-Thought), elles opèrent toujours sur des tokens numériques fragmentés par BPE, où Apple Research (GSM-Symbolic [7]) a mesuré jusqu’à 65% d’effondrement de la précision dès que les constantes numériques varient ou qu’une simple proposition contextuelle non pertinente s’ajoute à l’énoncé.
Pourquoi les modèles multimodaux vision-langage (VLM) échouent-ils lorsqu’on leur fournit des captures d’écran nettes de graphiques en bougies ?
Les VLM multimodaux découpent les images de graphiques en pavés grossiers de 14×14 ou 16×16 pixels, puis les projettent à travers un adaptateur linéaire avec perte dans l’espace des tokens du langage naturel. S’ils reconnaissent des silhouettes qualitatives de vagues à la manière d’un coup d’œil humain rapide, les tests de référence de Hu et al. [8] montrent qu’ils perdent les proportions exactes des mèches OHLC, ignorent le changement d’échelle de volatilité ATR, affichent un fort biais haussier inconditionnel et voient leur coefficient d’information tomber près de zéro dans les marchés latéraux ou volatils face aux modèles quantitatifs opérant directement sur des tenseurs OHLCV en virgule flottante IEEE-754.
Pourquoi certains backtests viraux sur les réseaux sociaux prétendent-ils que ChatGPT ou GPT-4 ont battu des indices boursiers ou crypto ?
Sarkar et Vafa à l’Université de Chicago et à Harvard [11] ont prouvé que les backtests historiques réalisés sur des LLM pré-entraînés sur étagère souffrent d’une contamination sévère par biais d’anticipation (look-ahead bias) : les poids du réseau ont implicitement mémorisé les résultats d’entreprises, les chocs macroéconomiques et les trajectoires d’actifs survenus avant la date de coupure des connaissances du modèle. Lorsqu’ils sont évalués rigoureusement hors échantillon sur des bougies en direct inédites ou soumis à des ablations contrôlées (Tan et al., NeurIPS 2024 [1] ; Xie et al. [10]), les squelettes linguistiques pré-entraînés n’apportent aucun avantage de prévision numérique par rapport à des modèles quantitatifs dédiés.
Comment 4CastMachine AI exploite-t-il les modèles de langage dans Sentiment AI sans exposer les traders aux hallucinations numériques ?
4CastMachine AI impose un pare-feu sémantique strict au cœur de son architecture Quad-AI. Les modèles de langage financier contextuels intégrés à Sentiment AI servent exclusivement à lire les dépêches d’actualité non structurées, à coter la polarité directionnelle et à mesurer la similarité sémantique avec des événements macroéconomiques historiques, en n’émettant que des scalaires numériques bornés [pt, ze,t, sim, λt]. Aucun LLM ne génère jamais d’objectifs de prix : toutes les densités continues de probabilité, les pondérations dynamiques de régime et les zones graphiques sont calculées de manière déterministe par Forecast AI, Synergy AI et Navigator AI.
Références académiques et sectorielles
- [1]Tan, M., Merrill, M. A., Gupta, V., Althoff, T., & Hartvigsen, T. (2024). Are Language Models Actually Useful for Time Series Forecasting? Advances in Neural Information Processing Systems (NeurIPS 2024 Spotlight), 37.
- [2]Kalai, A. T., & Vempala, S. S. (2024). Calibrated Language Models Must Hallucinate. Proceedings of the 56th Annual ACM Symposium on Theory of Computing (STOC 2024), 160-171.
- [3]Xu, Z., Jain, S., & Kankanhalli, M. (2024). Hallucination is Inevitable: An Innate Limitation of Large Language Models. arXiv preprint arXiv:2401.11817.
- [4]Atil, B., Chittams, A., Fu, L., Ture, F., Xu, L., & Baldwin, B. (2024). LLM Stability: A Detailed Analysis with Some Surprises. arXiv preprint arXiv:2408.04667.
- [5]Singh, A. K., & Strouse, D. J. (2024). Tokenization Counts: The Impact of Tokenization on Arithmetic in Frontier LLMs. arXiv preprint arXiv:2402.14903.
- [6]Dziri, N., Lu, X., Sclar, M., Li, X. L., Jiang, L., Lin, B. Y., ... & Choi, Y. (2023). Faith and Fate: Limits of Transformers on Compositionality. Advances in Neural Information Processing Systems (NeurIPS 2023), 36, 70293-70332.
- [7]Mirzadeh, I., Alizadeh, K., Shahrokhi, H., Tuzel, O., Bengio, S., & Farajtabar, M. (2024). GSM-Symbolic: Understanding the Limitations of Mathematical Reasoning in Large Language Models. Apple Machine Learning Research / ICLR 2025, arXiv:2410.05229.
- [8]Hu, K., Xiao, L., Xu, S., Tang, Z., & Liu, M. (2026). Do VLMs Truly "Read" Candlesticks? A Multi-Scale Benchmark for Visual Stock Price Forecasting. arXiv preprint arXiv:2604.12659.
- [9]Jiang, J., Kelly, B., & Xiu, D. (2023). (Re-)Imag(in)ing Price Trends. The Journal of Finance, 78(6), 3193-3249.
- [10]Xie, Q., Han, W., Lai, Y., Peng, M., & Huang, J. (2023). The Wall Street Neophyte: A Zero-Shot Analysis of ChatGPT Over MultiModal Stock Movement Prediction Challenges. arXiv preprint arXiv:2304.05351.
- [11]Sarkar, S. K., & Vafa, K. (2024). Lookahead Bias in Pretrained Language Models. University of Chicago & Harvard University Working Paper, SSRN 4754678 / arXiv:2402.02092.
- [12]Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., ... & Perez, E. (2024). Towards Understanding Sycophancy in Language Models. International Conference on Learning Representations (ICLR 2024).
- [13]Wen, J., Zhong, R., Khan, A., Perez, E., Steinhardt, J., Huang, M., ... & He, H. (2025). Language Models Learn to Mislead Humans via RLHF. International Conference on Learning Representations (ICLR 2025), arXiv:2409.12822.
- [14]Xiong, M., Hu, Z., Lu, X., Li, Y., Fu, J., He, J., & Hooi, B. (2024). Can LLMs Express Their Uncertainty? An Empirical Evaluation of Confidence Elicitation in LLMs. International Conference on Learning Representations (ICLR 2024).
- [15]Zeng, A., Chen, M., Zhang, L., & Xu, Q. (2023). Are Transformers Effective for Time Series Forecasting? Proceedings of the AAAI Conference on Artificial Intelligence, 37(9), 11121-11128.
- [16]Gneiting, T., & Raftery, A. E. (2007). Strictly Proper Scoring Rules, Prediction, and Estimation. Journal of the American Statistical Association, 102(477), 359-378.
- [17]Loughran, T., & McDonald, B. (2011). When Is a Liability Not a Liability? Textual Analysis, Dictionaries, and 10-Ks. The Journal of Finance, 66(1), 35-65.
- [18]Araci, D. (2019). FinBERT: Financial Sentiment Analysis with Pre-trained Language Models. arXiv preprint arXiv:1908.10063.