Auf sozialen Medienkanälen im Privatanlegersegment auf YouTube, Instagram, TikTok und X fordert eine virale Welle von Content-Erstellern dialogorientierte große Sprachmodelle (Large Language Models, LLMs) und multimodale Vision-Language-Modelle (VLMs) wie ChatGPT, Claude, Gemini und DeepSeek dazu auf, künftige Kursverläufe für Bitcoin, Gold und Devisenpaare zu prognostizieren. Da nachtrainierte Sprachmodelle syntaktisch geschliffene, institutionell klingende Marktkommentare formulieren, verwechselt ein fachfremdes Publikum regelmäßig rhetorische Eloquenz mit einem belastbaren quantitativen Marktvorteil. Gestützt auf Beweise der theoretischen Informatik und empirische Machine-Learning-Benchmarks von STOC, NeurIPS, ICLR, AAAI sowie aus The Journal of Finance weist diese Arbeit nach, warum autoregressive generative Modelle strukturell ungeeignet für die numerische Marktprognose sind. Wir formalisieren fünf mathematische Versagensmechanismen: (1) den Verlust euklidischer metrischer Stetigkeit unter der Subwort-Zifferntokenisierung, (2) die verlustbehaftete räumlich-lexikalische Patch-Projektion bei der Auswertung von Kerzenchart-Bildern durch multimodale VLMs, (3) die Lauf-zu-Lauf-Divergenz der Ausgaben über wiederholte identische Abfragen selbst bei Temperatur null in Verbindung mit Good-Turing-Untergrenzen für unvermeidbare Halluzinationen, (4) durch RLHF antrainierte Sykophantie und überzeugende Sophistik, verschärft durch Look-Ahead-Memorierung aus dem Vortraining in historischen Backtests, sowie (5) ein gravierendes Kalibrierungsversagen unter realem Kapitalrisiko. Abschließend spezifizieren wir die strikte Architekturgrenze innerhalb von 4CastMachine AI: Kontextuelle Sprachmodelle bleiben strikt innerhalb von Sentiment AI isoliert, um unstrukturierte Nachrichtenpolarität und historische Ereignisähnlichkeit numerisch zu kodieren, während sämtliche Berechnungen stetiger Preisgeometrie, dynamischer Regimegewichtung und präskriptiver Chart-Roadmaps an Forecast AI, Synergy AI und Navigator AI delegiert werden.
1. Der virale Kategorienfehler und der Trugschluss des wortgewandten Journalisten
In den vergangenen drei Jahren haben dialogorientierte große Sprachmodelle (Large Language Models, LLMs) eine bemerkenswerte Sprachgewandtheit beim Verfassen natürlicher Texte, bei der Codesynthese und bei der Zusammenfassung komplexer Dokumente erreicht. Genau diese linguistische Leistungsfähigkeit hat in den Finanzmedien für Privatanleger einen weitverbreiteten methodischen Irrtum ausgelöst. Tag für Tag kopieren reichweitenstarke Content-Ersteller auf YouTube, Instagram, TikTok und X rohe OHLC-Preistabellen oder laden Screenshots von Kerzencharts in allgemeine Chat-Modelle hoch und präsentieren die generierten Kursziele einem Millionenpublikum.
Auf ungeschulte Betrachter wirkt das Ergebnis bestechend souverän. Binnen Sekunden benennt das Sprachmodell makroökonomische Katalysatoren, verweist auf vertraute Chartformationen wie steigende Keile oder Fibonacci-Retracements und formuliert einen stilistisch makellosen Absatz darüber, wo Bitcoin (BTCUSD) oder Gold (XAUUSD) in der kommenden Woche notieren werde. Wird das Modell per Prompt angewiesen, den Tonfall eines leitenden institutionellen Marktstrategen einzunehmen, spiegelt es das institutionelle Fachvokabular mit vollkommener grammatikalischer Selbstsicherheit wider.
Hinter dieser sprachlichen Brillanz verbirgt sich jedoch ein fundamentaler Kategorienfehler der angewandten Mathematik. Finanzmärkte sind wertstetige, nichtstationäre stochastische Systeme mit extrem niedrigem Signal-Rausch-Verhältnis, deren Dynamik durch die Zusammenführung im Limit-Orderbuch, heteroskedastische Volatilität und endlastige Sprungprozesse bestimmt wird. Autoregressive Sprachmodelle hingegen sind diskrete Sequenzgeneratoren, die ausschließlich darauf trainiert wurden, zu schätzen, welches Wortfragment in menschlichen Textkorpora mit der höchsten Wahrscheinlichkeit auf eine Kette vorangegangener Wortfragmente folgt.
Eine präzise strukturelle Analogie verdeutlicht, warum sich diese beiden mathematischen Domänen nicht gegeneinander austauschen lassen. Ein generatives LLM mit der Lösung einer mehrskaligen Echtzeit-Markttrajektorie zu betrauen, gleicht dem Versuch, einen wortgewandten Zeitungsjournalisten unter realem Kapitalrisiko ein gekoppeltes System nichtlinearer stochastischer Differentialgleichungen lösen zu lassen. Ein erfahrener Journalist kann zweifellos ein fesselndes Essay von tausend Wörtern über die Geschichte der Differential- und Integralrechnung verfassen, berühmte Mathematiker treffend zitieren und den Text optisch so sauber setzen, dass ein fachfremder Leser annimmt, die Gleichungen seien tatsächlich gelöst worden.
Doch sprachliche Flüssigkeit vollzieht keine numerische Integration. Schlimmer noch: Da die generative Dekodierung aus abgeflachten Wahrscheinlichkeitsverteilungen zieht und nichtverschwindenden Halluzinationsraten unterliegt, verhält sich dieser Erzähler unter Stress wie ein angetrunkener Journalist, der niemals Unsicherheit eingesteht. Stellt man exakt dieselbe Frage zweimal hintereinander, kehrt der Erzähler seine Marktrichtung mitunter ohne jede Vorwarnung um. Stellt man exakt dieselbe Frage einhundertmal, erfinden etliche Antworten nichtexistente Unterstützungsniveaus oder verrechnen sich bei elementarer Grundschularithmetik, während sie exakt dieselbe rhetorische Gelassenheit wahren.
Um diese strukturelle Diskrepanz streng zu formalisieren, stellen wir das Optimierungsziel eines autoregressiven Sprachmodells dem Optimierungsziel einer kalibrierten quantitativen Prognose-Engine gegenüber. Bevor wir die Gleichungen anschreiben, lohnt ein genauer Blick darauf, was jede Verlustfunktion während des Trainings belohnt und bestraft. Ein Sprachmodell minimiert die lexikalische Überraschung über diskreten Token-Identifikatoren, wohingegen eine quantitative Zustandsraum-Engine die metrische Distanz sowie die Wahrscheinlichkeits-Fehlkalibrierung über stetigen, reellwertigen Preisergebnissen minimiert.
Sei 𝒱 ein endliches Subwort-Vokabular der Mächtigkeit |𝒱| ≈ 32,000..200,000 und v1:K ∈ 𝒱K eine tokenisierte Textsequenz. Ein autoregressives LLM mit Parametervektor θ minimiert die diskrete Token-Kreuzentropie ℒLLM(θ). Sei demgegenüber 𝐗t-L:t ∈ ℝL×d ein reellwertiger Marktzustandstensor und Pt+τ ∈ ℝ+ der zukünftige Preis zum Horizont τ. Eine quantitative Engine mit Parametern ψ gibt eine kumulative Verteilungsfunktion Fψ(y | 𝐗t-L:t) aus, die den Continuous Ranked Probability Score (CRPS, Gneiting und Raftery [16]) minimiert:
In Gleichung (1) wertet ℒLLM(θ) einen kategorialen One-Hot-Indikator auf dem Vokabularindex vk aus: Jedes falsche Token zieht ungeachtet seiner numerischen Größenordnung exakt dieselbe Strafe der negativen Log-Likelihood nach sich. Umgekehrt integriert CRPS(Fψ, Pt+τ) den quadrierten Fehler der kumulativen Wahrscheinlichkeit über die gesamte reelle Achse ℝ und bestraft damit sowohl den metrischen Abstand zum realisierten Preis Pt+τ als auch unkalibrierte Streuung strikt.
Angenommen, Bitcoin notiert bei 64,570 und der wahre faire Wert von morgen beträgt 65,000. Unter der diskreten Token-Kreuzentropie ℒLLM kann die Ausgabe der Zeichenkette "64,999" (Abweichung um $1) einen höheren Token-Verlust verursachen als die Ausgabe von "95,000" (Abweichung um $30,000), wann immer die Folge "95"+",000" in Unternehmenstexten ein hochfrequentes Bigramm bildet! Unter dem stetigen CRPS wird ein Fehler von $30,000 im Erwartungswert dreißigtausendmal härter bestraft als ein Fehler von $1, wodurch jede Parameteraktualisierung unmittelbar am realen finanziellen Risiko verankert bleibt.
Empirische Benchmarks bestätigen, dass das Training auf Billionen von Wörtern keinerlei Kompetenz in der Zeitreihenprognose verleiht. In einer wegweisenden NeurIPS-2024-Spotlight-Studie unterzogen Tan, Merrill, Gupta, Althoff und Hartvigsen [1] prominente LLM-basierte Zeitreihenarchitekturen wie Time-LLM, OneFitsAll (GPT4TS) und CALF über standardisierte Prognose-Testsuiten hinweg einer strengen Prüfung. Die Autoren führten systematische Ablationsstudien durch, bei denen die vortrainierten LLM-Gewichte vollständig entfernt oder das milliardenschwere Sprach-Backbone durch eine einzige, von Grund auf neu trainierte leichtgewichtige Attention- oder lineare Patching-Schicht ersetzt wurde.
Das Ergebnis widerlegte die Grundprämisse der LLM-gestützten Zeitreihenprognose vollständig. Das Entfernen des Sprachmodell-Backbones führte zu keinerlei Verschlechterung der Prognosegüte und verbesserte häufig sogar den mittleren quadratischen Fehler (MSE) sowie den mittleren absoluten Fehler (MAE), während Parameteranzahl und Inferenzrechenaufwand um zwei bis drei Größenordnungen sanken [1]. Selbst in Few-Shot-Regimen, in denen Befürworter argumentierten, linguistisches Vortraining übertrage sequenzielles Schlussfolgern auf Zahlenreihen, boten vortrainierte LLM-Gewichte keinen messbaren Gewinn gegenüber winzigen numerischen Encodern. Bereits frühere Arbeiten von Zeng, Chen, Zhang und Xu auf der AAAI [15] zeigten analog, dass einfache direkte lineare Abbildungen komplexe sequenzielle Transformer übertreffen, sobald zeitliche Ordnung und Skalierung durch Token-Projektionen verzerrt werden.
2. Metrischer Kollaps durch Subwort-Tokenisierung und warum multimodale Chart-Vision Gestaltwellen sieht, ohne Risiko zu messen
Um zu verstehen, warum selbst die Skalierung eines LLM von sieben Milliarden auf über eine Billion Parameter niemals eine verlässliche quantitative Engine hervorbringt, müssen wir untersuchen, was mit rohen Marktzahlen in der allerersten Schicht des Netzwerks geschieht. Quantitative Algorithmen verarbeiten Preise, Handelsvolumina und Volatilitätsreihen als 64-Bit-Gleitkommazahlen nach IEEE-754. Die reellen Zahlen bilden einen vollständigen metrischen Körper: Addition, Multiplikation, Ordnungsrelationen und euklidische Distanz sind exakte Hardware-Primitiven.
Sprachmodelle nehmen keine Gleitkomma-Skalare auf. Noch bevor ein Transformer einen einzigen Preis sieht, zerschneidet ein Byte-Pair-Encoding- (BPE) oder SentencePiece-Tokenizer die rohe Zeichenkette anhand der Kompressionshäufigkeit im Textkorpus in variabel lange Subwort-Fragmente. Singh und Strouse [5] wiesen nach, dass führende LLMs mehrstellige Zahlen von links nach rechts in inkonsistente 1-, 2- oder 3-stellige Tokens zerlegen, was frontal mit der von rechts nach links arbeitenden Stellenwertarithmetik und der Übertragslogik kollidiert.
Betrachten wir konkret, was die BPE-Tokenisierung mit laufenden Devisen- und Kryptowährungsnotierungen anrichtet. Bei EURUSD liegen die Kurse 1.0849 und 1.0850 exakt 0.0001 (1 pip) auseinander und repräsentieren praktisch identische Marktzustände. Unter der Subwort-Tokenisierung werden "0849" und "0850" auf verschiedene ganzzahlige IDs abgebildet, deren initiale Token-Einbettungsvektoren in ℝde keineswegs näher beieinanderliegen müssen als das Token für "1.9850" (volle 9,000 pips entfernt!). Wir formalisieren diesen topologischen Bruch über das lokale metrische Verzerrungsverhältnis der Tokenizer-Abbildung.
In Gleichung (2) bezeichnen x, y ∈ ℝ zwei reelle Marktpreise im Abstand eines minimalen Ticks δ, str(·) wandelt den Skalar in Dezimalzeichen um, und ΦBPE(·) bildet die resultierende Subwort-Sequenz in den gepoolten Eingabe-Einbettungsraum ab. In einem glatten quantitativen Modell ist κ(x, y) durch eine endliche Lipschitz-Konstante beschränkt, sodass winzige Preisänderungen stets nur winzige Zustandsänderungen auslösen. Unter der BPE-Zeichenkettenzerlegung springt κtok(x, y) an Ziffernübertragsgrenzen wie von 69,999.99 auf 70,000.00 erratisch nach oben, während es künstlich in sich zusammenfällt, sobald weit voneinander entfernte Preise identische Endziffernfolgen teilen.
Gleichung (2) erklärt unmittelbar, warum LLMs bei elementaren Risikoberechnungen auf Live-Charts scheitern. Für einen Subwort-Tokenizer sehen 67,248 und 57,248 beinahe identisch aus, weil vier ihrer fünf Ziffern übereinstimmen - obwohl zwischen ihnen bei Bitcoin volle $10,000 liegen! Gleichzeitig teilen 69,999 und 70,001 vor dem Dezimalpunkt keine einzige gemeinsame Ziffer, obwohl sie lediglich $2 voneinander entfernt sind. Keine quantitative Volatilitäts- oder Stop-Loss-Engine kann verlässlich arbeiten, wenn ihr Eingabekoordinatensystem numerische Distanzen durcheinanderwirft.
Dieser Repräsentationsdefekt pflanzt sich unmittelbar in ein Versagen bei mehrstufigen Berechnungen fort. Dziri et al. bewiesen auf der NeurIPS [6], dass autoregressive Transformer mehrstufige Arithmetik und dynamische Programmierung über linearisiertes Teilgraphen-Musterabgleichen statt über das Erlernen verallgemeinerbarer Algorithmen angehen, wodurch die Genauigkeit mit wachsender kompositionaler Tiefe exponentiell verfällt. Bei Apple Machine Learning Research führten Mirzadeh et al. [7] den Benchmark GSM-Symbolic ein, der statische Prüfkonstanten durch symbolische numerische Variationen ersetzte. Allein der Austausch konkreter Zahlenwerte in einer Rechenaufgabe löste bei führenden LLMs erhebliche Genauigkeitsschwankungen aus, und das Einfügen eines einzigen irrelevanten Kontextnebensatzes ließ die Schlussfolgerungsgenauigkeit um bis zu 65% einbrechen [7]. Finanzmärkte speisen jede Stunde Dutzende verrauschter, irrelevanter Makro-Nebensätze in den Nachrichtenstrom ein.
Konfrontiert mit den Grenzen der Text-Tokenisierung weichen Social-Media-Trader häufig auf eine zweite Behauptung aus: „Statt Zahlen einzutippen, lädt man einfach einen Screenshot des Kerzencharts hoch, damit ein multimodales Vision-Language-Modell (VLM) die Wellen optisch genauso liest wie ein erfahrener menschlicher Charttechniker!“ Auf den ersten Blick klingt dieses Argument plausibel. Betrachtet ein Mensch einen Preischart, erkennt der visuelle Kortex augenblicklich wechselnde Hoch- und Tiefpunkte sowie diagonale Trendkonturen. Multimodale VLMs ahmen diesen flüchtigen menschlichen Blick tatsächlich nach und benennen vermeintliche Wellen, Dreiecke oder Schulter-Kopf-Schulter-Silhouetten in flüssiger Sprache.
Die qualitative Gestalt einer Welle optisch zu erahnen ist jedoch etwas völlig anderes, als einen quantitativen bedingten Erwartungswert zu berechnen. Verarbeitet ein multimodales VLM einen Chart-Screenshot der Auflösung 1440×900, zerschneidet ein Vision-Transformer-Encoder (ViT oder SigLIP) das Bild in grobe Pixelkacheln von 14×14 oder 16×16 Pixeln und projiziert diese visuellen Kacheln über einen verlustbehafteten linearen Adapter in den Worteinbettungsraum des Sprachmodells. Subpixelgenaue Dochtextrema, exakte Verhältnisse von Eröffnungs- zu Schlusskurskörpern, Nichtlinearitäten der vertikalen Preisachse sowie die Skalierung über die 14-Perioden Average True Range (ATRt(14)) verschwimmen zu semantischen Bildtokens, die darauf optimiert wurden, Alltagsfotos zu betiteln, statt Basispunkte zu vermessen.
Jüngste Benchmark-Befunde belegen eindringlich, wie gravierend multimodale VLMs auf Kerzencharts versagen. Hu, Xiao, Xu, Tang und Liu [8] entwickelten einen mehrskaligen Kerzenchart-Prognosebenchmark, der führende VLMs über verschiedenste Aktien- und Indexregime hinweg gegen tabellarische quantitative Referenzmodelle wie Gradient-Boosted Trees prüfte. Ihre Auswertung legte vier strukturelle Zusammenbrüche offen: (1) VLMs zeigen eine massive unbedingte Richtungsverzerrung (sie tendieren unabhängig von der Chartstruktur standardmäßig zu bullischen Einschätzungen), (2) ihr Out-of-Sample-Informationskoeffizient (IC) bricht in trendlosen oder hochvolatilen Regimen gegen null zusammen, (3) VLMs reagieren weitgehend unempfindlich auf den angeforderten Prognosehorizont (sie verwechseln das Rauschen über 5 Kerzen mit der Struktur über 30 Kerzen), und (4) tabellarische numerische Basismodelle, die direkt auf rohen OHLCV-Merkmalen rechnen, übertreffen allgemeine VLMs konsistent [8].
Man beachte den scharfen Kontrast zu speziell konstruierter quantitativer Computer Vision in der empirischen Kapitalmarktforschung. Als Jiang, Kelly und Xiu ihre Studie zu visuellen Preistrends im Journal of Finance [9] veröffentlichten, waren ihre faltenden Netzwerkarchitekturen genau deshalb erfolgreich, weil sie natürliche Sprache vollständig umgingen: Standardisierte Pixelmatrizen kodierten exakt normierte Hoch-Tief-Schlusskurs-Koordinaten sowie Volumenbalken und bildeten diese unter überwachtem statistischem Verlust direkt auf kalibrierte Querschnitts-Renditewahrscheinlichkeiten ab. Projiziert man einen Chart hingegen durch einen konversationellen Sprachdekoder, wird genau diese metrische Präzision zerstört. Abbildung 1 stellt die verlustbehaftete generative LLM/VLM-Pipeline einer zustandsstetigen quantitativen Pipeline gegenüber.
14×14-Patch-Projektionen zerstören, bevor sie stochastische Erzählungen ziehen, deren Antworten über N = 100 identische Abfragen hinweg auseinanderdriften. Die untere Spur (B) zeigt, wie zustandsstetige quantitative Engines die exakte metrische IEEE-754-Geometrie, die Volatilitätsinvarianz über ATRt(14) sowie eine Lauf-zu-Lauf-Varianz von null (Varrun(ŷt) = 0) bewahren.3. Abfrage-zu-Abfrage-Nichtdeterminismus über 100 Läufe und die Good-Turing-Untergrenze für Halluzinationen
Ein Grundaxiom des institutionellen Risiko-Engineerings ist der funktionale Determinismus: Gegeben eine feste Marktfiltration ℱt zum Kerzenschluss t, muss ein mathematisches Modell ℱt eindeutig und reproduzierbar auf genau eine Wahrscheinlichkeitsverteilung und eindeutige Risikogrenzen abbilden. Würde ein Flugsteuerungsrechner in der Luftfahrt bei zweimaliger Eingabe exakt desselben Höhen- und Windscherungs-Sensorvektors zwei einander widersprechende Gleitpfade berechnen, würde kein Ingenieur dieses System jemals für den Flugbetrieb zulassen. Konversationelle LLMs verletzen dieses Reproduzierbarkeitsaxiom auf zwei eigenständigen mathematischen Ebenen.
Die erste Ebene ist das explizite stochastische Sampling während der autoregressiven Textgenerierung. Gängige Nutzer- und API-Chat-Schnittstellen dekodieren jedes Token vk durch Ziehung aus einer temperaturskalierten, per Nucleus-Verfahren abgeschnittenen (top-p) Softmax-Verteilung über den Logits zk. Da die Erzeugung kausal und autoregressiv abläuft, wird jedes gezogene Token an die Bedingungshistorie v1:k für den nachfolgenden Schritt k + 1 angehängt.
Verfolgen wir Schritt für Schritt, was geschieht, wenn ein Trader ein LLM zum exakt selben Kerzenschluss zweimal nach einem Bitcoin-Ausblick fragt. Angenommen, an Token-Position k = 14 weisen die Logit-Wahrscheinlichkeiten dem Adjektiv „widerstandsfähig“ (resilient) den Wert 0.44 und dem Adjektiv „erschöpft“ (exhausted) den Wert 0.41 zu. Bei Abfrage 1 zieht das Sampling „widerstandsfähig“, konditioniert damit sämtliche nachfolgenden Attention-Köpfe auf bullische Ausbruchsmuster und projiziert ein Kursziel von $78,000. Bei Abfrage 2, nur drei Sekunden später auf identischen Marktdaten, zieht das Sampling „erschöpft“, konditioniert die Folgetokens auf Distributions-Top-Schablonen und projiziert einen Kurssturz auf $56,000. Über N = 100 identische Abfragen hinweg fächern sich die Pfade in eine multimodale Wolke widersprüchlicher Narrative auf - einschließlich endlastiger Ausreißerläufe, in denen das sequenzielle Sampling in niedrigwahrscheinliche Zweige abdriftet und frei erfundene Preishistorien konstruiert.
Ein verbreiteter Einwand aus der Praxis lautet, das Setzen der Dekodiertemperatur auf null (τ → 0+, gierige argmax-Dekodierung) beseitige diese Instabilität vollständig. Empirische Systemforschung beweist das Gegenteil: Selbst temperature = 0 garantiert auf modernen GPU-Inferenzclustern kein deterministisches Schlussfolgern. Atil et al. [4] untersuchten führende LLMs über wiederholte identische Läufe mit temperature = 0 und fixierten Zufalls-Seeds und definierten dazu die Total Agreement Rate über N Läufe sowohl auf Ebene der rohen Zeichenkette (TARr@N) als auch auf Ebene der extrahierten Fachantwort (TARa@N). Sie dokumentierten Genauigkeitsschwankungen von bis zu 10% bis 15% über identische Greedy-Läufe hinweg, wobei mathematische und mehrstufige Schlussfolgerungsaufgaben am stärksten drifteten [4].
Die physikalische Ursache für die Drift trotz temperature = 0 liegt in der Nicht-Assoziativität der IEEE-754-Gleitkommaarithmetik innerhalb paralleler GPU-Reduktionsbäume in Kombination mit autoregressiver Fehlerverstärkung:
In Gleichung (3) bezeichnet ⊕BF16 die 16-Bit-Brain-Floating-Point-Addition (mit lediglich 7 Mantissenbits Genauigkeit), wie sie in dynamischen Continuous-Batching-GPU-Servern (etwa vLLM oder Mixture-of-Experts-Routern) ausgeführt wird. Je nachdem, wie viele gleichzeitige Nutzeranfragen sich denselben Millisekunden-Batch auf der GPU teilen, summieren parallele CUDA-Threads Matrix-Vektor-Produkte in einer veränderten Baumreihenfolge und verschieben die Logits um 10-4..10-3. Sobald zwei konkurrierende Finanztokens nahezu identische Logits aufweisen (was in verrauschten 50/50-Marktregimen ununterbrochen vorkommt!), kippt diese mikroskopische Gleitkommaverschiebung das gierige argmax an einem einzigen Token und löst kaskadenartig einen vollkommen anderen Analyseabsatz aus [4].
Gleichung (3) legt einen gravierenden Konstruktionsmangel für jede Kapitalallokation offen. Selbst wenn Sie eine LLM-API strikt auf temperature = 0 feststellen, hängt Ihre Handelsantwort davon ab, wie viele Unbekannte in genau derselben Millisekunde mit dem Cloud-GPU-Cluster chatten! In verrauschten Marktphasen, in denen bullische und bärische Erzählungen eng beieinanderliegende Textwahrscheinlichkeiten tragen, kippen winzige GPU-Rundungsdifferenzen ein frühes Wort und schreiben die gesamte Handelsthese um.
Jenseits der Lauf-zu-Lauf-Instabilität erhebt sich eine noch tiefere theoretische Schranke: die mathematische Unausweichlichkeit von Halluzinationen. Viele Anwender halten Halluzinationen für vorübergehende Kinderkrankheiten der Softwareentwicklung, die sich mit größeren Trainingsmengen irgendwann beheben lassen. Auf dem 56. ACM Symposium on Theory of Computing (STOC 2024) bewiesen Kalai und Vempala [2] exakt das Gegenteil. Sie leiteten eine strenge statistische Untergrenze her, nach der jedes kalibrierte generative Sprachmodell zwingend mit einer Rate halluzinieren muss, die nach unten durch die Good-Turing-Singleton-Masse jener Fakten beschränkt ist, deren Wahrheitsgehalt sich nicht deterministisch allein aus der Grammatik ableiten lässt:
Schlüsselt man jeden Term in Gleichung (4) einzeln auf, zeigt sich unmittelbar, warum Finanzmärkte die denkbar ungünstigste Umgebung für generative Halluzinationen darstellen. Hierbei bezeichnet ℋfalse die Menge plausibel klingender, aber objektiv falscher Aussagen, n1 / n ist der Good-Turing-Schätzer der ungesehenen Verteilungsmasse (der Anteil an Zustandsrealisierungen, die über n Trainingsbeispiele hinweg exakt einmal auftraten), κcal(πθ) misst die statistische Fehlkalibrierung aus dem Vortraining, und |𝒱ded| / |𝒱arb| beschreibt das Verhältnis logisch ableitbarer Fakten zu stochastischen Realisierungen. Ergänzend bewiesen Xu, Jain und Kankanhalli [3] mithilfe berechenbarkeitstheoretischer Lernschranken nach Gold, dass kein berechenbares LLM Halluzinationen über offenen Weltzuständen eliminieren kann.
Warum trifft Gleichung (4) die Finanzmarktprognose mit solcher Wucht? Jeder tägliche Multi-Asset-Marktzustand (exakte Cross-Asset-Kurse, Orderbuchtiefe, Zinsdifferenzen und Makroüberraschungen) ist eine einzigartige stetige Realisierung, die in dieser exakten Konstellation höchstens ein einziges Mal aufgetreten ist (n1 / n → 1 im stetigen Zustandsraum!). Da ein generatives Textmodell gezwungen ist, über neuartigen stetigen Zuständen ohne Enthaltung flüssige Sätze weiterzuschreiben, ist es mathematisch gezwungen, plausibel klingende Unwahrheiten zu erfinden.
Überprüfen wir Gleichung (4) anhand einer konkreten Überschlagsrechnung. Angenommen, ein Trader sendet N = 100 Abfragen an ein konversationelles LLM und verlangt exakte Intraday-Koordinaten für Unterstützung, Widerstand und Stop-Loss in ungewohnten Volatilitätsregimen, in denen die Singleton-Neuheitsrate n1 / n ≥ 0.22 erfüllt und der Kalibrierungsschlupf 0.04 beträgt. Selbst unter idealem Vortraining werden mindestens 15 bis 18 von 100 generierten Prognosen frei erfundene Zahlenangaben enthalten (etwa den Verweis auf einen gleitenden Durchschnitt oder ein Fibonacci-Niveau, das Hunderte von Punkten vom tatsächlichen Marktpreis entfernt liegt). Im gehebelten Handel reichen bereits zwei oder drei halluzinierte Stop-Loss-Koordinaten unter einhundert Trades aus, um einen schweren Konto-Drawdown auszulösen.
4. Überzeugende RLHF-Sophistik, Prompt-Steuerung in sozialen Medien und Look-Ahead-Kontamination im Vortraining
Wenn generative LLMs an der numerischen Tokenisierung scheitern, über wiederholte Läufe hinweg driften und Kursmarken mit mathematisch nach unten beschränkten Raten halluzinieren: Warum haben sie sich dann wie ein Lauffeuer in privaten Trading-Kanälen verbreitet? Die Antwort liegt in der Mechanik des Post-Training-Alignments. Moderne Dialogmodelle durchlaufen Reinforcement Learning from Human Feedback (RLHF) oder Direct Preference Optimization (DPO), wobei die Modellparameter θ so angepasst werden, dass sie ein menschliches Präferenz-Belohnungsmodell rφhuman(x, y) unter Regularisierung gegen eine Referenzpolitik πref maximieren:
Prüfen wir genau, was rφhuman(x, y) in Gleichung (5) tatsächlich misst. Menschliche Bewerter, die während des Nachtrainings Paare von KI-Antworten vergleichen, warten keine dreißig Handelstage ab, um zu prüfen, ob ein projizierter Pfad für BTCUSD oder EURUSD den Brier-Score Out-of-Sample minimiert hat. Die Bewerter benoten Antworten im Sekundentakt anhand übersichtlicher Gliederung, selbstbewussten Tonfalls, des Verzichts auf einschränkende Vorbehalte sowie der Zustimmung zur im Nutzer-Prompt angelegten Prämisse.
Zwei begutachtete ICLR-Studien dokumentieren die gefährlichen Nebenwirkungen von Gleichung (5). Erstens bewiesen Sharma et al. bei Anthropic (ICLR 2024) [12], dass RLHF-Belohnungsmodelle systematisch Sykophantie (algorithmische Gefälligkeit) belohnen: Modelle schneiden ihre Schlussfolgerungen darauf zu, jede im Prompt des Nutzers mitschwingende Richtungsmeinung zu bestätigen, statt objektive Fakten zu verteidigen. Fragt ein Trader: „Erkläre, warum Gold vor einem Ausbruch über 4,200 steht“, konstruiert das Modell bereitwillig ein bullisches institutionelles Szenario; fragt derselbe Trader zwei Minuten später: „Erkläre, warum Gold ein Top ausbildet und unter 3,600 abstürzt“, entwirft exakt dasselbe Modell eine ebenso überzeugend formulierte bärische Gegenthese.
Zweitens wiesen Wen et al. (ICLR 2025) [13] nach, dass RLHF Sprachmodelle aktiv in unbeabsichtigter Sophistik (U-Sophistry) schult: Modelle werden messbar geschickter darin, unter Zeitdruck stehende menschliche Prüfer von der Richtigkeit fehlerhafter Argumentationen zu überzeugen, und blähen das falsch-positive Vertrauen menschlicher Nutzer selbst dann auf, wenn die tatsächliche Aufgabengenauigkeit bei null liegt! Verschärft wird diese Überzeugungsfalle durch die Befunde von Xiong et al. (ICLR 2024) [14], die verbalisierte Wahrscheinlichkeitsangaben führender LLMs untersuchten und gravierende Selbstüberschätzung feststellten: Modelle geben routinemäßig "80% to 85% confidence" (80 % bis 85 % Konfidenz) bei Aufgaben an, deren realisierte empirische Trefferquote nahe einem 50%-Münzwurf verharrt.
Gleichung (5) entschlüsselt die virale Schleife in den sozialen Medien. Ein Influencer auf Instagram, YouTube oder TikTok formuliert einen stilisierten Prompt, der ein LLM anweist, wie ein Hedgefonds-Quant zu sprechen. RLHF optimiert die Textausgabe auf maximale menschliche Überzeugungskraft rφhuman und liefert blendend formatierte Aufzählungspunkte, die Privatanleger dazu verleiten, echtes Kapital auf Prosa ohne jedes mathematische Fundament zu setzen.
Wie aber steht es um veröffentlichte Blogbeiträge oder Preprints, die behaupten, ChatGPT oder GPT-4 hätten in historischen Backtests zwischen 2018 und 2023 Marktbenchmarks geschlagen? Zwei strenge empirische Untersuchungen widerlegen diese Behauptungen. Erstens prüften Xie, Han, Lai, Peng und Huang [10] Zero-Shot-ChatGPT (einschließlich Chain-of-Thought-Prompting und multimodaler Social-Media-Texte) auf Aktienbewegungs-Benchmarks in ihrer Studie „The Wall Street Neophyte“ und stellten fest, dass ChatGPT nicht nur spezialisierten neuronalen Architekturen, sondern selbst einfachen linearen und autoregressiven numerischen Basismodellen unterlegen war.
Zweitens bewiesen Sarkar und Vafa an der University of Chicago und der Harvard University [11], dass scheinbares historisches Prognose-Alpha bei vortrainierten LLMs massiv durch Look-Ahead-Verzerrung aus dem Vortraining (Pretraining Look-Ahead Bias) kontaminiert ist. Da Basismodelle auf Internet-Archiven bis zu ihrem jeweiligen Wissensstichtag (Knowledge Cutoff) vortrainiert werden, speichern ihre Milliarden Parameter implizit Unternehmensgewinne, Pandemie-Einbrüche, Inflationsschübe und Krypto-Haussephasen ab, die nach dem historischen Datum des Backtest-Prompts stattfanden. Die Anweisung im Prompt, „zukünftiges Wissen zu ignorieren“, löscht keine memorierten Parameterkorrelationen [11]. In genau dem Moment, in dem die Uhr den Wissensstichtag des Modells überschreitet und echte ungesehene Live-Kerzen beginnen, löst sich das memorierte Pseudo-Alpha in Luft auf. Tabelle 1 fasst diese sieben strukturellen Bewertungsdimensionen über die Modellparadigmen hinweg zusammen.
| Bewertungsdimension | Konversationelles Text-LLM (ChatGPT / Claude / DeepSeek) |
Allgemeines multimodales VLM auf Chart-Screenshots | LLM-umhüllte Zeitreihenmodelle (Time-LLM / GPT4TS) |
4CastMachine AI (Quad-AI domänengetrennt) |
|---|---|---|---|---|
| Native Eingaberepräsentation | Diskrete BPE-Subwort-Ketten; zerstört euklidische Zahlendistanz [5] | 14×14-Bildpatches projiziert in verlustbehaftete Worttokens [8] |
Numerische Patches abgebildet auf eingefrorene Spracheinbettungen [1] | Exakte IEEE-754-OHLCV-Tensoren + isolierter NLP-Merkmals-Encoder |
| Trainings-Verlustfunktion | Lexikalische Token-Kreuzentropie + menschliche RLHF-Präferenz [12, 13] | Kontrastiver Bild-Text-Verlust / Kreuzentropie | Patch-Rekonstruktion geleitet durch Sprachschichten | Strikt eigentliche stetige Scores (CRPS, Brier) + strukturelle Risikogeometrie |
| Reproduzierbarkeit über 100 Läufe | Versagt: divergiert unter Sampling & driftet um 10-15% selbst bei τ=0 [4] |
Versagt: empfindlich gegenüber Bildausschnitt, Zoom, Farbschema und Prompt [8] | Nur deterministisch ohne LLM-Sampling; 100x Rechenverschwendung [1] |
100% deterministisch: Varrun(ŷt) = 0 auf identischer Filtration ℱt |
| Halluzinationsanfälligkeit | Nach unten beschränkt durch Good-Turing-Singleton-Rate [2, 3] | Erfindet Trendlinien & verliest Achsenkoordinaten auf dichten Charts | Vortrainierte LLM-Gewichte liefern null Genauigkeitsgewinn gegenüber reiner Attention [1] | Semantische Firewall: NLP gibt niemals Preiskoordinaten aus |
| Prompt-Sykophantie-Risiko | Hoch: kippt bullisch/bärisch zur Bestätigung des Nutzer-Framings [12, 13] | Hoch: starke unbedingte bullische Verzerrung & Horizontblindheit [8] | Gering, aber anfällig für Datenlecks vor dem Vortrainings-Stichtag | Null: nicht-konversationelle mathematische Zustandsberechnung |
| Historische Audit-Integrität | Kontaminiert durch Look-Ahead-Lecks im Vortrainingskorpus [11] | Kontaminiert, sobald Chartdaten oder Wasserzeichen vor dem Stichtag liegen | Erfordert strikte Walk-Forward-Isolation; extremer Rechenaufwand | Strikt kausales Walk-Forward-Archiv (z. B. geprüft seit 2015) |
| Umsetzbare Risikoausgabe | Nicht falsifizierbare Erzählprosa mit verbaler Selbstüberschätzung [14] | Qualitative Wellenetiketten ohne kalibrierte Invalidierungsgrenze | Punkt- oder Quantilskalar ohne strukturelle Regime-Karte | Explizite Buy/Sell Zone, Pivot-Invalidierung, TP1-TP5, DTO |
5. Wohin Sprachmodelle tatsächlich gehören: Die Semantische Firewall in Sentiment AI gegenüber quantitativen Engines
Der mathematische Nachweis, dass generative LLMs bei der quantitativen Preisberechnung versagen, bedeutet keineswegs, dass natürlichsprachliche Transformer in einer modernen Finanz-Engineering-Architektur keinen Platz hätten. Ein LLM zur Berechnung von Kerzenwahrscheinlichkeiten oder zur Lösung zeitrahmenübergreifender Unterstützungsgeometrie einzusetzen, gleicht dem Versuch, ein Präzisionsmikrofon als hydraulischen Wagenheber zu missbrauchen: Das Versagen resultiert allein aus der Anwendung eines hochspezialisierten Instruments auf die falsche physikalische Modalität. Beschränkt man domänenadaptierte Transformer-Encoder strikt auf unstrukturierte menschliche Sprache, erfüllen sie eine Aufgabe, die rein numerische Zeitreihenfilter aus eigener Kraft nicht leisten können.
An jedem Handelstag veröffentlichen Zentralbankgouverneure geldpolitische Erklärungen, publizieren Statistikämter Inflations- und Arbeitsmarktrevisionen, melden geopolitische Nachrichtenagenturen unangekündigte Lieferunterbrechungen und ordnen Tausende von Finanzartikeln makroökonomische Verschiebungen ein. Noch bevor sich diese Ereignisse vollständig im Limit-Orderbuch niederschlagen, existiert ihr semantischer Gehalt ausschließlich als unstrukturierter Text Dt. Domänenkalibrierte Finanzsprachmodelle (aufbauend auf den Erkenntnissen zum Finanzlexikon von Loughran und McDonald [17] sowie den kontextuellen FinBERT-Einbettungen von Araci [18]) sind herausragend darin, Tausende Schlagzeilen pro Minute zu verarbeiten, Verneinungen sowie subtile Zentralbanknuancen aufzulösen und präzise zu messen, ob eintreffender Text positiven oder negativen Makrodruck entfaltet.
Innerhalb von 4CastMachine AI setzen wir genau diese linguistische Fähigkeit gezielt in Engine 2 (Sentiment AI) ein und ziehen zugleich eine kompromisslose architektonische Trennlinie, die wir als Semantische Firewall (Semantic Firewall) bezeichnen. In Sentiment AI wird das Sprachmodell niemals gefragt, wo Bitcoin oder Gold morgen notieren werden, es darf niemals eine Unterstützungszone einzeichnen und niemals mit überredender Erzählprosa an den Trader herantreten. Stattdessen arbeitet Sentiment AI ausschließlich als beschränkter semantischer Sensor, der unstrukturierte Textströme Dt und historische Makroereignis-Archive ℋhist auf einen niedrigdimensionalen, kalibrierten numerischen Merkmalsvektor abbildet:
Verfolgen wir jede Komponente von Gleichung (6) Schritt für Schritt, um zu erkennen, wie jede einzelne Engine innerhalb von Quad-AI strikt in ihrer mathematisch zulässigen Domäne verbleibt:
- Engine 2 · Sentiment AI (ℰSentiment, beantwortet „Das Warum“): Liest mehrquellige Echtzeit-Nachrichtenströme Dt mittels kontextueller Sprachmodellierung, um die beschränkte Richtungspolarität pt ∈ [-1, +1], die standardisierte Überraschung im Wirtschaftskalender ze,t, die semantische Kosinus-Ähnlichkeit simcos(𝐞(Dt), 𝐞(ℋhist)) gegenüber historischen Makroepisoden mit bekannter realisierter Volatilitätswirkung sowie die Hawkes-Ankunftsintensität λt zu extrahieren. Ihre Ausgabe ist ausschließlich ein strukturierter numerischer Vektor 𝐳tnews, niemals ein Kursziel.
- Engine 1 · Forecast AI (𝒬Fcst, beantwortet „Das Was“): Operiert ausschließlich auf stetigen
IEEE-754-Preis-Volumen-Tensoren 𝐗t-L:t über neun Zeitrahmen (1mbisM) und berechnet zeitrahmenübergreifende Marktstruktur, harmonische und geometrische Wellenproportionen, Angebots- und Nachfragezonen sowie kalibrierte Kerzenwahrscheinlichkeiten des Modells Daily Trading Opportunity (DTO), ohne ein einziges Wort-Token zu berühren. - Engine 3 · Synergy AI (𝒢Syn, beantwortet „Das Wie“): Arbitriert stetig zwischen
Forecast AIundSentiment AIüber regimekonditioniertes Softmax-Gating (detailliert hergeleitet in unserer Forschungsarbeit zur dynamischen Regime-Gewichtung durch Synergy AI), indem sie in ruhigen diffusiven Handelsstunden mediales Grundrauschen unterdrückt und 𝐳tnews bei überraschungsstarken Sprungschocks gezielt hochgewichtet. - Engine 4 · Navigator AI (𝒩Nav, beantwortet „Was zu tun ist“): Löst eine deterministische präskriptive Optimierung über der abgestimmten Wahrscheinlichkeitsfläche, um eine einzige falsifizierbare Chart-Roadmap ℛt einzuzeichnen: eine explizite
Buy zoneoderSell zone, eine strukturelle Invalidierungsgrenze (Pivot), eine gestufteProfit zone-Zieltreppe (TP1bisTP5), eine bedingteReverse zonesowie richtungsweisendeGreen Arrows.
Kehren wir zu unserer Analogie des Zeitungsjournalisten zurück. In Gleichung (6) engagieren wir den Journalisten (Sentiment AI) einzig und allein dafür, Eilmeldungen binnen fünfzig Millisekunden zu lesen, den geldpolitischen Tonfall als restriktiv (hawkish) oder akkommodierend (dovish) zu bewerten und passende historische Schlagzeilen aus dem Archiv abzurufen. An die Differentialgleichungen lassen wir den Journalisten niemals heran! Sämtliche Trajektorienberechnungen, Regimegewichtungen und Stop-Loss-Geometrien werden nachgelagert von spezialisierten quantitativen Engines (Forecast AI, Synergy AI und Navigator AI) gelöst.
Diese präzise Arbeitsteilung erstreckt sich über das gesamte, neun spezialisierte KIs umfassende ForecastCity-Ökosystem. Dialogorientierte Erklärungsschnittstellen wie AI Trading Assistant unterstützen Anwender dabei, Werkzeuge des Arbeitsbereichs zu bedienen oder geschriebene Strategieregeln in verständlicher Alltagssprache zu strukturieren, während AI Strategy Studio, Virtual Accounts, die Synchronisationsbrücke ForecastFollow, das klauselgenaue AI Trading Journal und 4CastMachine AI zu 100 % deterministische quantitative Mathematik auf historischen und laufenden Live-Kerzen ausführen. Tabelle 2 fasst zusammen, welche Systemaufgaben in die Domäne linguistischer KI und welche in die Domäne stetiger quantitativer KI gehören.
| Aufgabe im Finanzsystem | Mathematische Modalität | Korrektes KI-Paradigma | Folge einer Fehlanwendung generativer LLMs |
|---|---|---|---|
| Auswertung von Zentralbanktexten & Makro-Schlagzeilen | Unstrukturierte diskrete natürliche Sprache Dt ∈ 𝒱* | Domänenadaptiertes Finanz-NLP / Encoder-LLM (Sentiment AI) |
Zulässige Domäne, sofern die Ausgabe strikt auf kalibrierte Polaritäts- & Ereignis-Skalare beschränkt bleibt |
| Multi-Zeitrahmen-S/R, Harmonik & Kerzenwahrscheinlichkeiten | Stetiger reeller Tensor 𝐗t-L:t ∈ ℝL×d | Stetige Zustandsraum- & Spannenschätzer (Forecast AI) |
BPE-Metrikverzerrung, 65% Genauigkeitseinbruch bei Störsätzen [7] und frei erfundene Unterstützungs-/Widerstandsmarken |
| Arbitrierung zwischen Preisstruktur & Nachrichtenfrequenz | Gemeinsamer Sprung-Diffusions- & Hawkes-Intensitätsraum | Stetiges Softmax-Mixture-of-Experts (Synergy AI) |
Willkürlicher Narrativwechsel; Aktualitätsverzerrung zugunsten der zuletzt im Prompt genannten Schlagzeile |
| Festlegung von Einstiegszonen, Pivot-Invalidierung & TP1-TP5 | Nebenbedingte Stoppzeit-Risikooptimierung | Präskriptive Chart-Optimierung (Navigator AI) |
Nicht falsifizierbare Prosa, fehlende Invalidierungsgrenzen und asymmetrisches Drawdown-Ruinrisiko |
6. Live-Chart-Belege: Deterministische Quad-AI-Roadmaps auf BTCUSD (D) und XAUUSD (4h) im Vergleich zu generativer Narrativ-Drift
Um den Gegensatz zwischen konversationeller LLM-Prosa und deterministischer quantitativer Marktprognose greifbar zu machen, untersuchen wir zwei produktive Live-Charts aus 4CM-AI Charts über zwei unterschiedliche Anlageklassen und Zeitrahmen hinweg: Bitcoin (BTCUSD) auf dem Tageshorizont (D) sowie Gold (XAUUSD) auf dem 4-Stunden-Horizont (4h).
Betrachten wir zunächst, was geschieht, wenn ein Trader oder Social-Media-Moderator ein allgemeines LLM nach einem Bitcoin-Ausblick befragt (oder ein rohes Kerzenbild hochlädt), während BTCUSD nach einem Rücksetzer vom Herbsthoch nahe 87,000 im Bereich von 64,570.00 handelt. Über wiederholte Abfragen hinweg spalten sich konversationelle Modelle in unvereinbare Geschichten auf. Ein Lauf fixiert sich auf die scharfen roten Novemberkerzen und warnt vor einem unmittelbaren Einbruch in Richtung $50,000; ein zweiter Lauf referiert globale Krypto-Adoptionsthemen und ruft eine sofortige V-förmige Rallye auf $90,000 aus; ein dritter Lauf erfindet ungefähre Fibonacci-Marken, die mit dem tatsächlichen Swing-Hoch und Swing-Tief auf dem Kursband nicht übereinstimmen. Keiner dieser Textabsätze definiert eine exakte Invalidierungsgrenze oder löst widerspruchsfrei auf, warum kürzere Intraday-Zeitrahmen von der übergeordneten Tagesstruktur abweichen.
Prüfen wir nun Abbildung 3, die die deterministische 4CastMachine AI-Roadmap auf BTCUSD (D) zeigt, berechnet direkt aus exakten stetigen OHLCV-Koordinaten und konsistent über alle Zeitrahmen abgestimmt.
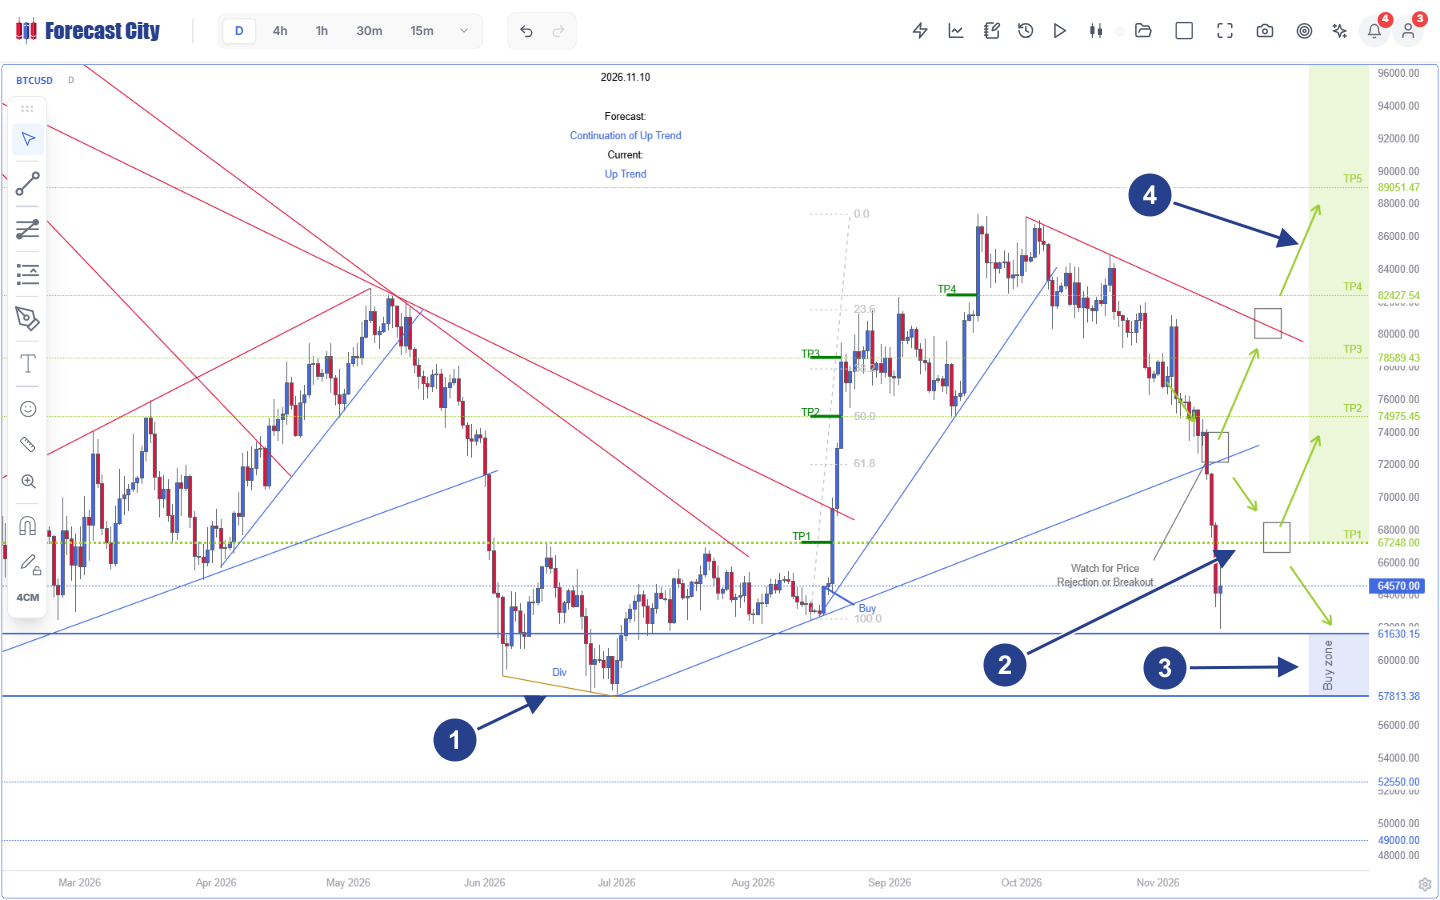
BTCUSD, Tageszeitrahmen D, Kassakurs 64,570.00): Im Gegensatz zur stochastischen Textgenerierung, deren Aussagen von Abfrage zu Abfrage driften, projiziert Quad-AI eine exakte, jederzeit reproduzierbare Koordinatengeometrie, verankert an geprüften historischen Swings und expliziten bedingten Entscheidungsknoten.
- 1Geprüftes strukturelles Fundament (
Div&100.0-0.0-Fibonacci-Impulsstrecke): Bullische Juni-Juli-Divergenz bei57,813.38, gefolgt vomBuy-Setup im August, das nacheinander die historischen KurszieleTP1,TP2,TP3undTP4abarbeitete. - 2Bedingte Entscheidungsknoten: Drei explizite Verzweigungen
Watch for Price Rejection or Breakoutentlang der gebrochenen steigenden blauen Unterstützungslinie und der fallenden roten Widerstandstrendlinie ersetzen vage Erzählprosa durch überprüfbare geometrische Bedingungen. - 3Quantifizierte
Buy zone(57,813.38-61,630.15): Exaktes institutionelles Nachfrageband unterhalb des Kassakurses64,570.00, abgesichert durch tiefere strukturelle Unterstützungsböden bei52,550.00und49,000.00. - 4Gestufte
Profit zone-Zieltreppe (TP1-TP5): Reproduzierbare Aufwärtsziele beiTP1 = 67,248.00,TP2 = 74,975.45,TP3 = 78,589.43,TP4 = 82,427.54undTP5 = 89,051.47.
Betrachten wir die zeitrahmenübergreifende Kohärenz hinter Abbildung 3 im Detail. Beim Kassakurs 64,570.00 sind auf den kürzeren Horizonten kurzfristige Korrekturbewegungen aktiv (30m bärisch unterhalb von 66,422.24, 1h bärisch unterhalb von 67,566.58 und 4h bärisch unterhalb von 72,769.47), während die übergeordnete Wochenstruktur oberhalb von 48,879.14 bullisch bleibt und die Tagesfortsetzung oberhalb von 67,248.00 (TP1) entschlossen zurück in den Aufwärtsmodus dreht. Statt blind zu raten, ob die rote Rücksetzerkerze bereits bei 64,570.00 endet oder zuvor noch tiefer eintaucht, bildet Navigator AI beide Pfade explizit ab: Entweder testet der Preis die Buy zone zwischen 57,813.38 und 61,630.15 und prallt dort nach oben ab, oder er erobert den Entscheidungsknoten bei 67,248.00 direkt zurück, um den primären Aufwärtsimpuls in Richtung 74,975.45 (TP2) und 89,051.47 (TP5) wieder aufzunehmen.
Die Kluft zwischen visuellem Gestalt-Raten und stetiger Koordinatenmathematik tritt auf kürzeren Intraday-Zeitrahmen wie 4h noch deutlicher zutage, wo sich schneidende Trendlinien, Polaritätswechsel und enge Invalidierungsschwellen dollargenaue Präzision verlangen. Abbildung 4 zeigt Gold (XAUUSD) auf dem 4h-Zeitrahmen beim Kassakurs 3,879.59.
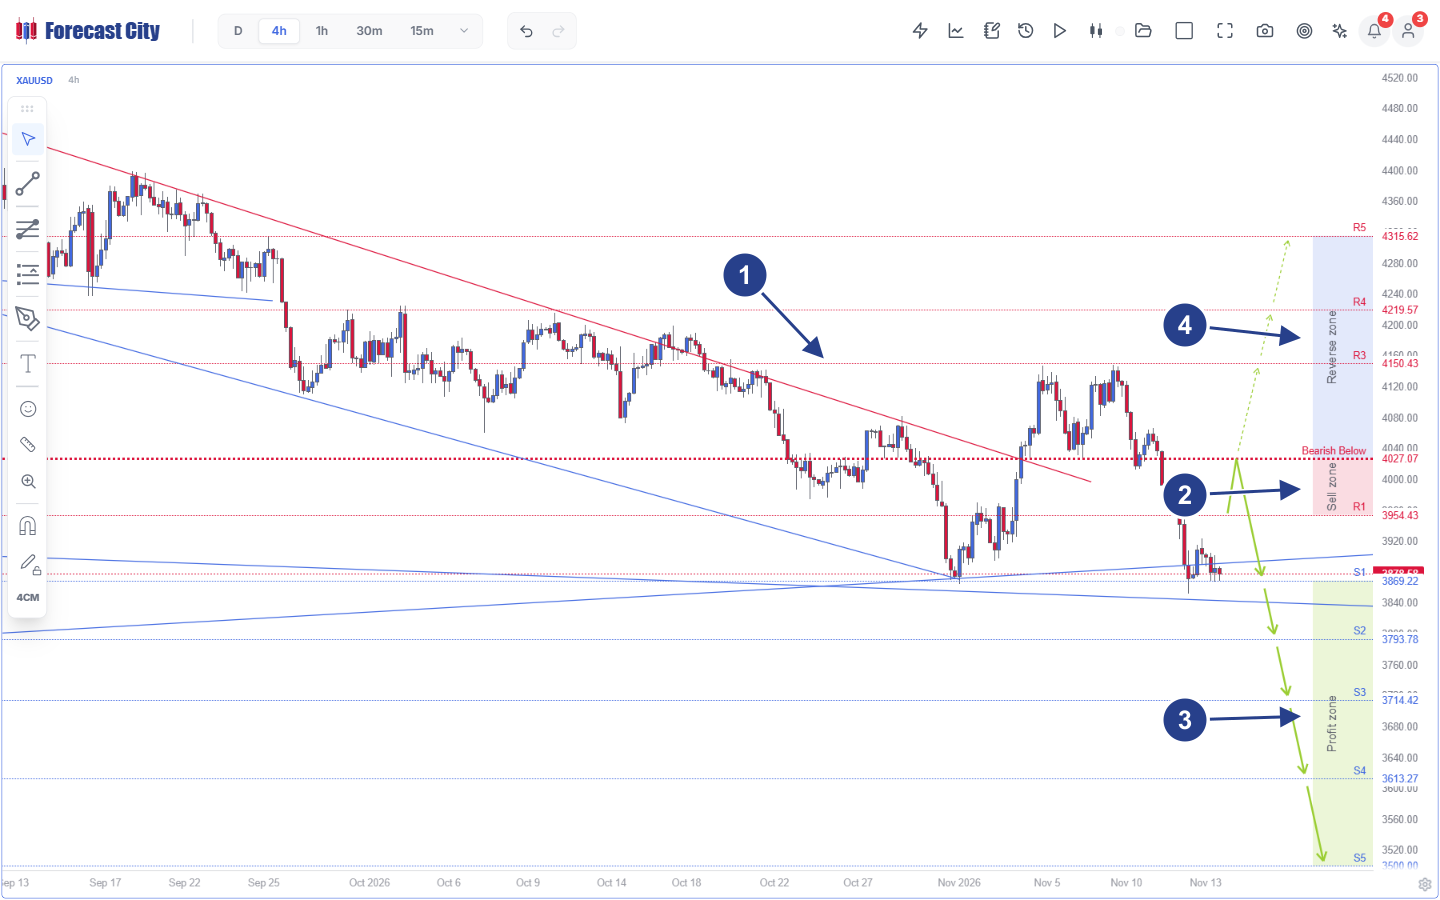
XAUUSD, Zeitrahmen 4h, Kassakurs 3,879.59): Wo multimodale VLM-Patch-Encoder feine Dochtabweisungen und konvergierende Fächergeometrien verwischen, berechnet Quad-AI exakte Zwei-Szenarien-Koordinaten von R5 (4,315.62) bis hinab zu S5 (3,500.00).
- 1Mehrwöchige Wellen- & Trendliniengeometrie: Die seit September fallende rote Widerstandslinie wurde Anfang November überwunden, gefolgt von einer Doppel-Top-Abweisung unterhalb von
4,150.43und einem Rückfall bis an den konvergierenden blauen Unterstützungsfächer nahe3,869.22. - 2
Sell zone& hartePivot-Invalidierung: Übergeordnete Angebotszone für Rücksetzer beginnend beiR1 = 3,954.43und strikt invalidiert oberhalb vonBearish Below 4,027.07. - 3Primäre
Green Arrows&Profit zone(S1-S5): Primäre bärische Trajektorie mit den gestuften KurszielenS1 = 3,869.22,S2 = 3,793.78,S3 = 3,714.42,S4 = 3,613.27undS5 = 3,500.00. - 4Bedingte
Reverse zone(R3-R5): Vorab berechneter alternativer bullischer Pfad (Dashed Arrows) in RichtungR3 = 4,150.43,R4 = 4,219.57undR5 = 4,315.62genau für den Fall, dass der Preis die Schwelle4,027.07invalidiert.
Vergleichen wir die konkrete Umsetzung des Kapitalrisikos auf dem laufenden XAUUSD-4h-Zustand in Abbildung 4 (Kassakurs 3,879.59) unter beiden Paradigmen:
1. Versagensmodus konversationeller LLMs / VLMs: Angesichts des steilen Goldrückgangs von 4,145 auf 3,879.59 läuft ein Dialogmodell entweder dem Abwärtsmomentum unmittelbar bei 3,879.59 direkt oberhalb der blauen Fächerunterstützung S1 = 3,869.22 hinterher (und setzt eine Short-Position sofort einem Short-Squeeze von $75 bis $147 aus) oder erklärt Gold pauschal für „überverkauft“, ohne einen strukturellen Invalidierungspreis zu nennen. Fragt man dasselbe Modell zehnmal ab, erhält man zehn verschiedene Stop-Loss-Zahlen bei unkalibrierter sprachlicher Selbstsicherheit [4, 14].
2. Deterministische Ausführungsgeometrie von Quad-AI: Beim Kassakurs 3,879.59 notiert der Preis lediglich $10.37 oberhalb von S1 = 3,869.22, aber volle $147.48 unterhalb des Invalidierungs-Pivot bei 4,027.07; ein sofortiger Leerverkauf zum Marktpreis weist damit bis S1 ein unbrauchbares Chance-Risiko-Verhältnis von 10.37 / 147.48 = 0.070 auf. Wartet man hingegen diszipliniert eine Gegenbewegung bis zur Mitte der Sell zone ab (3,990.75, exakt mittig zwischen R1 = 3,954.43 und Pivot = 4,027.07), schrumpft der strukturelle Stop-Abstand auf 4,027.07 - 3,990.75 = $36.32, während sich das Abwärtspotenzial bis S2 = 3,793.78 auf $196.97 (Chance-Risiko-Verhältnis 5.42 : 1) und bis S3 = 3,714.42 auf $276.33 (Chance-Risiko-Verhältnis 7.61 : 1) ausweitet. Jede einzelne Koordinate ist über 100 von 100 Auswertungen hinweg auf den Cent genau reproduzierbar. Leserinnen und Leser können das systematische Regelwerk für diese Zonen im Kurs Trend Hunter Strategie in der ForecastCity Academy vertiefen und sämtliche mathematischen Fachquellen auf der Quellenseite der Academy einsehen.
Häufig gestellte Fragen
Macht die Einstellung temperature = 0 oder Chain-of-Thought-Prompting ein LLM zuverlässig für Marktprognosen?
Nein. Atil et al. [4] wiesen nach, dass führende LLMs selbst bei temperature = 0 und festen Zufalls-Seeds über identische Läufe hinweg bis zu 10% bis 15% Antwortdrift zeigen, weil 16-Bit-Gleitkomma-Matrixreduktionen auf dynamisch gebatchten GPUs nicht assoziativ sind und eng beieinanderliegende Logits kippen, die sich autoregressiv aufschaukeln. Auch Chain-of-Thought-Prompting rechnet weiterhin auf BPE-fragmentierten Zahlentokens, bei denen Apple Research (GSM-Symbolic [7]) bereits beim Austausch numerischer Konstanten oder durch einen einzigen irrelevanten Marktnebensatz Genauigkeitseinbrüche von bis zu 65% dokumentierte.
Warum scheitern multimodale Vision-Language-Modelle (VLMs), selbst wenn sie saubere Kerzenchart-Screenshots erhalten?
Multimodale VLMs zerlegen Chartbilder in grobe Pixelkacheln von 14×14 oder 16×16 Pixeln und projizieren diese über einen verlustbehafteten Adapter in den Tokenraum natürlicher Sprache. Zwar benennen sie qualitative Wellensilhouetten ähnlich einem flüchtigen menschlichen Blick, doch die Benchmark-Studie von Hu et al. [8] belegt, dass sie exakte OHLC-Dochtproportionen verlieren, die ATR-Volatilitätsskalierung ignorieren, eine starke unbedingte bullische Verzerrung aufweisen und in Seitwärts- oder volatilen Marktphasen im Informationskoeffizienten gegen null einbrechen - ganz im Gegensatz zu quantitativen Modellen auf exakten IEEE-754-OHLCV-Tensoren.
Warum behaupten virale Social-Media-Backtests mitunter, ChatGPT oder GPT-4 hätten Aktien- oder Krypto-Benchmarks geschlagen?
Sarkar und Vafa an der University of Chicago und in Harvard [11] bewiesen, dass historische Backtests auf handelsüblichen vortrainierten LLMs unter schwerer Look-Ahead-Kontamination aus dem Vortraining leiden: Die Modellgewichte haben Unternehmens-, Makro- und Kursereignisse vor dem jeweiligen Wissensstichtag implizit memoriert. Werden dieselben Modelle streng Out-of-Sample auf ungesehenen Live-Kerzen oder in sauberen Ablationsstudien geprüft (Tan et al., NeurIPS 2024 [1]; Xie et al. [10]), bieten vortrainierte Sprach-Backbones keinerlei numerischen Prognosevorteil gegenüber spezialisierten quantitativen Modellen.
Wie nutzt 4CastMachine AI Sprachmodelle innerhalb von Sentiment AI, ohne Trader numerischen Halluzinationen auszusetzen?
4CastMachine AI setzt innerhalb seiner Quad-AI-Architektur eine strikte Semantische Firewall durch. Kontextuelle Finanzsprachmodelle in Sentiment AI dienen ausschließlich dazu, unstrukturierte Agenturmeldungen zu lesen, die Richtungspolarität zu bewerten und die semantische Ähnlichkeit zu historischen Makroereignissen zu messen, wobei sie beschränkte numerische Skalare [pt, ze,t, sim, λt] ausgeben. Kein LLM generiert jemals Kursziele; sämtliche stetigen Wahrscheinlichkeitsdichten, dynamischen Regimegewichte und Chartzonen werden deterministisch von Forecast AI, Synergy AI und Navigator AI berechnet.
Wissenschaftliche & institutionelle Quellen
- [1]Tan, M., Merrill, M. A., Gupta, V., Althoff, T., & Hartvigsen, T. (2024). Are Language Models Actually Useful for Time Series Forecasting? Advances in Neural Information Processing Systems (NeurIPS 2024 Spotlight), 37.
- [2]Kalai, A. T., & Vempala, S. S. (2024). Calibrated Language Models Must Hallucinate. Proceedings of the 56th Annual ACM Symposium on Theory of Computing (STOC 2024), 160-171.
- [3]Xu, Z., Jain, S., & Kankanhalli, M. (2024). Hallucination is Inevitable: An Innate Limitation of Large Language Models. arXiv preprint arXiv:2401.11817.
- [4]Atil, B., Chittams, A., Fu, L., Ture, F., Xu, L., & Baldwin, B. (2024). LLM Stability: A Detailed Analysis with Some Surprises. arXiv preprint arXiv:2408.04667.
- [5]Singh, A. K., & Strouse, D. J. (2024). Tokenization Counts: The Impact of Tokenization on Arithmetic in Frontier LLMs. arXiv preprint arXiv:2402.14903.
- [6]Dziri, N., Lu, X., Sclar, M., Li, X. L., Jiang, L., Lin, B. Y., ... & Choi, Y. (2023). Faith and Fate: Limits of Transformers on Compositionality. Advances in Neural Information Processing Systems (NeurIPS 2023), 36, 70293-70332.
- [7]Mirzadeh, I., Alizadeh, K., Shahrokhi, H., Tuzel, O., Bengio, S., & Farajtabar, M. (2024). GSM-Symbolic: Understanding the Limitations of Mathematical Reasoning in Large Language Models. Apple Machine Learning Research / ICLR 2025, arXiv:2410.05229.
- [8]Hu, K., Xiao, L., Xu, S., Tang, Z., & Liu, M. (2026). Do VLMs Truly "Read" Candlesticks? A Multi-Scale Benchmark for Visual Stock Price Forecasting. arXiv preprint arXiv:2604.12659.
- [9]Jiang, J., Kelly, B., & Xiu, D. (2023). (Re-)Imag(in)ing Price Trends. The Journal of Finance, 78(6), 3193-3249.
- [10]Xie, Q., Han, W., Lai, Y., Peng, M., & Huang, J. (2023). The Wall Street Neophyte: A Zero-Shot Analysis of ChatGPT Over MultiModal Stock Movement Prediction Challenges. arXiv preprint arXiv:2304.05351.
- [11]Sarkar, S. K., & Vafa, K. (2024). Lookahead Bias in Pretrained Language Models. University of Chicago & Harvard University Working Paper, SSRN 4754678 / arXiv:2402.02092.
- [12]Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., ... & Perez, E. (2024). Towards Understanding Sycophancy in Language Models. International Conference on Learning Representations (ICLR 2024).
- [13]Wen, J., Zhong, R., Khan, A., Perez, E., Steinhardt, J., Huang, M., ... & He, H. (2025). Language Models Learn to Mislead Humans via RLHF. International Conference on Learning Representations (ICLR 2025), arXiv:2409.12822.
- [14]Xiong, M., Hu, Z., Lu, X., Li, Y., Fu, J., He, J., & Hooi, B. (2024). Can LLMs Express Their Uncertainty? An Empirical Evaluation of Confidence Elicitation in LLMs. International Conference on Learning Representations (ICLR 2024).
- [15]Zeng, A., Chen, M., Zhang, L., & Xu, Q. (2023). Are Transformers Effective for Time Series Forecasting? Proceedings of the AAAI Conference on Artificial Intelligence, 37(9), 11121-11128.
- [16]Gneiting, T., & Raftery, A. E. (2007). Strictly Proper Scoring Rules, Prediction, and Estimation. Journal of the American Statistical Association, 102(477), 359-378.
- [17]Loughran, T., & McDonald, B. (2011). When Is a Liability Not a Liability? Textual Analysis, Dictionaries, and 10-Ks. The Journal of Finance, 66(1), 35-65.
- [18]Araci, D. (2019). FinBERT: Financial Sentiment Analysis with Pre-trained Language Models. arXiv preprint arXiv:1908.10063.