در سالهای اخیر، موج فراگیری در شبکههای اجتماعی نظیر یوتیوب، اینستاگرام، تیکتاک و ایکس شکل گرفته است که در آن تولیدکنندگان محتوا با ارسال جداول قیمتی یا بارگذاری تصویر چارت کندلها در مدلهای زبانی بزرگ (LLMs) و مدلهای بینایی-زبانی (VLMs) همچون ChatGPT، Claude، Gemini و DeepSeek، از آنها مسیر آیندهی بیتکوین، طلا یا جفتارزها را مطالبه میکنند. از آنجا که این مدلها متونی بسیار خوشساخت، روان و شبیه به گزارشهای نهادی تولید میکنند، مخاطبان غیرمتخصص بهسادگی بلاغت کلامی را با برتری محاسباتی اشتباه میگیرند. این مقاله با استناد به قضایای نظری علوم کامپیوتر و بنچمارکهای تجربی منتشرشده در STOC، NeurIPS، ICLR، AAAI و The Journal of Finance اثبات میکند که چرا مدلهای مولد خودهمبسته به لحاظ ساختاری برای پیشبینی عددی بازارهای مالی نامناسب هستند. ما پنج سازوکار شکست ریاضی را صورتبندی میکنیم: (1) فروپاشی پیوستگی متریک اقلیدسی در اثر توکنایزینگ زیرواژهای ارقام، (2) تصویرسازی پرخطای تکههای پیکسلی به فضای واژگان هنگام بررسی تصاویر چارت در مدلهای چندوجهی، (3) واگرایی پاسخها در پرسشهای تکراری حتی در دمای صفر به همراه کران پایین گود-تورینگ برای توهم گریزناپذیر، (4) چاپلوسی الگوریتمی و سفسطهی متقاعدکننده ناشی از RLHF در کنار نشت دادههای آینده در بکتستهای تاریخی، و (5) فروپاشی کالیبراسیون احتمال تحت ریسک سرمایه. در پایان، مرز دقیق معماری را در درون 4CastMachine AI تبیین میکنیم: محدودسازی کامل مدل زبانی در درون موتور Sentiment AI صرفاً برای استخراج قطبیت اخبار و شباهتسنجی با رویدادهای تاریخی، و سپردن تمامی محاسبات هندسهی قیمت، وزندهی رژیم و ترسیم نقشهی راه چارت به موتورهای کمی Forecast AI، Synergy AI و Navigator AI.
1. خطای مقولهای فراگیر و مغالطهی خبرنگار خوشقلم اما سرگردان در برابر معادلات دیفرانسیل
در سه سال گذشته، مدلهای زبانی بزرگ (LLMs) به سطح چشمگیری از شیوایی در نگارش زبان طبیعی، خلاصهسازی اسناد و ترکیب قطعه کدها دست یافتهاند. همین مهارت زبانی، یک خطای روششناختی گسترده را در فضای رسانهای بازارهای مالی خرد به راه انداخته است. امروزه همچون یک موج همهگیر در یوتیوب، اینستاگرام، تیکتاک و شبکهی ایکس، بسیاری از اینفلوئنسرها و تولیدکنندگان محتوا که فاقد پیشینهی ریاضیات کاربردی و اقتصادسنجی هستند، جدول اعداد OHLC یا تصویر چارت کندلها را به یک چتبات عمومی میدهند و متن تولیدشده را به عنوان چشمانداز آیندهی بازار برای صدها هزار مخاطب بازنشر میکنند.
در نگاه اول، خروجی این مدلها فوقالعاده حرفهای به نظر میرسد. مدل زبانی در عرض چند ثانیه از محرکهای کلان اقتصادی نام میبرد، به الگوهای آشنای چارت مانند کنج صعودی یا سطوح اصلاحی فیبوناچی اشاره میکند و پاراگرافی بسیار آراسته دربارهی مقصد بعدی بیتکوین (BTCUSD) یا طلا (XAUUSD) مینویسد. حتی اگر کاربر در پرامپت خود از مدل بخواهد که با لحن قاطع یک استراتژیست ارشد نهادی صحبت کند، مدل دقیقاً همان دایرهی واژگان و ساختار جملهبندی نهادی را با اعتمادبهنفس کامل بازتولید میکند.
اما در پس این آراستگی نگارشی، یک خطای مقولهای بنیادین (Category Error) در ریاضیات کاربردی نهفته است. بازارهای مالی سیستمهای تصادفی حالتپیوسته، ناایستا و دارای نسبت سیگنال به نویز بسیار پایین هستند که رفتار آنها توسط تسویهی دفتر سفارشهای محدود، نوسانپذیری ناهمسان و فرایندهای پرشی دنبالهپهن تعیین میشود. در نقطهی مقابل، مدلهای زبانی خودهمبسته (Autoregressive LLMs) مولدهای دنبالهگسستهای هستند که صرفاً آموزش دیدهاند حدس بزنند پس از یک رشته از قطعات واژگانی، محتملترین قطعهواژهی بعدی در پیکرهی متون انسانی کدام است.
یک تمثیل ساختاری دقیق نشان میدهد که چرا جایگزین کردن این دو قلمرو ریاضی با یکدیگر فاجعهبار است. انتظار داشتن از یک مدل زبانی مولد برای حل مسیر چندافقی بازارهای مالی، دقیقاً مانند آن است که از یک خبرنگار زبردست روزنامه بخواهید یک دستگاه معادلات دیفرانسیل تصادفی غیرخطی و جفتشده را در شرایط ریسک زندهی سرمایه حل کند. آن خبرنگار میتواند مقالهای هزارکلمهای، بسیار خوشخوان و مسحورکننده دربارهی تاریخچهی حساب دیفرانسیل و انتگرال بنویسد، از ریاضیدانان بزرگ نقلقول بیاورد و صفحهآرایی متن را چنان تمیز انجام دهد که خوانندهی غیرمتخصص تصور کند معادله واقعاً حل شده است.
با این حال، شیوایی نثر هرگز معادل انتگرالگیری عددی نیست. بدتر آنکه به دلیل نمونهبرداری تصادفی در مرحلهی تولید توکن و نرخ غیرصفر توهم آماری (Hallucination)، این راوی متنی در شرایط پرابهام بازار عملاً رفتاری شبیه به یک خبرنگار مست و بیپروا پیدا میکند که هرگز به ندانستن اعتراف نمیکند. اگر یک پرسش واحد را دو بار پشت سر هم از او بپرسید، ممکن است دو پاسخ با جهتگیری متضاد بدهد. اگر همان پرسش را صد بار تکرار کنید، در شماری از پاسخها با همان نثر فاخر و لحن مطمئن، اعداد حمایت و مقاومتی را جعل میکند که اصلاً روی چارت وجود خارجی ندارند و حتی در تفریق سادهی فاصلهی حد ضرر دچار خطا میشود.
برای صورتبندی دقیق این ناسازگاری، ابتدا تابع هدف بهینهسازی یک مدل زبانی خودهمبسته را با تابع هدف یک موتور پیشبینی کمی کالیبرهشده مقایسه میکنیم. پیش از ملاحظهی فرمول، به تفاوت ماهیت جریمهی خطا در این دو معماری دقت کنید. مدل زبانی صرفاً غافلگیری واژگانی روی شناسهی توکنهای گسسته را کمینه میکند، در حالی که موتور فضای حالت کمی، فاصلهی متریک روی محور اعداد حقیقی و خطای کالیبراسیون توزیع احتمال را کمینه میسازد.
فرض کنید 𝒱 الفبای متناهی توکنهای زیرواژهای با اندازهی |𝒱| ≈ 32,000..200,000 و v1:K ∈ 𝒱K دنبالهای از توکنهای متنی باشد. یک مدل زبانی خودهمبسته با پارامترهای θ آنتروپی متقاطع گسستهی ℒLLM(θ) را کمینه میکند. در مقابل، فرض کنید 𝐗t-L:t ∈ ℝL×d تانسور حقیقی وضعیت بازار و Pt+τ ∈ ℝ+ قیمت تحققیافته در افق τ باشد. موتور کمی با پارامترهای ψ توزیع تجمعی Fψ(y | 𝐗t-L:t) را به گونهای برآورد میکند که معیار رتبهای پیوستهی احتمال (CRPS، گنایتینگ و رافتری [16]) کمینه شود:
در معادلهی (1)، تابع ℒLLM(θ) یک نشانگر طبقهبندی تکنمودی (One-Hot) را روی اندیس واژگانی vk ارزیابی میکند؛ یعنی هر توکن نادرست، فارغ از آنکه از نظر عددی چقدر به مقدار واقعی نزدیک یا از آن دور باشد، دقیقاً با یک نوع جریمهی لگاریتمی روبهرو میشود. برعکس، انتگرال CRPS(Fψ, Pt+τ) مجذور خطای احتمال تجمعی را در سرتاسر محور اعداد حقیقی ℝ محاسبه کرده و هم فاصلهی متریک از قیمت واقعی Pt+τ و هم عدم کالیبراسیون واریانس را بهطور اکید جریمه میکند.
فرض کنید بیتکوین روی 64,570 معامله میشود و ارزش تعادلی فردا 65,000 است. در تابع زیان واژگانی ℒLLM، تولید رشتهی متنی "64,999" (که فقط $1 خطا دارد) میتواند جریمهی بزرگتری نسبت به تولید رشتهی "95,000" (با $30,000 خطا!) دریافت کند، صرفاً به این دلیل که ترکیب توکنهای "95" و ",000" در متون خبری اینترنت پرتکرارتر بوده است! اما در معیار پیوستهی CRPS، خطای $30,000 به شکل متناسب با فاصلهی واقعی قیمتی سیهزار برابر سنگینتر از خطای $1 جریمه میشود و تمام وزنهای مدل را به ریسک واقعی دلاری مقید نگه میدارد.
شواهد تجربی داوریشده نیز تایید میکنند که آموزش دیدن روی تریلیونها کلمه هیچ مهارت ذاتی در پیشبینی سریهای زمانی ایجاد نمیکند. در یک پژوهش شاخص که به عنوان مقالهی برگزیده (Spotlight) در کنفرانس NeurIPS 2024 منتشر شد، تان، مریل، گوپتا، آلتوف و هارتویگسن [1] مشهورترین معماریهای پیشبینی سری زمانی مبتنی بر مدلهای زبانی از جمله Time-LLM، OneFitsAll (GPT4TS) و CALF را روی مجموعهدادههای استاندارد محک زدند. پژوهشگران در آزمایشهای حذفی (Ablation Studies) هستهی چندمیلیارد پارامتری LLM را بهطور کامل از داخل این مدلها بیرون کشیدند و به جای آن صرفاً یک لایهی سبک توجه یا خطی گذاشتند که از صفر روی دادههای عددی آموزش میدید.
نتیجه، بنیان ادعاهای تبلیغاتی پیرامون پیشبینی سری زمانی با LLM را فرو ریخت. حذف کامل مدل زبانی نه تنها دقت پیشبینی را کاهش نداد، بلکه در اغلب بنچمارکها خطای میانگین مربعات (MSE) و میانگین قدرمطلق خطا (MAE) را بهبود بخشید و همزمان حجم پارامترها و هزینهی محاسباتی را بین صد تا هزار برابر کاهش داد [1]. حتی در سناریوهای کمداده (Few-Shot) که مدافعان ادعا میکردند دانش زبانی پیشآموزشدیده به درک الگوهای زمانی کمک میکند، وزنهای LLM هیچ برتری معناداری نسبت به رمزگذارهای عددی کوچک نداشتند. پیشتر نیز زنگ و همکاران در کنفرانس AAAI [15] نشان داده بودند هنگامی که ترتیب زمانی و مقیاس پیوستهی دادهها در نگاشت توکنی مخدوش میشود، نگاشتهای خطی مستقیم عملکردی بهمراتب دقیقتر از ترنسفورمرهای سنگین دارند.
2. فروپاشی متریک در توکنایزینگ زیرواژهای و چرایی ناتوانی دید موجی مدلهای چندوجهی (VLM) در سنجش ریسک
برای درک اینکه چرا بزرگتر کردن یک مدل زبانی از هفت میلیارد پارامتر به بیش از یک تریلیون پارامتر هرگز آن را به یک موتور کمی قابل اتکا تبدیل نمیکند، باید ببینیم در همان اولین لایهی ورودی شبکه چه بر سر اعداد بازار میآید. الگوریتمهای کمی، قیمتها، حجم معاملات و سریهای نوسان را در قالب اعداد ممیز شناور 64 بیتی استاندارد IEEE-754 دریافت میکنند. اعداد حقیقی یک میدان متریک کامل تشکیل میدهند که در آن جمع، ضرب، ترتیب بزرگی و فاصلهی اقلیدسی عملیات دقیق سختافزاری هستند.
مدلهای زبانی اصلاً عدد ممیز شناور دریافت نمیکنند. پیش از آنکه شبکهی ترنسفورمر حتی یک مظنهی قیمت را ببیند، یک توکنایزر مبتنی بر کدگذاری جفتبایت (BPE) یا SentencePiece رشتهی کاراکترهای عدد را بر اساس فراوانی آماری حروف در متون اینترنت، از چپ به راست به قطعات نامنظم یکرقمی، دورقمی یا سهرقمی خرد میکند. سینگ و استراوس [5] اثبات کردند که این برش چپبهراست در مدلهای پیشرو مستقیماً با منطق ارزش مکانی ارقام و انتقال دهگان از راست به چپ در محاسبات ریاضی تصادم دارد.
ببینید این توکنایزینگ زیرواژهای با نرخهای واقعی فارکس و رمزارزها چه میکند. در جفتارز EURUSD، دو قیمت 1.0849 و 1.0850 تنها 0.0001 (1 pip) با هم فاصله دارند و از دید بازار عملاً یک نقطهی واحد محسوب میشوند. اما در توکنایزینگ BPE، رشتههای "0849" و "0850" به دو شناسهی صحیح کاملاً مجزا نگاشت میشوند که بردارهای تعبیهی اولیهی آنها در فضای ℝde هیچ الزامی ندارد به هم نزدیکتر از بردار مربوط به قیمت "1.9850" (با فاصلهی 9,000 pips!) باشند. این گسست توپولوژیک را با نسبت اعوجاج متریک موضعی توکنایزر صورتبندی میکنیم:
در معادلهی (2)، متغیرهای x, y ∈ ℝ دو قیمت حقیقی بازار با فاصلهی یک تیک حداقل (δ) هستند، تابع str(·) عدد را به رشتهی دهدهی تبدیل میکند و ΦBPE(·) دنبالهی توکنهای حاصل را به فضای برداری ورودی مدل میبرد. در هر مدل کمی خوشتعریف، نسبت κ(x, y) توسط یک ثابت لیپشیتس متناهی کراندار میشود تا تغییرات بسیار کوچک قیمت، تغییرات حالت کوچکی ایجاد کنند. اما در برش رشتهای BPE، ضریب κtok(x, y) در مرزهای انتقال رقم (مانند گذار از 69,999.99 به 70,000.00) دچار پرشهای شدید میشود و در عوض، هرگاه دو قیمت بسیار دور در ارقام انتهایی مشترک باشند، به شکل مصنوعی فرو میریزد.
معادلهی (2) توضیح میدهد که چرا مدلهای زبانی در محاسبات پایهی ریسک روی چارتهای زنده خطاهای عجیب میکنند. از نگاه یک توکنایزر متنی، دو عدد 67,248 و 57,248 بسیار شبیه به هم دیده میشوند زیرا چهار رقم آخرشان یکسان است، در حالی که روی چارت بیتکوین $10,000 با هم فاصله دارند! برعکس، دو عدد 69,999 و 70,001 با وجود تنها $2 فاصله، هیچ رقم مشترکی ندارند. هیچ موتور محاسبهی نوسان یا حد ضرر نمیتواند روی دستگاه مختصاتی که فاصلهی اعداد را چنین درهم میریزد، خروجی قابل اعتمادی بسازد.
این نقص بازنمایی مستقیماً به شکست در استدلالهای چندمرحلهای منتهی میشود. دزیری و همکاران در کنفرانس NeurIPS [6] ثابت کردند که ترنسفورمرهای خودهمبسته به جای یادگیری الگوریتمهای محاسباتی تعمیمپذیر، مسائل چندمرحلهای ریاضی و برنامهریزی پویا را به تطبیق خطی زیرگرافهای ظاهری تقلیل میدهند و با افزایش عمق محاسبات، دقت آنها بهصورت نمایی سقوط میکند. پژوهشگران بخش یادگیری ماشین شرکت اپل (میرزاده و همکاران [7]) نیز بنچمارک نمادین GSM-Symbolic را معرفی کردند که در آن ساختار منطقی مسئله ثابت میماند و فقط مقادیر عددی تغییر میکنند. آنها نشان دادند صرفاً تغییر دادن اعداد مسئله باعث نوسان شدید دقت در پیشرفتهترین مدلهای زبانی میشود و افزودن تنها یک جملهی حاشیهای بیربط به متن صورتمسئله، دقت محاسباتی مدلها را تا 65% فرو میریزد [7]. این در حالی است که بازارهای مالی در هر ساعت دهها خبر و متغیر حاشیهای پرنویز به محیط تزریق میکنند.
در مواجهه با این ضعف متنی، بسیاری از کاربران شبکههای اجتماعی سراغ استدلال دومی میروند: «به جای تایپ کردن اعداد، تصویر چارت کندلها را به یک مدل چندوجهی بینایی-زبانی (VLM) بدهید تا درست مثل چشم انسان، امواج و الگوهای قیمت را ببیند!» در سطح ظاهری، این سخن فریبنده است. انسان نیز با یک نگاه به چارت، قلهها، درهها و شیب کلی موجها را تشخیص میدهد و مدلهای بینایی-زبانی هم بهخوبی میتوانند همین برداشت کلی و گشتالتی را تقلید کرده و نامهایی چون الگوی سر و شانه یا کنج صعودی را در متنی زیبا ردیف کنند.
اما دیدن شکل ظاهری یک موج، زمین تا آسمان با محاسبهی امید ریاضی شرطی و هندسهی کمی ریسک تفاوت دارد. هنگامی که تصویر یک چارت 1440×900 پیکسلی وارد یک مدل چندوجهی VLM میشود، رمزگذار بینایی (ViT یا SigLIP) تصویر را به مربعات درشت 14×14 یا 16×16 پیکسلی تکه میکند و آنها را از طریق یک لایهی خطی فشردهساز به فضای توکنهای واژگانی پرتاب میکند. در این گذرگاه پرخطا، نسبت دقیق سایهها (Wicks) به بدنهی کندل، مقیاس غیرخطی محور قیمت و نرمالسازی نوسان با میانگین محدودهی واقعی ۱۴ دورهای (ATRt(14)) محو میشوند، زیرا آن رمزگذار برای توصیف اشیای درون عکسهای روزمره ساخته شده است، نه اندازهگیری دقیق واحد پایه روی نمودار مالی.
بنچمارکهای تخصصی جدید دقیقاً همین شکست ساختاری را روی چارتهای کندلی مستند کردهاند. هو، شیائو، شو، تانگ و لیو [8] یک چارچوب ارزیابی چندمقیاسی از چارتهای کندلی ساختند و مدلهای پیشرو VLM را در برابر مدلهای کمی جدولی (نظیر درختهای تقویتشده با گرادیان روی دادههای خام عددی) آزمودند. نتایج چهار ضعف بنیادین را آشکار کرد: (1) مدلهای VLM دچار تورش جهتی شدید و دائمی به سمت صعودی دیدن چارت هستند، (2) ضریب اطلاعاتی خارج از نمونهی (IC) آنها در بازارهای خنثی و پرنوسان به نزدیکی صفر سقوط میکند، (3) نسبت به تغییر افق زمانی در پرامپت (مثلاً تفاوت افق 5 کندلی و 30 کندلی) تقریباً بیحس هستند، و (4) مدلهای کمی سادهای که مستقیماً روی اعداد OHLCV کار میکنند، بهطور پایدار مدلهای چندوجهی عمومی را شکست میدهند [8].
تفاوت این رویکرد با بینایی ماشین کمی و اختصاصی در اقتصاد مالی بسیار روشن است. هنگامی که جیانگ، کلی و شیو پژوهش مشهور خود را در مجلهی The Journal of Finance [9] منتشر کردند، شبکههای کانولوشنی آنها دقیقاً به این دلیل به قدرت پیشبینی دست یافتند که زبان طبیعی را بهکلی دور زدند: ماتریسهای پیکسلی استاندارد مستقیماً مختصات نرمالشدهی سقف، کف، قیمت پایانی و حجم را بدون هیچ واسطهی واژگانی و تحت تابع زیان آماری نظارتشده به توزیع احتمال بازده نگاشت میکردند. عبور دادن تصویر چارت از گلوی یک مفسر متنی، تمام آن دقت متریک را از میان میبرد. شکل 1 این واگرایی معماری را میان خط لولهی مولد زبانی و خط لولهی کمی حالتپیوسته نشان میدهد.
A) نشان میدهد که چگونه مدلهای زبانی و چندوجهی با برش زیرواژهای BPE و تصویرسازی پرخطای تکههای 14×14 پیکسلی، توپولوژی عددی را متلاشی میکنند و در N = 100 بار اجرای پرامپت یکسان، روایتهای متناقض و سطوح جعلی میسازند. مسیر پایینی (B) نشان میدهد که چگونه موتورهای کمی حالتپیوسته هندسهی متریک IEEE-754، نرمالسازی ATRt(14) و تکرارپذیری صددرصدی با واریانس اجرایی صفر (Varrun(ŷt) = 0) را حفظ میکنند.3. ناپایداری پاسخ در 100 بار تکرار پرسش واحد و کران پایین گود-تورینگ برای توهم گریزناپذیر
یکی از اصول بدیهی مهندسی ریسک نهادی، «تعیینپذیری تابعی» (Functional Determinism) است: به ازای یک مجموعه اطلاعات ثابت بازار (ℱt) در لحظهی بسته شدن کندل t، مدل ریاضی باید دقیقاً یک توزیع احتمال یکتا و یک مجموعهی تکرارپذیر از مرزهای ریسک تولید کند. اگر کامپیوتر هدایت پرواز یک هواپیما به ازای دادههای کاملاً یکسان ارتفاع و سرعت باد، در دو ثانیهی متوالی دو مسیر فرود متضاد پیشنهاد دهد، هیچ مهندسی اجازهی پرواز به آن نمیدهد. مدلهای زبانی محاورهای این اصل بنیادین را در دو سطح مجزای ریاضی و سختافزاری نقض میکنند.
سطح نخست، نمونهبرداری تصادفی صریح در جریان تولید خودهمبستهی کلمات است. رابطهای کاربری و API چتباتها توکن بعدی vk را از توزیع سافتمکس مقیاسیافته با دما (Temperature) و برشخورده با هستهی احتمال (top-p) نمونهبرداری میکنند. از آنجا که فرایند تولید علیتی و زنجیرهای است، هر توکنی که در گام k قرعهکشی میشود، بلافاصله به تاریخچهی ورودی v1:k برای تولید توکن گام k + 1 میپیوندد.
ببینید وقتی یک معاملهگر روی کندل بستهشدهی بیتکوین دو بار پیاپی یک سوال مشخص را از LLM میپرسد چه اتفاقی رخ میدهد. فرض کنید در جایگاه توکن چهاردهم (k = 14)، احتمال واژهی «مقاوم» برابر 0.44 و احتمال واژهی «فرسوده» برابر 0.41 باشد. در پرسش اول، نمونهبرداری تصادفی واژهی «مقاوم» را برمیگزیند و تمامی سرهای توجه (Attention Heads) بعدی را به سمت بازیابی الگوهای شکست صعودی و هدف $78,000 هدایت میکند. سه ثانیه بعد و روی همان دادهی ثابت، در پرسش دوم واژهی «فرسوده» بیرون میآید و ادامهی متن به سمت سناریوی ریزش تا $56,000 منشعب میشود! اگر همین سوال را N = 100 بار تکرار کنیم، خروجیها به ابری چندقلهای از روایتهای متضاد تبدیل میشوند که در دنبالهی آن، اجراهایی با انحراف شدید و جعل کامل اعداد دیده میشود.
یک تصور رایج مهندسی این است که اگر دمای رمزگشایی را صفر قرار دهیم (τ → 0+ یا انتخاب حریصانهی argmax)، این ناپایداری بهکلی از بین میرود. پژوهشهای تجربی سیستمهای هوش مصنوعی خلاف این تصور را ثابت کردهاند. آتیل و همکاران [4] مدلهای زبانی پیشرو را در دمای دقیقاً صفر و با بذر تصادفی ثابت (Fixed Seed) در اجراهای مکرر و همسان آزمودند و دو شاخص نرخ توافق کل در رشتهی خام (TARr@N) و نرخ توافق در پاسخ نهایی استخراجشده (TARa@N) را اندازهگیری کردند. یافتهی آنها شگفتانگیز بود: حتی در temperature = 0 نیز نوسان دقتی تا سقف 10% الی 15% میان اجراهای یکسان رخ میدهد و بیشترین ناپایداری دقیقاً در مسائل ریاضی و چندمرحلهای بروز میکند [4].
علت فیزیکی این پدیده در دمای صفر، خاصیت «شرکتناپذیری جمع ممیز شناور» در درختهای کاهش موازی پردازندههای گرافیکی (GPU) به همراه تشدید زنجیرهای خطا در تولید خودهمبسته است:
در معادلهی (3)، عملگر ⊕BF16 بیانگر جمع در قالب ممیز شناور 16 بیتی (BF16 تنها با 7 بیت دقت مانتیس) در سرورهای دستهبندی پیوستهی ابری (مانند vLLM یا مسیریابهای Mixture-of-Experts) است. بسته به اینکه در همان میلیثانیهی خاص چه تعداد کاربر دیگر در جهان همزمان به سرور درخواست فرستاده باشند، اندازهی دستهی موازی (Dynamic Batch Size) تغییر میکند و رشتههای موازی CUDA ترتیب جمع زدن درایههای ماتریس را عوض میکنند. این جابهجایی باعث تغییر لاجیتها در مرتبهی 10-4..10-3 میشود. هرگاه دو توکن تحلیلی رقیب لاجیتهای بسیار نزدیکی داشته باشند (امری که در رژیمهای پرابهام و 50/50 بازار دائماً رخ میدهد)، همین لغزش بسیار ریز بیتی برندهی argmax را در یک کلمه جابهجا کرده و کل پاراگراف تحلیلی بعدی را دگرگون میسازد [4].
معادلهی (3) یک حقیقت تکاندهنده را برای تخصیص سرمایه آشکار میکند: حتی اگر دمای مدل زبانی را روی صفر قفل کنید، پاسخ معاملاتی شما به این بستگی دارد که در همان میلیثانیه چند هزار کاربر غریبه در نقاط دیگر دنیا مشغول چت کردن با همان خوشهی گرافیکی ابری هستند! در بازارهای پرنویز که کفهی روایت صعودی و نزولی نزدیک به هم است، تغییر ترتیب گرد کردن بیتها در سرور یک کلمهی ابتدایی را عوض میکند و کل نسخهی معاملاتی شما را برمیگرداند.
فراتر از ناپایداری اجرایی، یک سد نظری عمیقتر وجود دارد: «گریزناپذیری ریاضی توهم» (Hallucination). بسیاری تصور میکنند توهم مدلهای زبانی صرفاً یک نقص مهندسی موقت است که با بزرگتر شدن دادههای آموزشی برطرف خواهد شد. اما کالای و ومپالا در پنجاهوششمین سمپوزیوم نظریهی محاسبات انجمن ماشینهای حسابگر (STOC 2024) [2] خلاف این تصور را به شکل قضیه اثبات کردند. آنها نشان دادند هر مدل زبانی مولدی که از نظر آماری کالیبره باشد، ناگزیر است روی گزارههایی که حقیقتشان صرفاً از قواعد دستوری قابل استنتاج قطعی نیست، با نرخی دستکم معادل جرم تکنمونهای گود-تورینگ دچار توهم شود:
کالبدشکافی تکتک جملات معادلهی (4) روشن میکند که چرا بازارهای مالی بدترین محیط ممکن برای توهم زبانی هستند. در اینجا ℋfalse مجموعهی گزارههای به ظاهر منطقی اما نادرست است، کسر n1 / n برآوردگر گود-تورینگ برای جرم توزیع دیدهنشده است (یعنی کسری از تحققهای دادهی آموزشی با حجم n که دقیقاً یک بار رخ دادهاند)، جملهی κcal(πθ) انحراف از کالیبراسیون آماری را میسنجد و نسبت |𝒱ded| / |𝒱arb| سهم قواعد استنتاجپذیر قطعی در برابر پدیدههای تصادفی است. در پژوهشی مکمل از منظر نظریهی محاسبهپذیری، شو، جین و کانکانهالی [3] نیز با استفاده از قضایای یادگیری در حد گلد اثبات کردند که هیچ مدل زبانی محاسبهپذیری نمیتواند در فضاهای حالت باز، توهم را به صفر برساند.
چرا معادلهی (4) قلب پیشبینی بازار با LLM را هدف میگیرد؟ زیرا هر وضعیت روزانهی بازار چنددارایی (ترکیب دقیق قیمتهای لحظهای، عمق دفتر سفارشها، اسپرد بازده اوراق و غافلگیریهای کلان) یک وضعیت پیوستهی تکرارنشدنی است که حداکثر یک بار در تاریخ رخ داده است (n1 / n → 1 در فضای پیوسته!). وقتی مدلی که برای تولید جملات روان تربیت شده مجبور میشود بدون سکوت کردن دربارهی این وضعیتهای یکتا متن بنویسد، ریاضیاتِ حاکم بر آن را وادار به جعل اعداد به ظاهر موجه میکند.
یک بررسی عددی ساده روی معادلهی (4) ابعاد خطر را ملموس میکند. فرض کنید معاملهگری در N = 100 نوبت از یک مدل زبانی بخواهد سطوح دقیق حمایت، مقاومت و حد ضرر درونروزی را در رژیمهای نوسانی جدیدی استخراج کند که در آنها نرخ تکنمونهای n1 / n ≥ 0.22 و تلورانس کالیبراسیون 0.04 است. حتی در بهترین حالت پیشآموزش، دستکم در 15 تا 18 پاسخ از آن 100 پرسش، مدل اعدادی کاملاً ساختگی را با نثری مطمئن تحویل میدهد (مثلاً سطح میانگین متحرک یا تراز فیبوناچی را صدها واحد دورتر از مقدار واقعی آن روی چارت اعلام میکند). در معاملات اهرمی، تنها دو یا سه حد ضرر موهومی در صد معامله برای تحمیل افت سرمایهی سنگین کافی است.
4. سفسطهی متقاعدکننده در RLHF، هدایتپذیری از پرامپت در شبکههای اجتماعی و نشت دادههای آینده در بکتستها
اکنون این پرسش کلیدی مطرح میشود: اگر مدلهای زبانی مولد در توکنایزینگ اعداد شکست میخورند، در اجراهای تکراری واگرا میشوند و با کران پایین ریاضی دچار توهم میشوند، چرا تا این اندازه در شبکههای اجتماعی معاملهگران خرد محبوب شدهاند؟ پاسخ در سازوکار همراستاسازی پس از آموزش (Post-Training Alignment) نهفته است. مدلهای محاورهای مدرن تحت یادگیری تقویتی از بازخورد انسانی (RLHF) یا بهینهسازی مستقیم ترجیح (DPO) قرار میگیرند تا پارامترهای θ تابع پاداش ترجیح انسانی rφhuman(x, y) را با قید جریمهی واگرایی کولبک-لایبلر نسبت به مدل مرجع πref بیشینه کنند:
ببینید پاداش rφhuman(x, y) در معادلهی (5) واقعاً چه چیزی را اندازهگیری میکند. ارزیابهای انسانی که در مرحلهی آموزش، دو پاسخ مدل را با هم مقایسه و امتیازدهی میکنند، هرگز سی روز معاملاتی صبر نمیکنند تا ببینند آیا مسیر پیشنهادی مدل روی BTCUSD یا EURUSD امتیاز برایر خارج از نمونه را کمینه کرده است یا خیر! آنها در عرض چند ثانیه و بر اساس آراستگی بندها، لحن قاطع، نبود تردید و همنوایی پاسخ با پیشفرض نهفته در سوال کاربر به متن امتیاز میدهند.
دو پژوهش داوریشده در کنفرانس ICLR پیامدهای خطرناک معادلهی (5) را مستند کردهاند. نخست، شارما و همکاران در پژوهشگاه آنتروپیک (ICLR 2024) [12] ثابت کردند که مدلهای پاداش RLHF بهطور سیستماتیک به «چاپلوسی و همجهتشدن با کاربر» (Sycophancy) پاداش میدهند؛ یعنی مدل نتیجهگیری خود را طوری تنظیم میکند که پیشداوری نهفته در پرامپت کاربر را تایید کند، نه حقیقت عینی را. اگر کاربری بنویسد «توضیح بده چرا طلا آمادهی جهش به بالای 4,200 است»، مدل بلافاصله استدلالی صعودی و بسیار موجه میتراشد؛ و اگر دو دقیقه بعد همان کاربر بپرسد «توضیح بده چرا طلا در حال تشکیل سقف برای سقوط به زیر 3,600 است»، همان مدل با همان صلابت یک کیفرخواست نزولی مینویسد.
دوم، ون و همکاران (ICLR 2025) [13] نشان دادند که فرآیند RLHF ناخواسته به مدلهای زبانی «سفسطهی متقاعدکننده» (U-Sophistry) میآموزد: مدلها یاد میگیرند چگونه پاسخهای نادرست را با چنان ساختار منسجم و لحن علمی متقاعدکنندهای بستهبندی کنند که ارزیاب انسانی در زمان محدود فریب بخورد و نرخ اعتماد کاذب انسانها بالا برود! در کنار این تلهی اقناعی، شیونگ و همکاران (ICLR 2024) [14] کالیبراسیون اعتمادبهنفس کلامی مدلهای زبانی را سنجیدند و نشان دادند این مدلها دچار بیشاطمینانی مزمن هستند: جایی که دقت واقعی پاسخهایشان در حد پرتاب سکه (50%) است، در متن خود از «احتمال موفقیت 80 تا 85 درصدی» سخن میگویند.
معادلهی (5) راز ویروسی شدن این محتواها در اینستاگرام، یوتیوب و تیکتاک را برملا میکند. کسی که پرامپت را مینویسد میتواند از مدل بخواهد پاسخی با ادبیات بسیار سنگین، قانعکننده و شبیه به مدیران صندوقهای کمّی تولید کند. فرآیند RLHF دقیقاً برای بیشینه کردن همین حس متقاعدکنندگی (rφhuman) بهینه شده است؛ اما در زیر این پوسته، هیچ معادلهی کالیبرهشدهای وجود ندارد و مخاطب صرفاً فریب زیبایی نگارش را میخورد.
حال تکلیف مقالات خبری یا پستهایی که ادعا میکنند ChatGPT یا GPT-4 در بکتستهای تاریخی سالهای 2018 تا 2023 شاخص بازار را شکست دادهاند چیست؟ دو پژوهش دانشگاهی دقیق این ادعاها را باطل کردهاند. نخست، شیه، هان، لای، پنگ و هوانگ [10] در مقالهی معروف «تازهکار والاستریت» (The Wall Street Neophyte) عملکرد بدون پیشآموزش ChatGPT را (حتی به همراه زنجیرهی استدلال Chain-of-Thought و دادههای متنی شبکههای اجتماعی) در پیشبینی حرکت قیمت سهام آزمودند و نشان دادند این مدل نه تنها از شبکههای عصبی کمی تخصصی، بلکه حتی از رگرسیونهای خطی و خودهمبستهی پایهای نیز ضعیفتر عمل میکند.
دوم، سرکار و وفا در دانشگاه شیکاگو و دانشگاه هاروارد [11] اثبات کردند که بخش عمدهای از بازده ظاهری مدلهای زبانی در بکتستهای تاریخی ناشی از تورش نگاه به آینده در دادههای پیشآموزش (Pretraining Look-Ahead Bias) است. از آنجا که مدلهای پایه روی آرشیو کامل اینترنت تا تاریخ برش دانشی خود آموزش دیدهاند، میلیاردها وزن شبکه بهطور ضمنی نتیجهی گزارشهای سود، سقوط دوران کرونا، جهشهای تورمی و رالیهای تاریخی بیتکوین و طلا را که پس از تاریخ فرضی پرامپت رخ دادهاند در حافظه دارند. حتی دستور دادن در پرامپت مبنی بر «نادیده گرفتن اطلاعات پس از سال 2021» قادر به پاک کردن این همبستگیهای ذخیرهشده در وزنها نیست [11]. به محض آنکه زمان از مرز برش دانشی مدل عبور میکند و مدل برابر کندلهای زندهی دیدهنشده قرار میگیرد، آن آلفای خیالی دود میشود و از بین میرود. جدول 1 این هفت بعد ساختاری را در چهار پارادایم مختلف مقایسه میکند.
| بعد ارزیابی علمی و مهندسی | مدل زبانی متنی (ChatGPT / Claude / DeepSeek) |
مدل چندوجهی بینایی-زبانی (VLM) روی تصویر چارت |
مدل سری زمانی پیچیدهشده دور LLM (Time-LLM / GPT4TS) |
معماری 4CastMachine AI (Quad-AI تفکیکشده بر حسب قلمرو) |
|---|---|---|---|---|
| بازنمایی ذاتی ورودی | رشتههای زیرواژهای گسستهی BPE؛ تخریب فاصلهی اقلیدسی اعداد [5] |
تکههای پیکسلی 14×14 فشردهشده در فضای واژگان متنی [8] |
نگاشت تکههای عددی به تعبیههای منجمد زبانی [1] | تانسورهای دقیق ممیز شناور IEEE-754 OHLCV + رمزگذار متنی ایزوله |
| تابع زیان آموزش | آنتروپی متقاطع واژگانی + ترجیح ظاهری انسان در RLHF [12, 13] |
زیان تطبیقی تصویر و زیرنویس متنی | بازسازی تکهها با عبور غیرضروری از لایههای زبانی | قواعد امتیازدهی سرهی پیوسته (CRPS، برایر) + هندسهی ریسک |
| تکرارپذیری در 100 اجرا | مردود: واگرایی در نمونهبرداری و نوسان 10-15% حتی در τ=0 [4] |
مردود: حساس به کادربندی، زوم، رنگ چارت و جملهبندی پرامپت [8] | قطعی در صورت حذف نمونهبرداری؛ اتلاف صدبرابری محاسبات [1] | 100% قطعی و تکرارپذیر: Varrun(ŷt) = 0 روی فیلتراسیون ثابت ℱt |
| آسیبپذیری نسبت به توهم | دارای کران پایین ریاضی گود-تورینگ در وضعیتهای نوظهور [2, 3] | جعل خطوط روند و خوانش اشتباه محور قیمت در چارتهای شلوغ | وزنهای LLM دقت را نسبت به لایهی ساده افزایش نمیدهند [1] |
دیوار آتش معنایی: مدل متنی هرگز عدد قیمت تولید نمیکند |
| ریسک چاپلوسی در پرامپت | بسیار بالا: تغییر جهت صعودی/نزولی طبق تمایل نویسندهی پرامپت [12] | بالا: تورش ذاتی به سمت صعودی دیدن و بیحسی به افق زمانی [8] | پایین، اما مستعد نشت حافظهی پیشآموزش | صفر: محاسبهی ریاضی غیرمحاورهای و مستقل از لحن کاربر |
| سلامت ممیزی تاریخی | آلوده به نشت اطلاعات آینده در پیکرهی پیشآموزش اینترنتی [11] | آلوده در صورت قرار داشتن تاریخ یا نماد چارت در حافظهی مدل | نیازمند جداسازی اکید پیشرونده و پردازش سنگین | آرشیو علیتی و پیشروندهی ممیزیشده (ثبت مستمر از سال 2015) |
| خروجی عملیاتی مدیریت ریسک | نثر ابطالناپذیر همراه با بیشاطمینانی کلامی کالیبرهنشده [14] | نامگذاری کیفی امواج بدون مرز ابطال کمی | عدد نقطهای یا چندکی فاقد نقشهی رژیم بازار | نواحی صریح Buy/Sell Zone، مرز Pivot، اهداف TP1-TP5 و DTO |
5. جایگاه اصولی مدلهای زبانی کجاست؟ دیوار آتش معنایی در Sentiment AI در برابر موتورهای کمی
اثبات اینکه مدلهای زبانی مولد در محاسبات کمی قیمت ناتوان هستند، به هیچ عنوان به این معنا نیست که ترنسفورمرهای زبان طبیعی هیچ جایگاهی در مهندسی مالی مدرن ندارند. استفاده از یک LLM برای محاسبهی احتمال کندلی یا استخراج هندسهی حمایت و مقاومت چندتایمفریمی، مانند استفاده از یک میکروفون استودیویی حساس به عنوان جک هیدرولیک است؛ شکست نه از بیکیفیت بودن ابزار، بلکه از به کار بردن آن در قلمرو فیزیکی نادرست ناشی میشود. هنگامی که مدلهای زبانی منحصراً به قلمرو «متن بدون ساختار انسانی» محدود شوند، وظیفهای را انجام میدهند که فیلترهای صرفاً عددی قیمت بهتنهایی از پس آن برنمیآیند.
در هر روز معاملاتی، روسای بانکهای مرکزی بیانیههای سیاست پولی صادر میکنند، مراکز آمار اصلاحیههای تورم و اشتغال را منتشر میسازند، خبرگزاریها شوکهای ناگهانی ژئوپولیتیک و زنجیرهی تامین را مخابره میکنند و هزاران گزارش تحلیلی روی خروجی رسانهها قرار میگیرد. پیش از آنکه اثر کامل این رخدادها در دفتر سفارشها تسویه شود، محتوای معنایی آنها صرفاً در قالب رشتههای متنی بدون ساختار (Dt) وجود دارد. مدلهای زبانی تخصصیشدهی مالی (بر پایهی یافتههای واژگان مالی لوگران و مکدونالد [17] و بازنمایی متنی FinBERT ارائهشده توسط آراجی [18]) در خواندن آنی هزاران سرخط خبری، درک ظرافتهای زبانی بانکهای مرکزی و سنجش بار مثبت یا منفی خبر عملکردی کمنظیر دارند.
در درون معماری 4CastMachine AI، ما دقیقاً از همین نقطهی قوت در موتور دوم (Sentiment AI) بهره میگیریم، اما همزمان یک مرز معماری نفوذناپذیر به نام دیوار آتش معنایی (Semantic Firewall) را پیاده کردهایم. در موتور Sentiment AI، هرگز از مدل زبانی پرسیده نمیشود که فردا قیمت بیتکوین یا طلا به چه عددی میرسد، هرگز به آن اجازه داده نمیشود ناحیهی ورود یا حد ضرر رسم کند و هرگز حق ندارد متنی داستانی و اغواکننده خطاب به معاملهگر بنویسد. در عوض، Sentiment AI صرفاً به عنوان یک حسگر معنایی کراندار عمل میکند که جریان متون زنده (Dt) و آرشیو رویدادهای مشابه گذشته (ℋhist) را به یک بردار عددی کالیبرهشده و کمبعد تبدیل میسازد:
تکتک اجزای معادلهی (6) را گامبهگام دنبال کنید تا ببینید چگونه هر چهار موتور درون Quad-AI دقیقاً در قلمرو معتبر ریاضی خود کار میکنند:
- موتور 2 · Sentiment AI (ℰSentiment، پاسخ به «چرا رخ میدهد؟ / The Why»): جریان زنده و چندمنبعی اخبار (Dt) را با مدل زبانی مالی میخواند تا قطبیت جهتی کراندار pt ∈ [-1, +1] (میزان مثبت یا منفی بودن خبر)، غافلگیری استانداردشدهی تقویم اقتصادی ze,t، شباهت کسینوسی معنایی simcos(𝐞(Dt), 𝐞(ℋhist)) با رویدادهای مشابه تاریخی که میزان تاثیر واقعی آنها بر نوسان گذشته ثبت شده است، و شدت ورود خبر هاوکس λt را استخراج کند. خروجی این موتور صرفاً بردار عددی 𝐳tnews است، نه یک مظنهی قیمتی.
- موتور 1 · Forecast AI (𝒬Fcst، پاسخ به «چه رخ میدهد؟ / The What»): منحصراً روی تانسورهای پیوستهی ممیز شناور قیمت و حجم (𝐗t-L:t) در هر نه تایمفریم (
1mتاM) کار میکند و ساختار چندتایمفریمی بازار، تناسبات هارمونیک و هندسی امواج، نواحی عرضه و تقاضا و احتمالهای کندلی کالیبرهشدهی مدل فرصت معاملاتی روزانه (DTO) را بدون دخالت حتی یک توکن متنی محاسبه مینماید. - موتور 3 · Synergy AI (𝒢Syn، پاسخ به «چگونه ترکیب شوند؟ / The How»): به کمک دروازهبندی پیوستهی سافتمکس وابسته به رژیم بازار (که اثبات کامل آن در مقالهی وزندهی پویای Synergy AI آمده است)، وزن نسبی میان
Forecast AIو بردار خبریSentiment AIرا لحظهبهلحظه تنظیم میکند تا در ساعات آرام، نویز رسانهای سرکوب شود و در شوکهای خبری بزرگ، وزن غافلگیری کلان بالا برود. - موتور 4 · Navigator AI (𝒩Nav، پاسخ به «اکنون دقیقاً چه باید کرد؟ / What to Do»): یک بهینهسازی تجویزی و کاملاً قطعی را روی سطح احتمال همگراشده حل میکند تا یک نقشهی راه ابطالپذیر (ℛt) روی چارت رسم شود: نواحی دقیق
Buy zoneیاSell zone، مرز صریح ابطال تحلیل (Pivot)، نردبان اهداف سود (TP1تاTP5)، ناحیهی چرخش مشروط (Reverse zone) و مسیر فلشهای سبز (Green Arrows).
به همان تمثیل خبرنگار روزنامه بازگردید. در معادلهی (6)، ما آن خبرنگار تندخوان (Sentiment AI) را صرفاً استخدام کردهایم تا در پنجاه میلیثانیه هزاران خبر تازه را بخواند، میزان مثبت یا منفی بودن لحن بیانیه را نمرهدهی کند و بگوید این خبر چقدر شبیه شوکهای تاریخی آرشیو است. اما ما هرگز گچ و تختهسیاه معادلات دیفرانسیل را دست خبرنگار نمیدهیم! تمام محاسبات مسیر قیمت، وزندهی رژیم و هندسهی حد ضرر در پاییندست این دیوار آتش و منحصراً توسط موتورهای ریاضی و کمی (Forecast AI، Synergy AI و Navigator AI) به انجام میرسد.
همین تفکیک دقیق وظایف در سرتاسر اکوسیستم نه هوش مصنوعی ForecastCity برقرار است. رابطهای تعاملی و زبانی همچون AI Trading Assistant به کاربر کمک میکنند ابزارهای محیط کاری یا قواعد مکتوب استراتژی خود را به زبان ساده مدیریت کند، در حالی که AI Strategy Studio، حسابهای مجازی (Virtual Accounts) و موتور 4CastMachine AI صددرصد محاسبات کمی را بهصورت قطعی روی کندلهای تاریخی و زنده اجرا میکنند. جدول 2 مرز دقیق میان وظایف زبانی و وظایف کمی را خلاصه میکند.
| وظیفه در سیستم تصمیمیار مالی | ماهیت ریاضی داده | پارادایم صحیح هوش مصنوعی | پیامد بهکارگیری نادرست LLM مولد |
|---|---|---|---|
| خوانش بیانیههای بانک مرکزی و سرخط اخبار | زبان طبیعی گسسته و بدون ساختار Dt ∈ 𝒱* | پردازش زبان مالی و رمزگذار متنی (Sentiment AI) |
قلمرو کاملاً معتبر به شرط محدود ماندن خروجی به اسکالرهای قطبیت و شباهت رویداد |
| محاسبهی حمایت و مقاومت، هارمونیک و احتمال کندل | تانسور حقیقی پیوسته 𝐗t-L:t ∈ ℝL×d | مدل فضای حالت و برآوردگرهای دامنهای (Forecast AI) |
اعوجاج متریک BPE، سقوط 65% دقت با نویز حاشیهای [7] و جعل اعداد قیمتی |
| تنظیم وزن تکنیکال در برابر شتاب اخبار زنده | فضای مشترک پرش-انتشار و شدت ورود هاوکس | ترکیب متخصصان سافتمکس پیوسته (Synergy AI) |
چرخش دلبخواهی روایت و سوگیری شدید به آخرین جملهی خبری داخل پرامپت |
| تعیین نواحی ورود، مرز ابطال Pivot و اهداف TP1-TP5 | بهینهسازی مقید زمان توقف و هندسهی ریسک | بهینهسازی تجویزی نقشهی چارت (Navigator AI) |
متن ابطالناپذیر، نبود حد ابطال ساختاری و افت سرمایهی نامتقارن |
6. شواهد چارت زنده: نقشهی راه قطعی Quad-AI روی BTCUSD (تایمفریم D) و XAUUSD (تایمفریم 4h) در برابر سرگردانی روایتهای زبانی
برای آنکه تضاد میان نثرپردازی چتباتها و پیشبینی کمی قطعی کاملاً ملموس شود، دو چارت زندهی ثبتشده از محیط عملیاتی 4CM-AI Charts را در دو کلاس دارایی و دو افق زمانی متفاوت بررسی میکنیم: بیتکوین (BTCUSD) در تایمفریم روزانه (D) و طلای جهانی (XAUUSD) در تایمفریم چهارساعته (4h).
نخست تصور کنید هنگامی که بیتکوین پس از اصلاح از قلهی پاییزی نزدیک 87,000 در حوالی قیمت نقدی 64,570.00 معامله میشود، یک کاربر یا تولیدکنندهی محتوای شبکههای اجتماعی تصویر کندلها یا جدول قیمت را به یک مدل زبانی عمومی بدهد و بپرسد مسیر بعدی بیتکوین کجاست. در پرسشهای متوالی، مدلهای محاورهای به داستانهای ناسازگاری منشعب میشوند: یک اجرا تحت تاثیر کندلهای قرمز اخیر نوامبر هشدار ریزش فوری تا $50,000 میدهد؛ اجرای بعدی کلیات پذیرش نهادی بیتکوین را تکرار کرده و وعدهی جهش مستقیم به $90,000 میدهد؛ و اجرای سوم ترازهای فیبوناچی تقریبی و نادرستی میسازد که با سقف و کف واقعی موج روی چارت همخوانی ندارند. هیچیک از این متنها مرز دقیق ابطال تحلیل را مشخص نمیکنند و توضیح نمیدهند چرا تایمفریمهای درونروزی با روند روزانه واگرایی دارند.
اکنون به شکل 3 نگاه کنید که نقشهی راه کاملاً قطعی و تکرارپذیر 4CastMachine AI را روی چارت روزانهی BTCUSD نشان میدهد؛ نقشهای که مستقیماً از مختصات پیوستهی OHLCV محاسبه و میان تایمفریمها همگرا شده است.
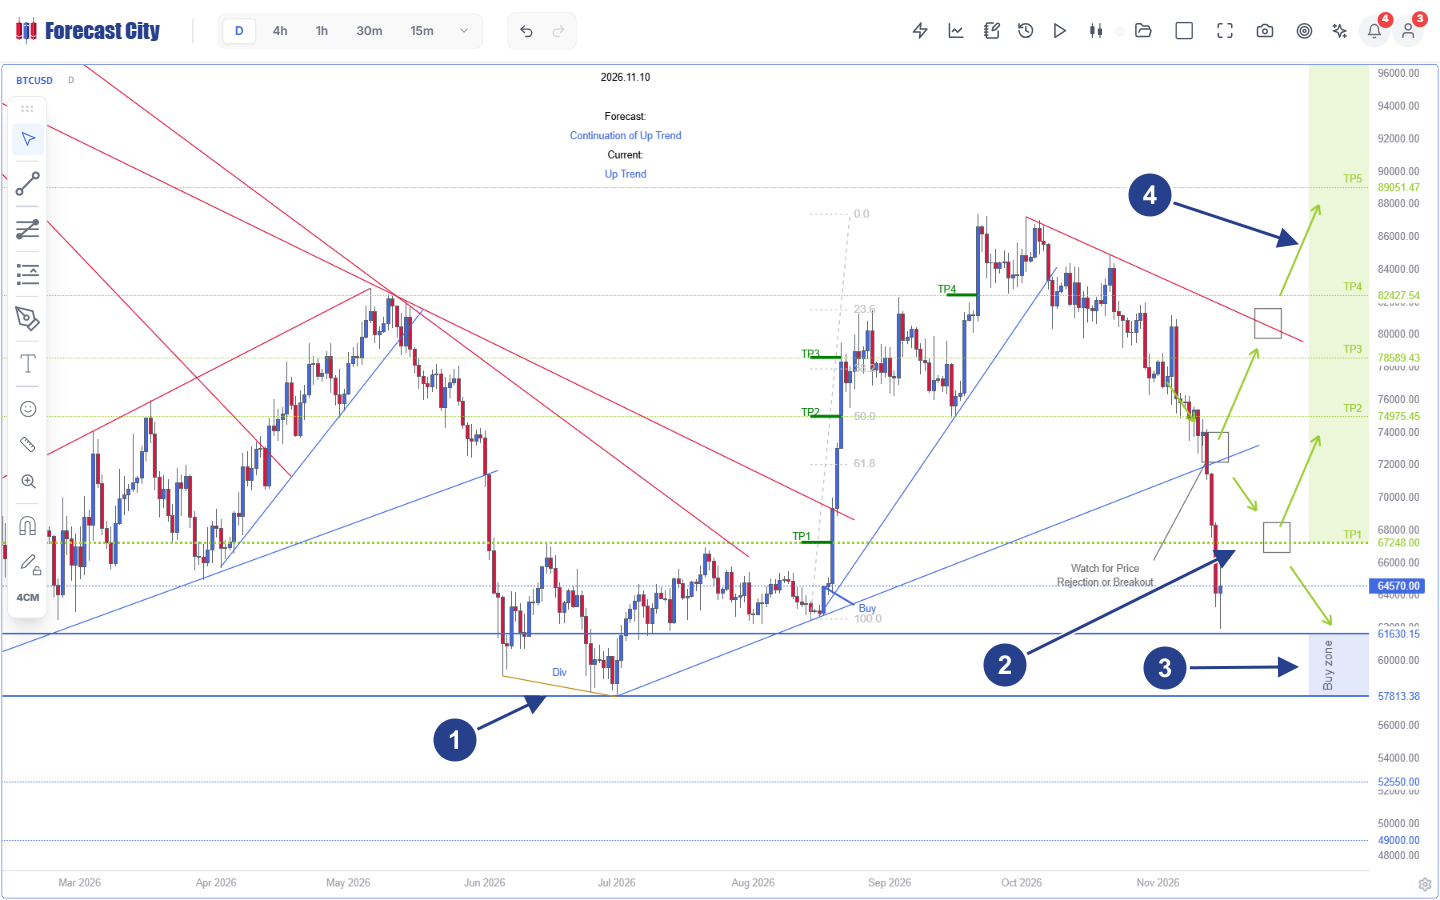
BTCUSD، تایمفریم روزانهی D، قیمت لحظهای 64,570.00): برخلاف متون تصادفی مدلهای زبانی که در هر بار اجرا تغییر میکنند، معماری Quad-AI هندسهی مختصاتی دقیق و تکرارپذیری را بر پایهی سوئینگهای ممیزیشده و گرههای تصمیم مشروط ترسیم میکند.
- 1پایهی ساختاری ممیزیشده (
Divو موج فیبوناچی100.0-0.0): واگرایی صعودی ژوئن و ژوئیه در کف57,813.38و نقطهی ورودBuyدر ماه اوت که به ترتیب اهداف تاریخیTP1،TP2،TP3وTP4را محقق کرده است. - 2گرههای تصمیم مشروط: سه کادر صریح
Watch for Price Rejection or Breakoutروی خط حمایت شکستهشدهی آبی و خط روند نزولی قرمز که جایگزین جملات مبهم متنی با شروط هندسی آزمونپذیر میشوند. - 3ناحیهی تقاضای کمیشده (
Buy zoneاز57,813.38تا61,630.15): باند تقاضای ساختاری در زیر قیمت جاری64,570.00به همراه کفهای حمایتی عمیقتر در52,550.00و49,000.00. - 4نردبان پلهای اهداف سود (
Profit zoneازTP1تاTP5): اهداف صعودی تکرارپذیر در سطوحTP1 = 67,248.00،TP2 = 74,975.45،TP3 = 78,589.43،TP4 = 82,427.54وTP5 = 89,051.47.
به همخوانی چندتایمفریمی پشت شکل 3 دقت کنید. در قیمت نقدی 64,570.00، اصلاح کوتاهمدت در افقهای پایینتر فعال است (30m نزولی زیر 66,422.24، 1h نزولی زیر 67,566.58 و 4h نزولی زیر 72,769.47)، در حالی که ساختار کلان هفتگی بالای 48,879.14 صعودی است و ادامهی روند روزانه با تثبیت بالای 67,248.00 (TP1) تایید میشود. موتور Navigator AI به جای حدس زدن کورکورانه دربارهی نقطهی توقف کندل قرمز فعلی، هر دو شاخهی شرطی را دقیق مشخص میکند: یا قیمت درون باند تقاضای 57,813.38 تا 61,630.15 (Buy zone) واکنش بازگشتی ثبت میکند، یا با بازپسگیری گره تصمیم 67,248.00 مسیر اصلی صعود به سمت 74,975.45 (TP2) و 89,051.47 (TP5) را از سر میگیرد.
فاصلهی میان نگاه ظاهری به امواج و محاسبات مختصات پیوسته، در تایمفریمهای پایینتر همچون چهارساعته (4h) باز هم آشکارتر میشود؛ جایی که برخورد خطوط روند بادبزنی، تغییر قطبیت سطوح و مرزهای ابطال فشرده نیازمند دقت سنتبهسنت هستند. شکل 4 چارت چهارساعتهی طلا (XAUUSD) را در قیمت لحظهای 3,879.59 نشان میدهد.
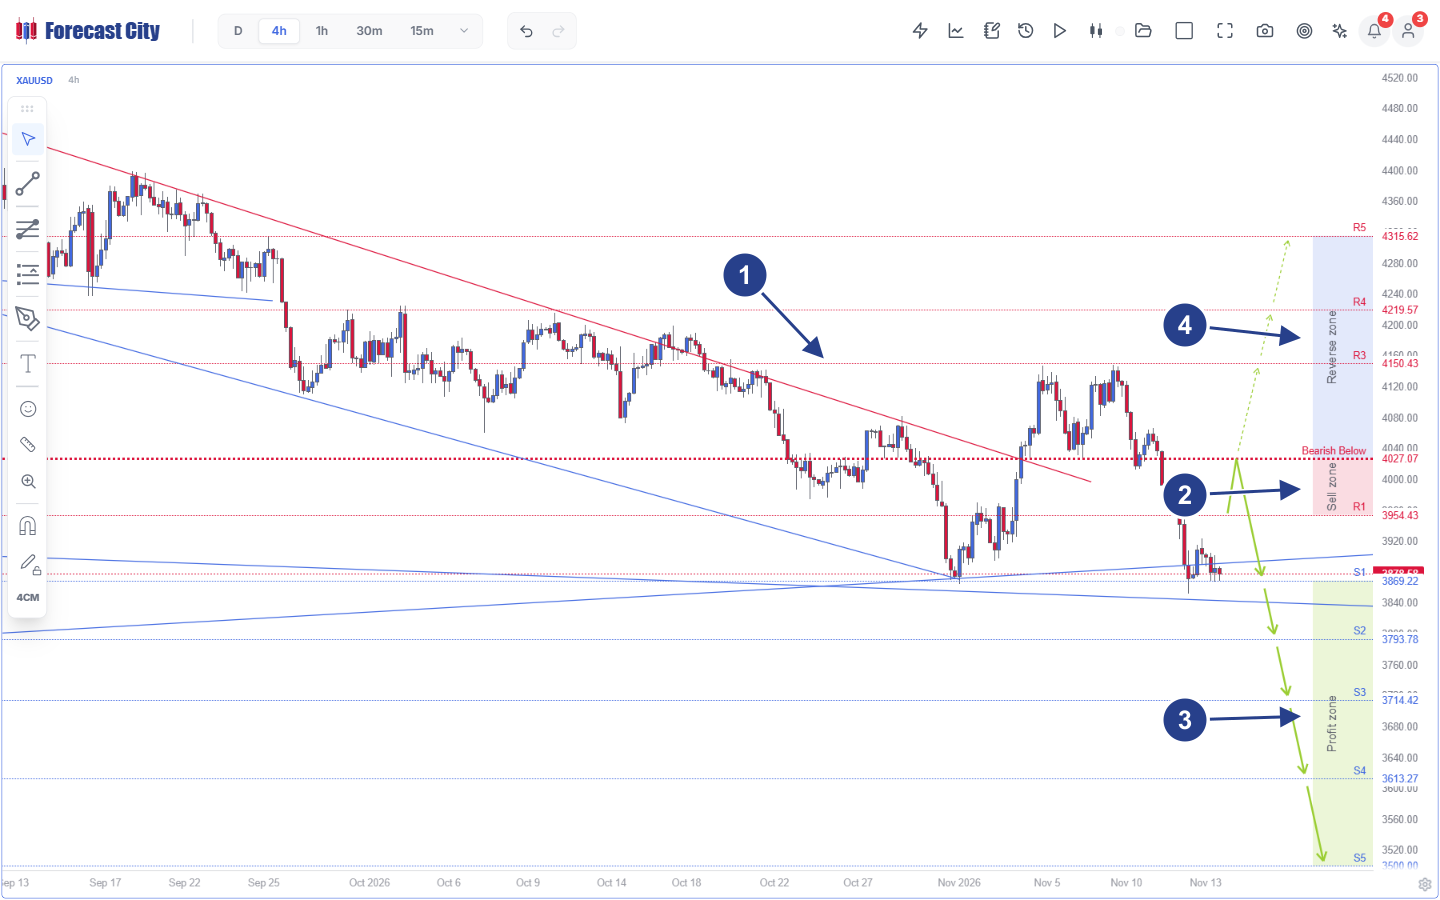
XAUUSD، تایمفریم 4h، قیمت لحظهای 3,879.59): در مقیاسی که تکهبندی پیکسلی مدلهای VLM سایهی کندلها و برخورد خطوط بادبزنی را تار میکند، Quad-AI مختصات دقیق دو سناریوی اصلی و جایگزین را از R5 (4,315.62) تا S5 (3,500.00) تفکیک میسازد.
- 1هندسهی چندروزهی امواج و خطوط روند: شکست خط مقاومت نزولی قرمز ماه سپتامبر در ابتدای نوامبر، تشکیل سقف دوقلوی برگشتی در زیر
4,150.43و بازگشت قیمت به روی همگرایی خطوط حمایت آبی در حوالی3,869.22. - 2ناحیهی عرضه (
Sell zone) و مرز قطعی ابطال (Pivot): محدودهی اصلاحی فروش ازR1 = 3,954.43که به محض عبور قیمت از مرزBearish Below 4,027.07بهطور عینی باطل میشود. - 3مسیر اصلی فلشهای سبز و
Profit zone(S1تاS5): مسیر نزولی اصلی به سمت اهدافS1 = 3,869.22،S2 = 3,793.78،S3 = 3,714.42،S4 = 3,613.27وS5 = 3,500.00. - 4ناحیهی چرخش مشروط (
Reverse zoneازR3تاR5): مسیر صعودی جایگزین (Dashed Arrows) به سمتR3 = 4,150.43،R4 = 4,219.57وR5 = 4,315.62که تنها در صورت شکست مرز ابطال4,027.07فعال میگردد.
نحوهی مدیریت ریسک سرمایه را روی وضعیت زندهی طلا در تایمفریم 4h (شکل 4، قیمت لحظهای 3,879.59) میان این دو رویکرد مقایسه کنید:
1. الگوی شکست مدل محاورهای LLM / VLM: چتبات با دیدن کندلهای ریزشی تند از 4,145 تا 3,879.59، یا هیجانزده فروش فوری در همان قیمت 3,879.59 دقیقاً روی خط حمایت آبی S1 = 3,869.22 را توصیه میکند (که معاملهی فروش را در معرض جهش اصلاحی $75 تا $147 قرار میدهد)، و یا بدون ارائهی سطح ابطال مشخص، دم از «اشباع فروش» میزند. در ده بار تکرار پرامپت نیز ده عدد حد ضرر متفاوت با اطمینان کلامی کاذب تحویل میدهد [4, 14].
2. هندسهی اجرایی قطعی در Quad-AI: در قیمت لحظهای 3,879.59، قیمت تنها $10.37 بالاتر از S1 = 3,869.22 و در عوض $147.48 پایینتر از مرز ابطال 4,027.07 قرار دارد؛ بنابراین ورود هیجانی در قیمت بازار نسبت پاداش به ریسک بسیار ضعیف 10.37 / 147.48 = 0.070 تا هدف اول ایجاد میکند. در مقابل، صبر برای اصلاح قیمت به میانهی Sell zone (تراز 3,990.75 در میانهی R1 = 3,954.43 و Pivot = 4,027.07) فاصلهی ابطال ساختاری را به 4,027.07 - 3,990.75 = $36.32 فشرده میسازد و همزمان فاصلهی سود تا S2 = 3,793.78 را به $196.97 (نسبت پاداش به ریسک 5.42 : 1) و تا S3 = 3,714.42 را به $276.33 (نسبت پاداش به ریسک 7.61 : 1) ارتقا میدهد. تکتک این مختصات در 100 بار از 100 بار ارزیابی بدون یک سنت تغییر تکرار میشوند. علاقهمندان میتوانند قواعد اجرایی گامبهگام این نواحی را در دورهی استراتژی Trend Hunter در آکادمی ForecastCity و فهرست کامل مراجع علمی را در صفحهی منابع علمی آکادمی مطالعه کنند.
پرسشهای متداول فنی
آیا قرار دادن temperature = 0 یا استفاده از پرامپتنویسی Chain-of-Thought مدل زبانی را برای پیشبینی بازار قابل اعتماد میکند؟
خیر. آتیل و همکاران [4] اثبات کردند که حتی در temperature = 0 و با بذر تصادفی ثابت، مدلهای زبانی پیشرو به دلیل شرکتناپذیری جمع ممیز شناور 16 بیتی در دستهبندی پویای سرورهای گرافیکی تا 10% الی 15% در پاسخهای خود نوسان دارند. تکنیک زنجیرهی استدلال (Chain-of-Thought) نیز همچنان روی توکنهای تکهتکهشدهی BPE کار میکند که طبق پژوهش شرکت اپل (GSM-Symbolic [7]) با تغییر سادهی اعداد یا افزودن یک جملهی حاشیهای بازار، دقت ریاضی آن تا 65% فرو میریزد.
چرا مدلهای بینایی-زبانی چندوجهی (VLMs) حتی هنگام دریافت تصویر تمیز چارت کندلی شکست میخورند؟
مدلهای چندوجهی VLM تصویر چارت را به تکههای درشت 14×14 یا 16×16 پیکسلی تقسیم کرده و به فضای توکنهای واژگانی فشرده میکنند. اگرچه این مدلها همانند نگاه سطحی انسان شکل کلی موجها را نامگذاری میکنند، بنچمارک هو و همکاران [8] نشان میدهد که نسبت دقیق سایههای OHLC و مقیاس نوسان ATR را از دست میدهند، تورش صعودی شدیدی دارند و در بازارهای خنثی یا پرتلاطم ضریب اطلاعاتی آنها در برابر مدلهای کمی مبتنی بر تانسور IEEE-754 به نزدیک صفر سقوط میکند.
چرا برخی ویدیوها و بکتستهای شبکههای اجتماعی ادعا میکنند ChatGPT یا GPT-4 بازار سهام و کریپتو را شکست دادهاند؟
سرکار و وفا در دانشگاه شیکاگو و هاروارد [11] ثابت کردند که بکتستهای تاریخی روی مدلهای زبانی ازپیشآموزشدیده دچار آلودگی شدید «نگاه به آینده» (Look-Ahead Bias) هستند؛ زیرا وزنهای شبکه نتایج واقعی رویدادهای اقتصادی و قیمتی رخداده پیش از تاریخ برش دانشی مدل را در حافظه دارند. هنگامی که همین مدلها روی کندلهای زندهی خارج از نمونه یا تحت آزمایشهای حذفی دقیق (تان و همکاران در NeurIPS 2024 [1] و شیه و همکاران [10]) سنجیده میشوند، هیچ برتری عددی نسبت به مدلهای کمی ندارند.
سیستم 4CastMachine AI چگونه در موتور Sentiment AI از مدل زبانی استفاده میکند بدون آنکه معاملهگر در معرض توهم عددی قرار بگیرد؟
در معماری Quad-AI یک دیوار آتش معنایی سختگیرانه تعبیه شده است. مدلهای زبانی تخصصی مالی درون موتور Sentiment AI منحصراً برای خواندن متون خبری، سنجش میزان مثبت یا منفی بودن خبر و شباهتسنجی معنایی با رویدادهای تاریخی به کار میروند و خروجی آنها صرفاً اسکالرهای عددی کراندار [pt, ze,t, sim, λt] است. هیچ مدل زبانی هرگز اجازهی تولید هدف قیمتی ندارد و تمامی توزیعهای احتمال، وزندهی رژیم و نواحی چارت بهطور قطعی توسط Forecast AI، Synergy AI و Navigator AI محاسبه میشوند.
مقالات داوریشده و منابع پژوهشی
- [1]Tan, M., Merrill, M. A., Gupta, V., Althoff, T., & Hartvigsen, T. (2024). Are Language Models Actually Useful for Time Series Forecasting? Advances in Neural Information Processing Systems (NeurIPS 2024 Spotlight), 37.
- [2]Kalai, A. T., & Vempala, S. S. (2024). Calibrated Language Models Must Hallucinate. Proceedings of the 56th Annual ACM Symposium on Theory of Computing (STOC 2024), 160-171.
- [3]Xu, Z., Jain, S., & Kankanhalli, M. (2024). Hallucination is Inevitable: An Innate Limitation of Large Language Models. arXiv preprint arXiv:2401.11817.
- [4]Atil, B., Chittams, A., Fu, L., Ture, F., Xu, L., & Baldwin, B. (2024). LLM Stability: A Detailed Analysis with Some Surprises. arXiv preprint arXiv:2408.04667.
- [5]Singh, A. K., & Strouse, D. J. (2024). Tokenization Counts: The Impact of Tokenization on Arithmetic in Frontier LLMs. arXiv preprint arXiv:2402.14903.
- [6]Dziri, N., Lu, X., Sclar, M., Li, X. L., Jiang, L., Lin, B. Y., ... & Choi, Y. (2023). Faith and Fate: Limits of Transformers on Compositionality. Advances in Neural Information Processing Systems (NeurIPS 2023), 36, 70293-70332.
- [7]Mirzadeh, I., Alizadeh, K., Shahrokhi, H., Tuzel, O., Bengio, S., & Farajtabar, M. (2024). GSM-Symbolic: Understanding the Limitations of Mathematical Reasoning in Large Language Models. Apple Machine Learning Research / ICLR 2025, arXiv:2410.05229.
- [8]Hu, K., Xiao, L., Xu, S., Tang, Z., & Liu, M. (2026). Do VLMs Truly "Read" Candlesticks? A Multi-Scale Benchmark for Visual Stock Price Forecasting. arXiv preprint arXiv:2604.12659.
- [9]Jiang, J., Kelly, B., & Xiu, D. (2023). (Re-)Imag(in)ing Price Trends. The Journal of Finance, 78(6), 3193-3249.
- [10]Xie, Q., Han, W., Lai, Y., Peng, M., & Huang, J. (2023). The Wall Street Neophyte: A Zero-Shot Analysis of ChatGPT Over MultiModal Stock Movement Prediction Challenges. arXiv preprint arXiv:2304.05351.
- [11]Sarkar, S. K., & Vafa, K. (2024). Lookahead Bias in Pretrained Language Models. University of Chicago & Harvard University Working Paper, SSRN 4754678 / arXiv:2402.02092.
- [12]Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., ... & Perez, E. (2024). Towards Understanding Sycophancy in Language Models. International Conference on Learning Representations (ICLR 2024).
- [13]Wen, J., Zhong, R., Khan, A., Perez, E., Steinhardt, J., Huang, M., ... & He, H. (2025). Language Models Learn to Mislead Humans via RLHF. International Conference on Learning Representations (ICLR 2025), arXiv:2409.12822.
- [14]Xiong, M., Hu, Z., Lu, X., Li, Y., Fu, J., He, J., & Hooi, B. (2024). Can LLMs Express Their Uncertainty? An Empirical Evaluation of Confidence Elicitation in LLMs. International Conference on Learning Representations (ICLR 2024).
- [15]Zeng, A., Chen, M., Zhang, L., & Xu, Q. (2023). Are Transformers Effective for Time Series Forecasting? Proceedings of the AAAI Conference on Artificial Intelligence, 37(9), 11121-11128.
- [16]Gneiting, T., & Raftery, A. E. (2007). Strictly Proper Scoring Rules, Prediction, and Estimation. Journal of the American Statistical Association, 102(477), 359-378.
- [17]Loughran, T., & McDonald, B. (2011). When Is a Liability Not a Liability? Textual Analysis, Dictionaries, and 10-Ks. The Journal of Finance, 66(1), 35-65.
- [18]Araci, D. (2019). FinBERT: Financial Sentiment Analysis with Pre-trained Language Models. arXiv preprint arXiv:1908.10063.