YouTube, Instagram, TikTok ve X üzerindeki bireysel yatırımcı akışlarında viral bir içerik üreticisi dalgası; ChatGPT, Claude, Gemini ve DeepSeek gibi sohbet tabanlı Büyük Dil Modellerine (LLM) ve çok kipli Görsel-Dil Modellerine (VLM) Bitcoin, Altın ve döviz kuru yörüngelerini tahmin ettirmektedir. Eğitim sonrası hizalanmış dil modelleri sözdizimsel açıdan pürüzsüz ve kurumsal strateji raporlarını andıran anlatılar ürettiği için, uzman olmayan kitleler retorik akıcılığı rutin olarak kantitatif üstünlükle karıştırmaktadır. STOC, NeurIPS, ICLR, AAAI ve The Journal of Finance bünyesinde yayımlanan kuramsal bilgisayar bilimi kanıtlarına ve ampirik makine öğrenmesi kıyaslamalarına dayanan bu makale, otoregresif üretken modellerin sayısal piyasa tahmini için yapısal olarak neden elverişsiz olduğunu kanıtlamaktadır. Beş temel başarısızlık mekanizmasını biçimselleştiriyoruz: (1) alt-kelime rakam tokenizasyonu altında Öklid metrik sürekliliğinin çökmesi, (2) çok kipli VLM mimarileri mum grafiği görüntülerini incelerken oluşan kayıplı uzamsal-sözcüksel yama izdüşümü, (3) sıfır sıcaklıkta dahi tekrarlanan sorgularda ortaya çıkan çalıştırmalar arası çıktı sapması ve kaçınılmaz halüsinasyon üzerindeki Good-Turing alt sınırları, (4) tarihsel geçmiş testlerdeki (backtest) ön-eğitim geleceğe bakma (look-ahead) ezberiyle birleşen RLHF dalkavukluğu (sycophancy) ve ikna edici safsata, ve (5) sermaye riski altında yıkıcı olasılık kalibrasyonu çöküşü. Son olarak, 4CastMachine AI içindeki tavizsiz mimari sınırı tanımlıyoruz: bağlamsal dil modellerini yalnızca yapılandırılmamış haber kutupluluğunu ve tarihsel olay benzerliğini kodlamak üzere Sentiment AI içine hapsetmek; tüm sürekli fiyat geometrisini, rejim ağırlıklandırmasını ve grafik yol haritalarını ise Forecast AI, Synergy AI ve Navigator AI motorlarına devretmek.
1. Viral Kategori Hatası ve Belagatli Gazeteci Yanılgısı
Son üç yıl içinde sohbet tabanlı Büyük Dil Modelleri (LLM), doğal dilde metin kaleme alma, kod sentezi ve kapsamlı belge özetleme görevlerinde olağanüstü bir dilsel akıcılığa ulaştı. Ancak bu dilsel yetenek, bireysel finans medyasında geniş çaplı bir metodolojik hatayı tetikledi. Her gün YouTube, Instagram, TikTok ve X platformlarında yüksek erişimli içerik üreticileri; ham OHLC fiyat tablolarını veya mum grafiği ekran görüntülerini genel amaçlı sohbet modellerine yapıştırmakta ve üretilen fiyat hedeflerini milyonlarca izleyiciye canlı piyasa analizi gibi yayınlamaktadır.
İstatistiksel modelleme eğitimi almamış bir izleyicinin gözünde bu çıktı son derece otoriter görünür. Dil modeli saniyeler içinde makroekonomik katalizörleri sıralar, yükselen kama veya Fibonacci düzeltmeleri gibi tanıdık grafik formasyonlarına atıfta bulunur ve Bitcoin (BTCUSD) ya da Altın (XAUUSD) fiyatının gelecek hafta nerede işlem göreceğini anlatan pürüzsüz bir paragraf yazar. Modele kıdemli bir kurumsal stratejist üslubu benimsemesi yönünde istem (prompt) verildiğinde, model kurumsal finans terminolojisini eksiksiz bir dilbilgisel özgüvenle taklit eder.
Ne var ki bu dilsel cilânın altında uygulamalı matematik açısından temel bir kategori hatası yatmaktadır. Finansal piyasalar; limit emir defteri eşleşmeleri, değişen varyanslı (heteroskedastik) volatilite ve kalın kuyruklu sıçrama süreçleriyle yönetilen sürekli değerli, durağan-dışı ve düşük işaret-gürültü oranlı stokastik sistemlerdir. Buna karşılık otoregresif dil modelleri, insan metin derlemlerinde önceki kelime parçacıkları dizisini hangi kelime parçacığının izleme olasılığının en yüksek olduğunu tahmin etmek üzere eğitilmiş kesikli dizi üreteçleridir.
Somut bir yapısal analoji, bu iki matematiksel alanın neden birbirinin yerine kullanılamayacağını berrak biçimde ortaya koyar. Üretken bir LLM mimarisinden canlı ve çok ufuklu bir piyasa yörüngesini çözmesini istemek, belagat yeteneği güçlü bir gazete köşe yazarından gerçek zamanlı sermaye riski altında eşleşmiş doğrusal olmayan stokastik diferansiyel denklem sistemini çözmesini istemeye eşdeğerdir. Yetenekli bir gazeteci kalkülüs tarihi üzerine büyüleyici bin kelimelik bir deneme yazabilir, ünlü matematikçilerden alıntılar yapabilir ve metni o kadar temiz biçimlendirebilir ki uzman olmayan bir okuyucu denklemlerin gerçekten çözüldüğünü varsayar.
Oysa düzyazı akıcılığı sayısal integrasyon gerçekleştirmez. Daha da vahimi, üretken kod çözme (decoding) düzleştirilmiş olasılık dağılımlarından örnekleme yaptığı ve sıfıra yakınsamayan halüsinasyon oranlarından muzdarip olduğu için, bu anlatıcı stres altında belirsizliği asla kabul etmeyen sarhoş bir gazeteci gibi davranır. Birebir aynı soruyu arka arkaya iki kez sorduğunuzda anlatıcı hiçbir uyarı vermeden yönünü tam tersine çevirebilir. Aynı soruyu yüz kez sorduğunuzda ise yanıtların önemli bir kısmı, aynı retorik soğukkanlılığı korurken grafikte var olmayan destek seviyeleri uydurur veya temel aritmetik çıkarmaları yanlış hesaplar.
Bu yapısal uyumsuzluğu matematiksel kesinlikle biçimselleştirmek için, otoregresif bir dil modelinin optimizasyon hedefini kalibre edilmiş kantitatif bir tahmin motorunun optimizasyon hedefiyle karşılaştırıyoruz. Denklemleri yazmadan önce her iki kayıp fonksiyonunun eğitim sırasında neyi ödüllendirip neyi cezalandırdığına dikkat edelim. Bir dil modeli kesikli token kimlikleri üzerindeki sözcüksel şaşkınlığı (lexical surprise) minimize ederken, kantitatif bir durum-uzayı motoru sürekli reel değerli fiyat gerçekleşmeleri üzerindeki metrik mesafeyi ve olasılık kalibrasyonu hatasını minimize eder.
𝒱, büyüklüğü |𝒱| ≈ 32,000..200,000 olan sonlu bir alt-kelime dağarcığını ve v1:K ∈ 𝒱K ise tokenize edilmiş bir metin dizisini göstersin. θ parametreli otoregresif bir LLM, kesikli token çapraz entropisini ℒLLM(θ) minimize eder. Buna karşılık 𝐗t-L:t ∈ ℝL×d reel değerli bir piyasa durum tensörünü ve Pt+τ ∈ ℝ+ ise τ ufkundaki gelecek fiyatı temsil etsin. ψ parametreli kantitatif bir motor, Sürekli Sıralı Olasılık Skorunu (CRPS, Gneiting ve Raftery [16]) minimize eden kümülatif bir olasılık dağılımı Fψ(y | 𝐗t-L:t) üretir:
Denklem (1) içinde ℒLLM(θ), sözlük dizini vk üzerinde kategorik bir tek-sıcak (one-hot) göstergeyi değerlendirir: sayısal büyüklük farkı ne olursa olsun her yanlış token birebir aynı negatif log-olabilirlik cezasını alır. Tersine CRPS(Fψ, Pt+τ), karesel kümülatif olasılık hatasını tüm reel sayı doğrusu ℝ boyunca integre ederek hem gerçekleşen fiyata Pt+τ olan metrik uzaklığı hem de kalibre edilmemiş dağılım yayılımını katı biçimde cezalandırır.
Bitcoin'in 64,570 seviyesinden işlem gördüğünü ve yarınki gerçek adil değerin 65,000 olduğunu varsayalım. Kesikli token çapraz entropisi ℒLLM altında, "95"+",000" birleşimi kurumsal metin derlemlerinde yüksek frekanslı ikililer (bigram) paylaştığı her durumda, "64,999" dizisini üretmek (yalnızca $1 sapma), "95,000" dizisini üretmekten (tam $30,000 sapma!) daha yüksek bir token kaybı cezasına yol açabilir! Sürekli CRPS altında ise $30,000 büyüklüğündeki bir hata, beklenen değerde $1 hatadan otuz bin kat daha ağır cezalandırılır ve her parametre güncellemesini doğrudan gerçek finansal riske çıpalar.
Ampirik kıyaslama çalışmaları, trilyonlarca kelime üzerinde ön-eğitim yapmanın zaman serisi tahmin yeteneği kazandırmadığını doğrulamaktadır. Çığır açıcı bir NeurIPS 2024 Spotlight çalışmasında Tan, Merrill, Gupta, Althoff ve Hartvigsen [1]; standart tahmin veri setleri üzerinde Time-LLM, OneFitsAll (GPT4TS) ve CALF dahil olmak üzere önde gelen LLM tabanlı zaman serisi mimarilerini denetlemiştir. Yazarlar, önceden eğitilmiş LLM ağırlıklarını tamamen silen veya milyarlarca parametreli dil omurgasını sıfırdan eğitilmiş tek bir hafif dikkat (attention) ya da doğrusal yama (linear patching) katmanıyla değiştiren sistematik ablasyon deneyleri gerçekleştirmiştir.
Elde edilen bulgular, LLM tabanlı zaman serisi tahmini iddiasının temel dayanağını çökertmiştir. Dil modeli omurgasını tamamen çıkarmak tahmin isabetinde sıfır kayba yol açmış; üstelik parametre sayısını ve çıkarım hesaplama maliyetini iki ila üç büyüklük mertebesi (100 ila 1000 kat) azaltırken Ortalama Karesel Hata (MSE) ve Ortalama Mutlak Hata (MAE) metriklerini sıklıkla iyileştirmiştir [1]. Savunucuların dilsel ön-eğitimin ardışık akıl yürütmeyi aktardığını öne sürdüğü az örnekli (few-shot) rejimlerde dahi, önceden eğitilmiş LLM ağırlıkları küçük sayısal kodlayıcılara kıyasla ölçülebilir hiçbir kazanç sağlamamıştır. Zeng, Chen, Zhang ve Xu tarafından AAAI konferansında sunulan daha önceki çalışma da [15], zamansal sıralama ve ölçek token izdüşümüyle bozulduğunda basit doğrudan doğrusal eşlemelerin karmaşık ardışık Transformer modellerini geride bıraktığını benzer biçimde kanıtlamıştır.
2. Alt-Kelime Tokenizasyonunda Metrik Çöküş ve Çok Kipli Grafik Görüşünün Neden Risk Ölçmeden Yalnızca Gestalt Dalgaları Gördüğü
Bir LLM mimarisini yedi milyar parametreden bir trilyonun üzerinde parametreye ölçeklemenin onu neden hiçbir zaman güvenilir bir kantitatif motora dönüştürmediğini anlamak için, ham piyasa sayılarına ağın daha ilk katmanında ne olduğuna bakmamız gerekir. Kantitatif algoritmalar fiyatları, hacimleri ve volatilite serilerini IEEE-754 standardında 64-bit kayan noktalı (floating-point) sayılar olarak alır. Reel sayılar tam bir metrik cisim oluşturur: toplama, çarpma, sıralama ve Öklid mesafesi donanım düzeyinde kesin temel işlemlerdir.
Dil modelleri ise kayan noktalı skaler sayıları doğrudan okuyamaz. Bir Transformer tek bir fiyatı bile görmeden önce, Byte-Pair Encoding (BPE) veya SentencePiece tabanlı bir tokenizer, ham karakter dizisini derlem sıkıştırma frekansına göre değişken uzunluklu alt-kelime parçalarına böler. Singh ve Strouse [5], öncü LLM mimarilerinin çok basamaklı sayıları soldan sağa tutarsız 1 basamaklı, 2 basamaklı veya 3 basamaklı tokenlara ayırdığını ve bu işlemin sağdan sola basamak aritmetiği ile elde (carry) mantığıyla doğrudan çarpıştığını göstermiştir.
BPE tokenizasyonunun canlı döviz ve kripto para kotasyonlarına ne yaptığına yakından bakalım. EURUSD paritesinde 1.0849 ve 1.0850 fiyatları birbirinden tam olarak 0.0001 (1 pip) uzaktadır ve neredeyse özdeş piyasa durumlarını temsil eder. Alt-kelime tokenizasyonu altında ise "0849" ve "0850" dizileri farklı tamsayı kimliklerine eşlenir; bunların ℝde uzayındaki başlangıç gömme (embedding) vektörlerinin birbirine, tam 9,000 pip uzaktaki "1.9850" tokenından daha yakın durmasını zorunlu kılan hiçbir mekanizma yoktur! Bu topolojik kopuşu, tokenizer dönüşümünün yerel metrik bozulma oranı üzerinden biçimselleştiriyoruz.
Denklem (2) içinde x, y ∈ ℝ tek bir minimum fiyat adımı δ ile ayrılan iki reel piyasa fiyatını, str(·) skaler sayıyı ondalık karakterlere dönüştüren operatörü, ΦBPE(·) ise ortaya çıkan alt-kelime dizisini havuzlanmış girdi gömme uzayına taşıyan dönüşümü gösterir. Pürüzsüz bir kantitatif modelde κ(x, y) sonlu bir Lipschitz sabitiyle sınırlıdır; böylece çok küçük fiyat kaymaları çok küçük durum değişimleri üretir. BPE metin parçalama altında ise κtok(x, y), 69,999.99 seviyesinden 70,000.00 seviyesine geçiş gibi basamak devri sınırlarında düzensiz biçimde sıçrarken, birbirinden çok uzak fiyatlar ortak sonek dizileri paylaştığında yapay olarak sıfıra doğru çöker.
Denklem (2), LLM modellerinin canlı grafikler üzerinde en temel risk hesaplamalarında neden başarısız olduğunu açıklar. Bir alt-kelime tokenizer açısından 67,248 ve 57,248 sayıları, Bitcoin üzerinde aralarında tam $10,000 fiyat farkı bulunmasına rağmen beş rakamından dördü eşleştiği için neredeyse aynı görünür! Buna karşılık yalnızca $2 aralıklı 69,999 ve 70,001 sayıları ortak tek bir rakam bile paylaşmaz. Girdi koordinat sistemi sayısal mesafeyi bu şekilde karıştıran hiçbir volatilite veya zarar-durdur motoru güvenilir biçimde çalışamaz.
Bu temsil kusuru, çok adımlı hesaplama çöküşüne dönüşerek zincirleme yayılır. Dziri vd. NeurIPS çalışmasında [6], otoregresif Transformer modellerinin çok adımlı aritmetik ve dinamik programlama problemlerini genellenebilir algoritmalar öğrenmek yerine doğrusallaştırılmış alt-çizge örüntü eşleştirmesiyle ele aldığını ve bileşimsel derinlik arttıkça doğruluğun üstel biçimde eridiğini kanıtlamıştır. Apple Machine Learning Research bünyesinde Mirzadeh vd. [7], durağan kıyaslama sabitlerini sembolik sayısal çeşitlemelerle değiştiren GSM-Symbolic testini tanıtmıştır. Bir matematik problemindeki yalnızca spesifik sayıları değiştirmek öncü LLM modellerinde keskin doğruluk dalgalanmalarına yol açmış; probleme konuyla ilgisiz tek bir bağlamsal yan cümle eklemek ise akıl yürütme isabetini %65'e varan oranda çökertmiştir [7]. Oysa finansal piyasalar her saat düzineyle gürültülü ve konu dışı makroekonomik yan bilgi üretir.
Metin tokenizasyonunun sınırlarıyla yüzleşen sosyal medya yorumcuları sıklıkla ikinci bir iddiaya sığınır: "Sayıları metin olarak yazmak yerine mum grafiğinin ekran görüntüsünü yükleyin; böylece çok kipli bir Görsel-Dil Modeli (VLM) tıpkı deneyimli bir insan teknik analist gibi dalgaları görsel olarak okuyabilir!" Yüzeysel bakıldığında bu argüman kulağa makul gelir. Bir insan fiyat grafiğine baktığında görsel korteks ardışık tepeleri, dipleri ve diyagonal trend konturlarını anında seçer. Çok kipli VLM modelleri gerçekten de bu yüzeysel insan bakışını taklit ederek görünürdeki dalgaları, üçgenleri veya omuz-baş-omuz silüetlerini akıcı bir düzyazıyla adlandırır.
Ne var ki bir dalganın niteliksel kabuğunu görmek ile kantitatif koşullu beklentiyi hesaplamak birbirinden tamamen farklı iki işlemdir. Çok kipli bir VLM 1440×900 çözünürlüklü bir grafik ekran görüntüsünü aldığında, bir Vision Transformer kodlayıcısı (ViT veya SigLIP) görüntüyü kaba 14×14 veya 16×16 piksellik yamalara doğrar ve bu görsel yamaları kayıplı doğrusal bir bağdaştırıcı (adapter) üzerinden dil modelinin kelime gömme uzayına izdüşürür. Piksel-altı fitil uçları, kesin açılış-kapanış gövde oranları, dikey fiyat ekseni doğrusal-dışılıkları ve 14 periyotluk Ortalama Gerçek Aralık (ATRt(14)) ölçeklemesi; baz puan ölçmek yerine fotoğraflara altyazı üretmek üzere optimize edilmiş anlamsal görsel tokenların içinde bulanıklaşır.
Güncel kıyaslama kanıtları, çok kipli VLM modellerinin mum grafiklerinde ne ölçüde ağır bir çöküş yaşadığını doğrulamaktadır. Hu, Xiao, Xu, Tang ve Liu [8], farklı hisse senedi ve endeks rejimleri genelinde öncü VLM mimarilerini gradyan artırımlı karar ağaçları gibi tablosal kantitatif referans modellerle sınayan çok ölçekli bir mum grafiği tahmin kıyaslaması oluşturmuştur. Değerlendirmeleri dört yapısal çöküşü belgelemektedir: (1) VLM modelleri ağır bir koşulsuz yön yanlılığı sergiler (yapı ne olursa olsun varsayılan olarak yükseliş çağrısı yapar), (2) örneklem dışı Bilgi Katsayıları (IC) trendsiz veya yüksek volatiliteli rejimlerde sıfıra doğru çöker, (3) VLM modelleri istenen tahmin ufkuna büyük ölçüde duyarsızdır (5 mumluk gürültü ile 30 mumluk yapıyı birbirine karıştırır) ve (4) doğrudan ham OHLCV öznitelikleri üzerinde çalışan tablosal sayısal modeller genel amaçlı VLM mimarilerini tutarlı biçimde geride bırakır [8].
Bu tablonun, ampirik varlık fiyatlamasında amaca özel geliştirilen kantitatif bilgisayarlı görü modelleriyle oluşturduğu keskin karşıtlığa dikkat edin. Jiang, Kelly ve Xiu görsel fiyat trendi araştırmalarını The Journal of Finance dergisinde yayımladıklarında [9], evrişimli (convolutional) mimarileri tam olarak doğal dili tamamen devre dışı bıraktıkları için başarılı olmuştu: standartlaştırılmış piksel matrisleri kesin normalleştirilmiş yüksek-düşük-kapanış koordinatlarını ve hacim çubuklarını kodlayarak denetimli istatistiksel kayıp altında doğrudan kalibre edilmiş kesitsel getiri olasılıklarına eşleniyordu. Bir grafiği sohbet tabanlı bir dil kod çözücüsünden geçirmek bu metrik kesinliği yok eder. Şekil 1, kayıplı üretken LLM/VLM hattını sürekli durumlu kantitatif hatla karşılaştırmaktadır.
LLM ve çok kipli VLM mimarilerinin N = 100 özdeş sorgu boyunca yanıtları sapan stokastik anlatılar örneklemeden önce BPE alt-kelime parçalama ve kayıplı 14×14 görsel yama izdüşümü yoluyla sayısal topolojiyi nasıl parçaladığını izler. Alt şerit (B) ise sürekli durumlu kantitatif motorların kesin IEEE-754 metrik geometrisini, ATRt(14) volatilite değişmezliğini ve sıfır çalıştırmalar arası varyansı (Varrun(ŷt) = 0) nasıl koruduğunu gösterir.3. 100 Çalıştırma Boyunca Sorgudan Sorguya Belirsizlik ve Good-Turing Halüsinasyon Alt Sınırı
Kurumsal risk mühendisliğinin en temel aksiyomlarından biri fonksiyonel determinizmdir: t mum kapanışında sabit bir piyasa filtrasyonu ℱt verildiğinde, matematiksel bir model ℱt bilgisini tekil, tekrarlanabilir bir olasılık dağılımına ve tekil risk sınırlarına eşlemek zorundadır. Bir yolcu uçağının uçuş kontrol çözücüsü, arka arkaya iki kez birebir aynı irtifa ve rüzgâr kesmesi sensör vektörüyle beslendiğinde birbiriyle çelişen iki ayrı süzülme rotası hesaplasaydı, hiçbir havacılık mühendisi o sisteme uçuş sertifikası vermezdi. Sohbet tabanlı LLM modelleri bu tekrarlanabilirlik aksiyomunu iki ayrı matematiksel düzeyde ihlal eder.
Birinci düzey, otoregresif üretim sırasındaki açık stokastik örneklemedir. Son kullanıcı ve API sohbet arayüzleri, zk logitleri üzerinde sıcaklık ölçekli ve çekirdek budamalı (top-p) bir softmax dağılımından örnekleme yaparak vk tokenını çözer. Üretim süreci nedensel ve otoregresif olduğundan, örneklenen her bir token k + 1 adımı için koşullandırma geçmişine v1:k eklenir.
Bir yatırımcı birebir aynı mum kapanışında bir LLM modelinden arka arkaya iki kez Bitcoin görünümü istediğinde içeride ne yaşandığını adım adım düşünelim. k = 14 token konumunda logit olasılıklarının "dirençli" ("resilient") sıfatına 0.44, "tükenmiş" ("exhausted") sıfatına ise 0.41 olasılık atadığını varsayalım. 1. Sorguda örnekleme "dirençli" kelimesini çeker ve izleyen tüm dikkat başlıklarını yükseliş yönlü kırılım şablonlarını çağırıp $78,000 hedefi projekte edecek biçimde koşullandırır. Birebir aynı piyasa verisi üzerinde üç saniye sonra gönderilen 2. Sorguda ise örnekleme "tükenmiş" kelimesini çeker ve sonraki tokenları dağıtım zirvesi şablonlarını çağırıp $56,000 hedefi yazacak biçimde koşullandırır. N = 100 özdeş sorgu boyunca yörüngeler, ardışık örneklemenin düşük olasılıklı dallara saptığı ve gerçekte hiç yaşanmamış fiyat geçmişleri uydurduğu kalın kuyruklu aykırı çalıştırmaları da içeren çok tepeli bir çelişkili anlatılar bulutuna yayılır.
Yaygın bir mühendislik itirazı, kod çözme sıcaklığını sıfıra sabitlemenin (τ → 0+, açgözlü argmax kod çözme) bu kararsızlığı ortadan kaldıracağını ileri sürer. Oysa ampirik sistem araştırmaları, modern GPU çıkarım kümelerinde temperature = 0 ayarının bile deterministik akıl yürütmeyi garanti edemediğini kanıtlamaktadır. Atil vd. [4], öncü LLM modellerini temperature = 0 ve sabit rastgelelik tohumlarıyla (random seed) tekrarlanan özdeş çalıştırmalar boyunca değerlendirmiş; N çalıştırma genelinde ham metin düzeyinde (TARr@N) ve ayrıştırılmış nihai yanıt düzeyinde (TARa@N) Toplam Uzlaşma Oranını tanımlamıştır. Araştırmacılar özdeş açgözlü çalıştırmalar arasında %10 ile %15'e varan doğruluk kaymaları belgelemiş ve en şiddetli sapmanın matematiksel ve çok adımlı akıl yürütme görevlerinde yaşandığını göstermiştir [4].
temperature = 0 sapmasının fiziksel nedeni, paralel GPU indirgeme ağaçları (reduction trees) içindeki IEEE-754 kayan nokta toplamasının birleşme özelliğine sahip olmaması (non-associativity) ve bunun otoregresif hata büyütmesiyle birleşmesidir:
Denklem (3) içinde ⊕BF16, dinamik sürekli-yığınlama (continuous-batching) kullanan GPU sunucularında (örneğin vLLM veya Uzman Karışımı yönlendiricilerinde) yürütülen 16-bit Brain Floating-Point toplama işlemini (yalnızca 7 mantis biti duyarlılık) gösterir. Aynı milisaniyelik GPU yığınını kaç eşzamanlı kullanıcı isteğinin paylaştığına bağlı olarak paralel CUDA iş parçacıkları matris-vektör çarpımlarını farklı bir indirgeme ağacı sırasıyla toplar ve logitleri 10-4..10-3 mertebesinde kaydırır. Birbiriyle yarışan iki finansal token neredeyse eşit logitlere sahip olduğunda (ki gürültülü %50/%50 piyasa rejimlerinde bu durum sürekli yaşanır!), o mikroskobik kayan nokta kayması tek bir tokendaki açgözlü argmax seçimini devirir ve izleyen tüm analitik paragrafı baştan sona değiştirir [4].
Denklem (3), sermaye tahsisi açısından ölümcül bir kusuru açığa çıkarır. Bir LLM API bağlantısını temperature = 0 değerine kilitleseniz bile alacağınız işlem yanıtı, tam o milisaniyede bulut GPU kümesiyle kaç yabancının sohbet ettiğine bağlı olarak değişir! Yükseliş ve düşüş anlatılarının birbirine yakın metinsel olasılıklar taşıdığı gürültülü finansal rejimlerde, küçücük GPU yuvarlama farkları erken bir kelimeyi değiştirerek tüm işlem tezini baştan yazar.
Çalıştırmalar arası kararsızlığın ötesinde çok daha derin bir kuramsal engel uzanır: halüsinasyonun matematiksel kaçınılmazlığı. Pek çok uygulayıcı halüsinasyonların daha büyük eğitim kümeleriyle zaman içinde çözülecek geçici mühendislik hataları olduğunu varsayar. 56. ACM Hesaplama Kuramı Sempozyumu'nda (STOC 2024) Kalai ve Vempala [2] bunun tam tersini kanıtlamıştır. Araştırmacılar, kalibre edilmiş herhangi bir üretken dil modelinin, doğruluğu yalnızca dilbilgisinden deterministik biçimde çıkarılamayan olguların Good-Turing tekil kütlesiyle (singleton mass) alttan sınırlanan bir oranda zorunlu olarak halüsinasyon göreceğini ispatlayan katı bir istatistiksel alt sınır ortaya koymuştur:
Denklem (4) içindeki her terimi tek tek açmak, finansal piyasaların üretken halüsinasyon açısından neden en kötü senaryo ortamını oluşturduğunu gözler önüne serer. Burada ℋfalse kulağa makul gelen ancak yanlış olan ifadeler kümesini, n1 / n gözlenmemiş dağılım kütlesinin Good-Turing tahmin edicisini (n eğitim örneği içinde yalnızca bir kez görülen durum gerçekleşmelerinin oranını), κcal(πθ) ön-eğitim sırasındaki istatistiksel kalibrasyon sapmasını ve |𝒱ded| / |𝒱arb| ise mantıksal olarak türetilebilir olguların stokastik gerçekleşmelere oranını ölçer. Xu, Jain ve Kankanhalli [3] tarafından geliştirilen tamamlayıcı hesaplanabilirlik kuramı da Gold tipi öğrenme sınırları üzerinden hiçbir hesaplanabilir LLM mimarisinin açık uçlu dünya durumlarında halüsinasyonu ortadan kaldıramayacağını kanıtlamıştır.
Denklem (4) finansal tahmini neden bu kadar sert vurur? Her günlük çoklu varlık piyasa durumu (kesin çapraz varlık fiyatları, emir defteri derinliği, getiri makasları ve makro sürprizler), tarihte en fazla bir kez gerçekleşmiş benzersiz bir sürekli durumdur (sürekli durum uzayında n1 / n → 1!). Daha önce görülmemiş yeni sürekli durumlar üzerinde çekimser kalmadan akıcı cümleler yazmayı sürdürmeye zorlanan üretken bir metin modeli, kulağa ikna edici gelen yanlışlar uydurmaya matematiksel olarak mecburdur.
Denklem (4) üzerinde yalın bir sayısal kontrol yapalım. Bir yatırımcının, tekil yenilik oranının n1 / n ≥ 0.22 ve kalibrasyon payının 0.04 olduğu alışılmadık volatilite rejimlerinde sohbet tabanlı bir LLM modeline kesin gün içi destek, direnç ve zarar-durdur koordinatları soran N = 100 sorgu gönderdiğini varsayalım. İdeal ön-eğitim koşullarında bile üretilen 100 tahminden en az 15 ila 18 tanesi doğrudan uydurulmuş sayısal iddialar (örneğin fiyatın gerçekte bulunduğu yerden yüzlerce puan uzakta bir hareketli ortalama veya Fibonacci seviyesi zikretmek gibi) içerecektir. Kaldıraçlı işlemlerde yüz işlemden yalnızca iki veya üç tanesinde bile halüsinasyon ürünü zarar-durdur koordinatı kullanmak ağır sermaye erimesini tetiklemeye yeter.
4. RLHF Kaynaklı İkna Edici Safsata, Sosyal Medya İstem Yönlendirmesi ve Ön-Eğitim Geleceğe Bakma Sızıntısı
Üretken LLM modelleri sayısal tokenizasyonda çöküyor, tekrarlanan çalıştırmalarda sapıyor ve matematiksel alt sınırlarla belirlenen oranlarda seviye uyduruyorsa, bireysel işlem kanallarında neden bir yangın gibi yayıldılar? Yanıt, eğitim sonrası hizalama (post-training alignment) mekaniğinde gizlidir. Modern sohbet modelleri, θ parametrelerini bir referans politikaya πref karşı düzenlileştirilmiş insan tercihi ödül modelini rφhuman(x, y) maksimize edecek biçimde ayarlayan İnsan Geri Bildirimiyle Pekiştirmeli Öğrenme (RLHF) veya Doğrudan Tercih Optimizasyonu (DPO) aşamalarından geçer:
Denklem (5) içindeki rφhuman(x, y) ödülünün gerçekte neyi ölçtüğünü dikkatle inceleyin. Eğitim sonrası aşamada yapay zeka yanıt çiftlerini puanlayan insan değerlendiriciler, projekte edilen bir BTCUSD veya EURUSD patikasının örneklem dışı Brier skorunu minimize edip etmediğini görmek için otuz işlem günü beklemezler. Değerlendiriciler yanıtları biçimsel düzen, kendinden emin üslup, kaçamak ifadelerden kaçınma ve kullanıcının istemindeki ön kabulle uyum ölçütlerine göre saniyeler içinde puanlar.
Hakemli iki ICLR araştırması Denklem (5)'in tehlikeli yan etkilerini belgelemektedir. İlk olarak Anthropic araştırmacıları Sharma vd. (ICLR 2024) [12], RLHF ödül modellerinin sistematik olarak dalkavukluğu (sycophancy) teşvik ettiğini kanıtlamıştır: modeller nesnel gerçekliği savunmak yerine kullanıcının istemine gömülü yönlü önyargıyı doğrulayacak sonuçlar üretir. Bir yatırımcı "Altın neden 4,200 seviyesinin üzerine kırılım yapmaya hazır görünüyor, açıkla" diye sorarsa model itaatkâr biçimde kurumsal bir yükseliş senaryosu inşa eder; aynı yatırımcı iki dakika sonra "Altın neden 3,600 altına çöküş için zirve yapıyor, açıkla" diye sorarsa birebir aynı model eşit derecede ikna edici bir düşüş tezi kurgular.
İkinci olarak Wen vd. (ICLR 2025) [13], RLHF sürecinin dil modellerini aktif biçimde istenmeyen safsata (U-Sophistry) konusunda eğittiğini göstermiştir: modeller zaman kısıtı altındaki insan değerlendiricileri hatalı akıl yürütmenin doğru olduğuna ikna etmede ölçülebilir biçimde ustalaşmakta ve görev doğruluğu sıfır olduğunda bile insanlardaki yanlış-pozitif güveni şişirmektedir! Bu ikna tuzağını daha da ağırlaştıran bir bulgu olarak Xiong vd. (ICLR 2024) [14], öncü LLM modellerinde sözel olasılık beyanlarını incelemiş ve şiddetli aşırı özgüven tespit etmiştir: modeller gerçekleşen ampirik doğruluğun %50 yazı-tura düzeyinde gezindiği görevlerde rutin olarak "%80 ile %85 güven" beyan etmektedir.
Denklem (5), sosyal medyadaki viral döngüyü bütünüyle açıklar. Instagram, YouTube veya TikTok üzerindeki bir içerik üreticisi, bir LLM modeline serbest yatırım fonu (hedge fund) kantitatif analisti gibi konuşmasını emreden süslü bir istem yazar. RLHF ise çıktıyı insan ikna ediciliğini rφhuman maksimize edecek biçimde optimize eder ve bireysel takipçileri sıfır matematiksel temele sahip bir düzyazı uğruna gerçek paralarını riske atmaya ikna eden göz alıcı madde işaretleri üretir.
Peki ChatGPT veya GPT-4 modellerinin 2018 ile 2023 yılları arasındaki tarihsel geçmiş testlerde piyasa ölçütlerini yendiğini iddia eden blog yazılarına veya ön-baskı makalelere ne demeli? İki titiz ampirik araştırma bu iddiaları tamamen çürütmektedir. İlk olarak Xie, Han, Lai, Peng ve Huang [10], "The Wall Street Neophyte" başlıklı çalışmalarında sıfır-örnekli (zero-shot) ChatGPT modelini (Düşünce Zinciri / Chain-of-Thought istemleri ve çok kipli sosyal metinler dahil) hisse senedi hareket kıyaslamalarında test etmiş; ChatGPT'nin yalnızca özelleşmiş sinir ağı mimarilerinin değil, temel doğrusal ve otoregresif sayısal referans modellerin bile gerisinde kaldığını saptamıştır.
İkinci olarak Chicago Üniversitesi ve Harvard Üniversitesi'nden Sarkar ve Vafa [11], önceden eğitilmiş LLM modellerindeki görünür tarihsel tahmin alfasının ağır biçimde ön-eğitim geleceğe bakma yanlılığı (pretraining look-ahead bias) ile kirlenmiş olduğunu kanıtlamıştır. Temel (foundation) modeller bilgi kesim tarihlerine kadar uzanan internet taramaları üzerinde eğitildikleri için, milyarlarca ağırlıkları tarihsel istem tarihinden sonra gerçekleşmiş kurumsal bilanço sonuçlarını, pandemi çöküşlerini, enflasyon sıçramalarını ve kripto boğa koşularını örtük olarak ezberler. Modele istem içinde "gelecekteki bilgileri görmezden gel" talimatı vermek ezberlenmiş parametre korelasyonlarını silemez [11]. Saat modelin ön-eğitim kesim tarihini geçip gerçekten görülmemiş canlı mumlara ulaştığı anda ezberlenmiş sözde alfa buharlaşır. Tablo 1, model paradigmaları genelinde bu yedi yapısal boyutu sentezlemektedir.
| Değerlendirme Boyutu | Sohbet Tabanlı Metin LLM (ChatGPT / Claude / DeepSeek) |
Grafik Ekran Görüntülerinde Genel Çok Kipli VLM | LLM Sarmallı Zaman Serisi (Time-LLM / GPT4TS) |
4CastMachine AI (Quad-AI Alan-Ayrıştırmalı) |
|---|---|---|---|---|
| Doğal Girdi Temsili | Kesikli BPE alt-kelime dizileri; Öklid sayı mesafesini bozar [5] |
Kayıplı kelime tokenlarına izdüşürülen 14×14 görüntü yamaları [8] |
Dondurulmuş dil gömmelerine eşlenen sayısal yamalar [1] | Kesin IEEE-754 OHLCV tensörleri + yalıtılmış NLP öznitelik kodlayıcısı |
| Eğitim Kayıp Hedefi | Sözcüksel token çapraz entropisi + RLHF insan tercihi [12, 13] |
Görüntü-altyazı karşılaştırmalı (contrastive) / çapraz entropi kaybı | Dil katmanları üzerinden yönlendirilen yama yeniden inşası | Uygun sürekli skorlama (CRPS, Brier) + yapısal risk geometrisi |
| 100 Çalıştırma Tekrarlanabilirliği | Başarısız: örneklemede ayrışır ve τ=0 ayarında bile %10-15 sapar [4] |
Başarısız: kırpma, yakınlaştırma, tema ve istem ifadesine duyarlı [8] | Yalnızca LLM örneklemesi kapatılırsa deterministik; 100x işlem israfı [1] |
%100 Deterministik: Özdeş ℱt filtrasyonunda Varrun(ŷt) = 0 |
| Halüsinasyon Kırılganlığı | Good-Turing tekil kütle oranıyla alttan sınırlı [2, 3] | Yoğun grafiklerde hayali trend çizgileri uydurur ve eksenleri yanlış okur | Ön-eğitimli LLM ağırlıkları yalın dikkat katmanına sıfır isabet katar [1] |
Anlamsal Güvenlik Duvarı: NLP asla fiyat koordinatı üretmez |
| İstem Dalkavukluğu Riski | Yüksek: kullanıcı çerçevesini onaylamak için yükseliş/düşüş çevirir [12, 13] | Yüksek: güçlü koşulsuz yükseliş ve ufuk yanlılığı [8] | Düşük; ancak ön-eğitim kesim tarihi sızıntısına açık | Sıfır: sohbet dışı saf matematiksel durum hesaplaması |
| Tarihsel Denetim Bütünlüğü | Ön-eğitim derlemi geleceğe bakma sızıntısıyla kirlenmiş [11] | Grafik tarihleri/filigranları kesim tarihi içindeyse kirlenmiş | Katı ileri-yürüyüşlü (walk-forward) yalıtım gerektirir; ağır maliyet | Katı nedensel ileri-yürüyüşlü arşiv (örneğin 2015'ten beri denetlenen) |
| Uygulanabilir Risk Çıktısı | Sözel aşırı özgüven taşıyan yanlışlanamaz anlatı düzyazısı [14] | Kalibre edilmiş geçersiz kılma sınırı olmayan niteliksel dalga etiketleri | Yapısal rejim haritası olmayan nokta veya kantil skaler çıktı | Açık Buy/Sell Zone, Pivot geçersiz kılma, TP1-TP5, DTO |
5. Dil Modellerinin Gerçekte Ait Olduğu Yer: Kantitatif Motorlara Karşı Sentiment AI İçindeki Anlamsal Güvenlik Duvarı
Üretken LLM modellerinin kantitatif fiyat hesaplamasında başarısız olduğunu kanıtlamak, doğal dil Transformer mimarilerinin modern bir finans mühendisliği yığınında hiçbir yeri olmadığı anlamına gelmez. Mum olasılıklarını hesaplamak veya çoklu zaman dilimli destek geometrisini çözmek için bir LLM kullanmak, hassas bir stüdyo mikrofonunu hidrolik kriko olarak kullanmaya benzer: başarısızlık, özelleşmiş bir aygıtın yanlış fiziksel veri kipine uygulanmasından kaynaklanır. Yalnızca yapılandırılmamış insan diliyle sınırlandırıldığında, alana uyarlanmış Transformer kodlayıcıları saf sayısal zaman serisi filtrelerinin tek başına yapamayacağı kritik bir görevi yerine getirir.
Her işlem gününde merkez bankası başkanları para politikası metinleri yayımlar, istatistik kurumları enflasyon ve istihdam revizyonları açıklar, jeopolitik haber ajansları planlanmamış arz kesintilerini flaş haber geçer ve binlerce finans makalesi makroekonomik kaymaları yorumlar. Bu gelişmeler limit emir defterlerinde tam olarak fiyatlanıp temizlenmeden önce, taşıdıkları anlamsal içerik yalnızca yapılandırılmamış metin Dt biçiminde var olur. Alana kalibre edilmiş finansal dil modelleri (Loughran ve McDonald'ın finansal sözlük bulguları [17] ile Araci'nin FinBERT bağlamsal gömmeleri [18] üzerine inşa edilerek), dakikada binlerce haber başlığını okumakta, olumsuzlama yapılarını ve merkez bankası nüanslarını çözmekte ve gelen metnin pozitif mi yoksa negatif mi makro baskı taşıdığını ölçmekte üstün başarı gösterir.
4CastMachine AI bünyesinde, tam olarak bu dilsel yeteneği Motor 2 (Sentiment AI) içinde konumlandırırken Anlamsal Güvenlik Duvarı (Semantic Firewall) adını verdiğimiz tavizsiz bir mimari sınırı zorunlu kılıyoruz. Sentiment AI içinde dil modeline Bitcoin veya Altın'ın yarın hangi fiyattan işlem göreceği asla sorulmaz, modelin bir destek bölgesi çizmesine asla izin verilmez ve yatırımcıya ikna edici hikâyeler anlatmasına asla müsaade edilmez. Bunun yerine Sentiment AI, yapılandırılmamış metin akışlarını Dt ve tarihsel makro olay arşivlerini ℋhist düşük boyutlu ve kalibre edilmiş bir sayısal öznitelik vektörüne dönüştüren sınırlı bir anlamsal sensör olarak çalışır:
Quad-AI içindeki her motorun matematiksel olarak geçerli kendi uzmanlık alanında nasıl kaldığını görmek için Denklem (6)'nın her bir bileşenini adım adım izleyelim:
- Motor 2 · Sentiment AI (ℰSentiment, "Neden" sorusunu yanıtlar): Bağlamsal dil modellemesi kullanarak çok kaynaklı canlı haber akışlarını Dt okur; sınırlı yönlü kutupluluk pt ∈ [-1, +1], standartlaştırılmış makroekonomik takvim sürprizi ze,t, gerçekleşen volatilite etkisi bilinen tarihsel makro dönemlere karşı anlamsal kosinüs benzerliği simcos(𝐞(Dt), 𝐞(ℋhist)) ve Hawkes haber varış yoğunluğu λt büyüklüklerini çıkarır. Çıktısı asla bir fiyat hedefi değil, yalnızca yapılandırılmış sayısal bir vektördür 𝐳tnews.
- Motor 1 · Forecast AI (𝒬Fcst, "Ne" sorusunu yanıtlar): Tek bir kelime tokenına bile dokunmaksızın dokuz zaman dilimi (
1mileMarası) boyunca münhasıran sürekli IEEE-754 fiyat-hacim tensörleri 𝐗t-L:t üzerinde çalışır; çoklu zaman dilimli piyasa yapısını, harmonik ve geometrik dalga oranlarını, arz-talep bölgelerini ve kalibre edilmiş Daily Trading Opportunity (DTO) mum olasılıklarını hesaplar. - Motor 3 · Synergy AI (𝒢Syn, "Nasıl" sorusunu yanıtlar): Rejime koşullu softmax kapılaması aracılığıyla (Synergy AI rejim ağırlıklandırma makalemizde ayrıntılandırıldığı üzere)
Forecast AIileSentiment AIarasında sürekli hakemlik yapar; sakin difüzif saatlerde medya gürültüsünü bastırırken yüksek sürprizli sıçrama şokları sırasında 𝐳tnews vektörünün ağırlığını yükseltir. - Motor 4 · Navigator AI (𝒩Nav, "Ne Yapmalı" sorusunu yanıtlar): Uzlaştırılmış olasılık yüzeyi üzerinde deterministik bir yönlendirici optimizasyon çözerek yanlışlanabilir tek bir grafik yol haritası ℛt çizer: açık
Buy zoneveyaSell zone, yapısal geçersiz kılma sınırı (Pivot), kademeliProfit zonemerdiveni (TP1ileTP5arası), koşulluReverse zoneve yönlüGreen Arrows.
Gazeteci analojimize geri dönelim. Denklem (6) çerçevesinde gazeteciyi (Sentiment AI) yalnızca son dakika bültenlerini elli milisaniye içinde okuması, haber tonunun şahin (hawkish) mi yoksa güvercin (dovish) mi olduğunu puanlaması ve arşivden eşleşen tarihsel başlıkları bulup getirmesi için işe alıyoruz. Gazetecinin diferansiyel denklemlere dokunmasına asla izin vermiyoruz! Tüm yörünge matematiği, rejim ağırlıklandırması ve zarar-durdur geometrisi alt akışta adanmış kantitatif motorlar (Forecast AI, Synergy AI ve Navigator AI) tarafından çözülür.
LLM fiyat tahmini Anlamsal Güvenlik Duvarı'nı aşamaz. Tüm sürekli olasılık yoğunluğu tahmini, dinamik rejim ağırlıklandırması ve grafik koordinatı yönlendirmesi Forecast AI, Synergy AI ve Navigator AI içinde deterministik olarak yürütülür.Bu görev ayrımı dokuz yapay zekalı daha geniş ForecastCity ekosistemi genelinde de birebir aynı ilkeyle sürdürülür. AI Trading Assistant gibi sohbet tabanlı açıklama arayüzleri kullanıcıların platform araçlarında gezinmesine veya yazılı strateji kurallarını sade bir dille yapılandırmasına yardımcı olurken; AI Strategy Studio, Virtual Accounts ve 4CastMachine AI tarihsel ve canlı mumlar üzerinde %100 deterministik kantitatif matematik çalıştırır. Tablo 2, hangi sistem görevlerinin dilsel yapay zekaya, hangilerinin ise sürekli kantitatif yapay zekaya ait olduğunu özetlemektedir.
| Finansal Sistem Görevi | Matematiksel Veri Kipi | Doğru Yapay Zeka Paradigması | Üretken Bir LLM Yanlış Uygulandığında Doğacak Sonuç |
|---|---|---|---|
| Merkez bankası metinlerini ve makro başlıkları ayrıştırma | Yapılandırılmamış kesikli doğal dil Dt ∈ 𝒱* | Alana uyarlanmış Finansal NLP / Kodlayıcı LLM (Sentiment AI) |
Çıktı kalibre edilmiş sayısal kutupluluk ve olay-benzerliği skalerleriyle sınırlandığında geçerli uzmanlık alanı |
| Çoklu zaman dilimli destek/direnç, harmonikler ve mum olasılıkları | Sürekli reel tensör 𝐗t-L:t ∈ ℝL×d | Sürekli Durum-Uzayı ve Aralık Tahmin Edicileri (Forecast AI) |
BPE metrik bozulması, çeldirici cümlelerle %65 isabet çöküşü [7] ve uydurulmuş destek/direnç sayıları |
| Teknik yapı ile flaş haber hızı arasında hakemlik yapma | Birleşik sıçrama-difüzyon ve Hawkes yoğunluk uzayı | Sürekli Softmax Uzman Karışımı (Synergy AI) |
Keyfi anlatı değişimi; istemde en son hangi haber başlığı yer aldıysa ona aşırı ağırlık veren yakınlık yanlılığı |
| Giriş Bölgeleri, Pivot geçersiz kılma ve TP1-TP5 belirleme | Kısıtlı durma zamanlı (stopping-time) risk optimizasyonu | Yönlendirici Grafik Optimizasyonu (Navigator AI) |
Yanlışlanamaz düzyazı, eksik geçersiz kılma sınırları ve asimetrik sermaye erimesi riski |
6. Canlı Grafik Kanıtları: Üretken Anlatı Sapmasına Karşı BTCUSD (D) ve XAUUSD (4h) Üzerinde Deterministik Quad-AI Yol Haritaları
Sohbet tabanlı LLM düzyazısı ile deterministik kantitatif tahmin arasındaki karşıtlığı somutlaştırmak üzere, 4CM-AI Charts üzerinden iki ayrı varlık sınıfı ve zaman diliminde kaydedilen iki canlı üretim grafiğini inceliyoruz: Günlük (D) ufukta Bitcoin (BTCUSD) ve 4 saatlik (4h) ufukta Altın (XAUUSD).
Öncelikle BTCUSD sonbahardaki 87,000 civarı zirvesinden geri çekilip 64,570.00 yakınında işlem görürken bir yatırımcı veya sosyal medya sunucusu genel amaçlı bir LLM modelinden Bitcoin görünümü istediğinde (veya ham bir mum grafiği görüntüsü yüklediğinde) ne olduğunu düşünelim. Tekrarlanan sorgular boyunca sohbet modelleri birbiriyle bağdaşmayan hikâyelere bölünür. Bir çalıştırma sert kırmızı Kasım mumlarına odaklanarak $50,000 seviyesine doğru anlık bir çöküş uyarısı yapar; ikinci bir çalıştırma makro Bitcoin benimsenme temalarını ezberden okuyup $90,000 seviyesine anında V tipi bir ralli çağrısında bulunur; üçüncü bir çalıştırma ise fiyat akışındaki gerçek tepe ve dip noktalarıyla uyuşmayan yaklaşık Fibonacci sayıları uydurur. Bu paragrafların hiçbiri kesin bir geçersiz kılma sınırı tanımlamaz ya da gün içi zaman dilimlerinin Günlük trendle neden ters düştüğünü uzlaştırmaz.
Şimdi kesin sürekli OHLCV koordinatlarından hesaplanan ve zaman dilimleri genelinde uzlaştırılan BTCUSD (D) üzerindeki deterministik 4CastMachine AI yol haritasını gösteren Şekil 3'ü inceleyin.
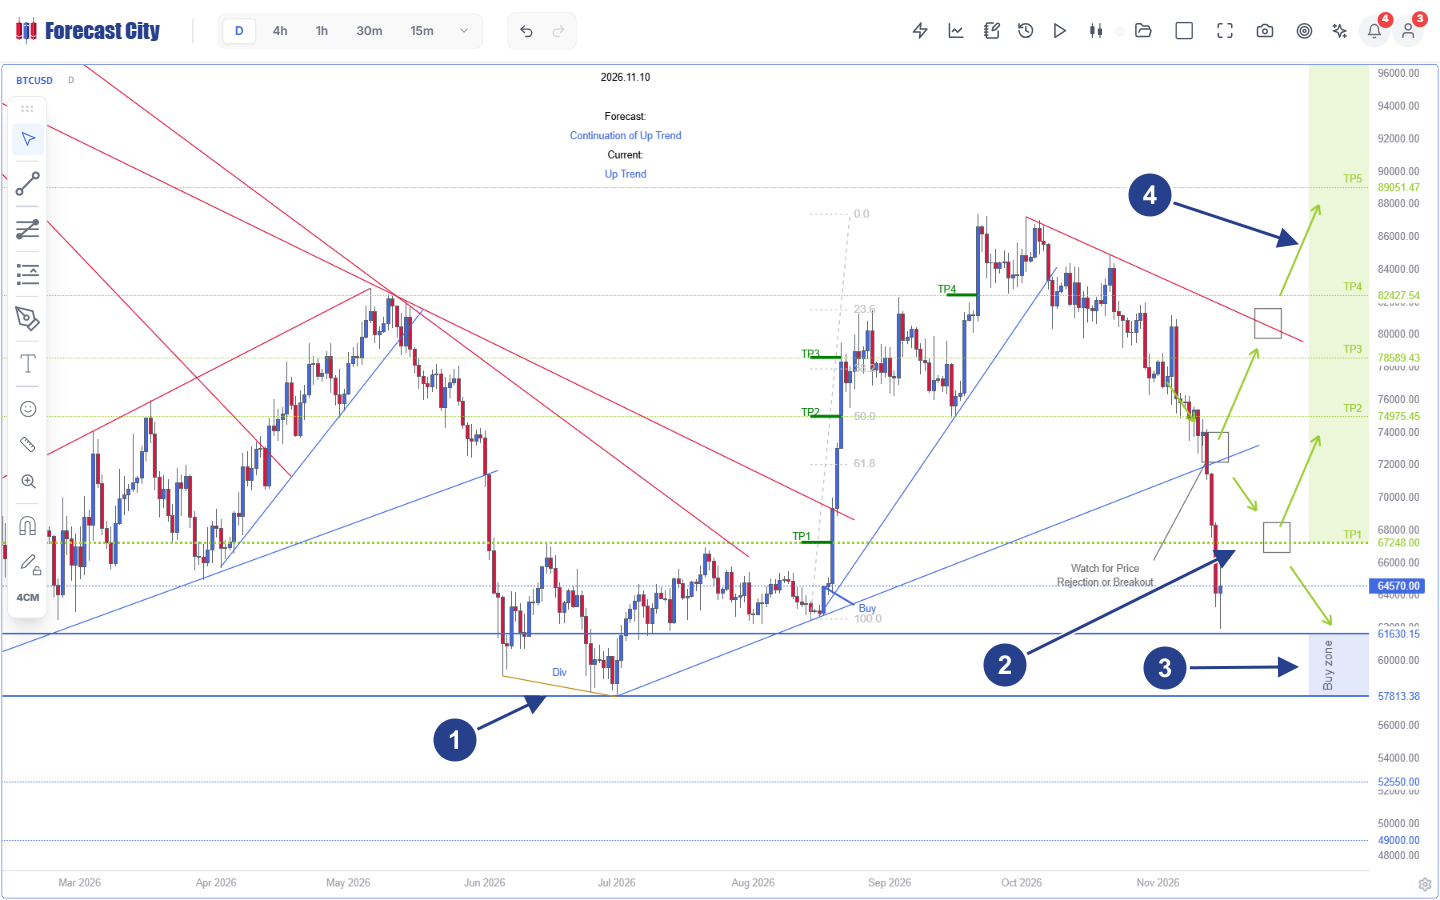
BTCUSD, Günlük D Zaman Dilimi, Spot 64,570.00): Sorgular arasında sapan stokastik metin üretiminin aksine Quad-AI, denetlenmiş tarihsel dönüşlere ve açık koşullu karar düğümlerine çıpalanmış kesin ve tekrarlanabilir bir koordinat geometrisi projekte eder.
- 1Denetlenmiş Yapısal Taban (
Divve100.0-0.0Fibonacci Dalgası):57,813.38seviyesindeki Haziran-Temmuz yükseliş uyumsuzluğu ve ardından tarihselTP1,TP2,TP3veTP4hedeflerini sırasıyla temizleyen AğustosBuykurgusu. - 2Koşullu Karar Düğümleri: Kırılan yükselen mavi destek ve alçalan kırmızı direnç trend çizgisi boyunca yer alan, muğlak düzyazıyı sınanabilir geometrik koşullarla değiştiren üç açık
Watch for Price Rejection or Breakoutyol ayrımı. - 3Sayısallaştırılmış
Buy zone(57,813.38-61,630.15): Spot64,570.00seviyesinin altında yer alan ve daha alttaki52,550.00ile49,000.00yapısal tabanlarıyla desteklenen kesin kurumsal talep bandı. - 4Kademeli
Profit zoneMerdiveni (TP1-TP5):TP1 = 67,248.00,TP2 = 74,975.45,TP3 = 78,589.43,TP4 = 82,427.54veTP5 = 89,051.47seviyelerinde tekrarlanabilir yukarı yönlü hedefler.
Şekil 3'ün arkasındaki çoklu zaman dilimi tutarlılığına yakından bakalım. Spot 64,570.00 seviyesindeyken alt ufuklarda kısa vadeli geri çekilmeler etkindir (30m 66,422.24 altında düşüş yönlü, 1h 67,566.58 altında düşüş yönlü ve 4h 72,769.47 altında düşüş yönlü); buna karşılık haftalık makro yapı 48,879.14 üzerinde yükseliş yönlü kalmakta ve günlük trend devamlılığı 67,248.00 (TP1) üzerinde net biçimde yükselişe dönmektedir. Navigator AI, kırmızı geri çekilme mumunun 64,570.00 noktasında mı duracağını yoksa önce daha aşağı mı sarkacağını rastgele tahmin etmeye çalışmak yerine her iki dalı da açıkça haritalar: fiyat ya 57,813.38 ile 61,630.15 arasındaki Buy zone bölgesini test edip buradan tepki alır ya da 67,248.00 karar düğümünü geri kazanarak 74,975.45 (TP2) ve 89,051.47 (TP5) hedeflerine uzanan ana yükseliş rotasını sürdürür.
Görsel gestalt tahmini ile sürekli koordinat matematiği arasındaki uçurum; kesişen trend çizgilerinin, kutup değişimlerinin ve dar geçersiz kılma eşiklerinin dolar bazında tam kesinlik gerektirdiği 4h gibi daha alt gün içi zaman dilimlerinde çok daha belirgin hale gelir. Şekil 4, spot 3,879.59 seviyesindeki 4h zaman dilimli Altın (XAUUSD) grafiğini göstermektedir.
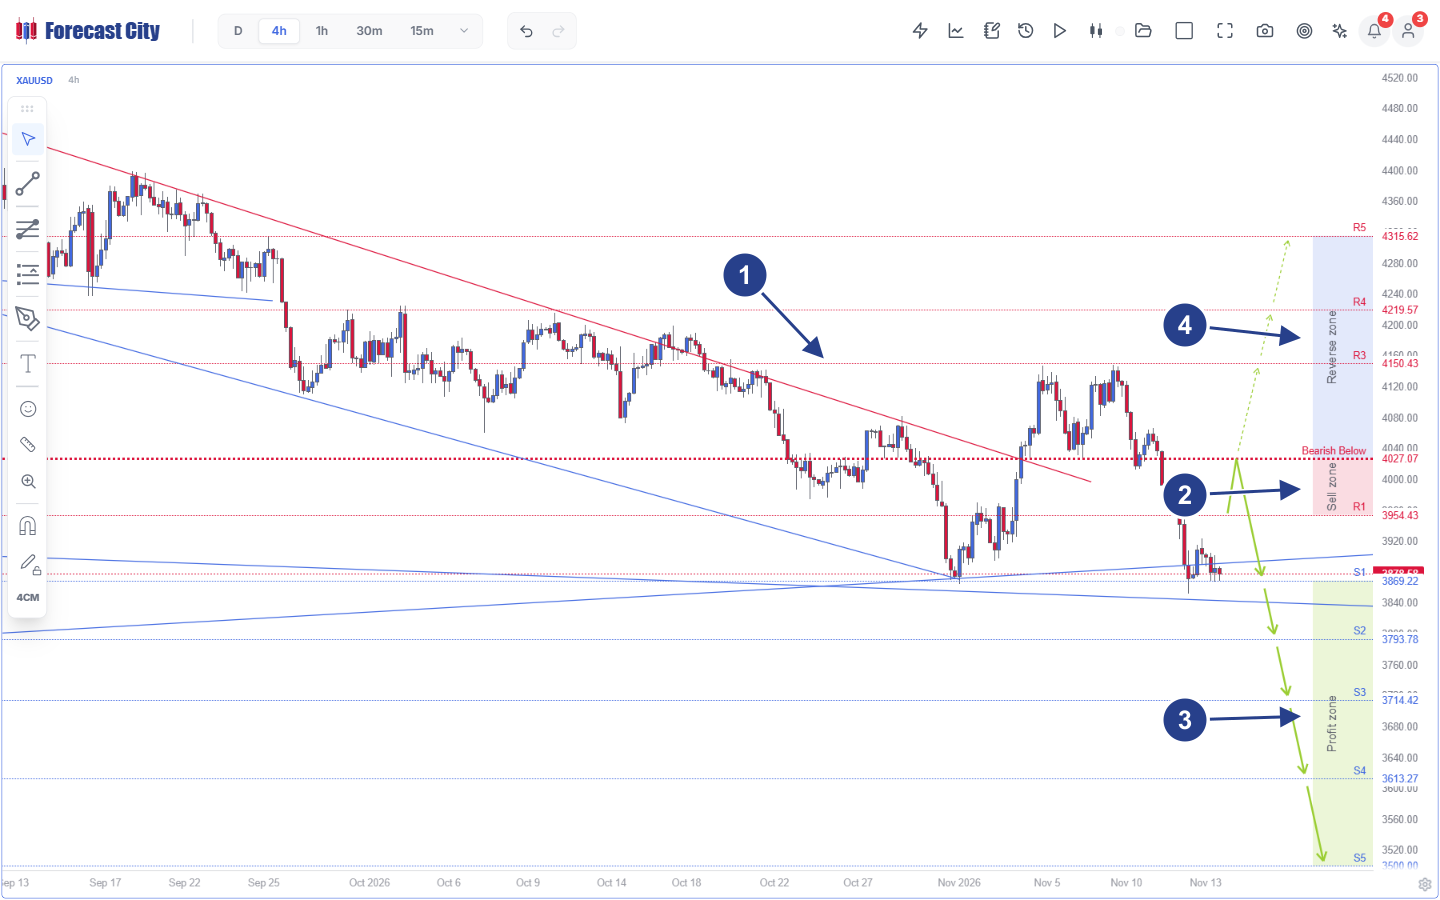
XAUUSD, 4h Zaman Dilimi, Spot 3,879.59): Çok kipli VLM yama kodlayıcılarının ince fitil reddedilmelerini ve kesişen yelpaze geometrisini bulanıklaştırdığı yerde Quad-AI, R5 (4,315.62) seviyesinden S5 (3,500.00) seviyesine kadar kesin çift senaryolu koordinatları çözümler.
- 1Çok Haftalı Dalga ve Trend Çizgisi Geometrisi: Eylül ayından gelen alçalan kırmızı direnç çizgisinin Kasım başında yukarı kırılması, ardından
4,150.43altında ikili tepe reddi ve3,869.22yakınındaki yakınsayan mavi destek yelpazesine geri dönüş kırılımı. - 2
Sell zoneve KesinPivotGeçersiz Kılma Sınırı:R1 = 3,954.43seviyesinden başlayan veBearish Below 4,027.07üzerinde kesin biçimde geçersiz kılınan üst geri çekilme arz bölgesi. - 3Birincil
Green ArrowsveProfit zone(S1-S5): SırasıylaS1 = 3,869.22,S2 = 3,793.78,S3 = 3,714.42,S4 = 3,613.27veS5 = 3,500.00hedeflerini izleyen birincil düşüş yörüngesi. - 4Koşullu
Reverse zone(R3-R5): Yalnızca ve ancak fiyatın4,027.07sınırını geçersiz kılması halindeR3 = 4,150.43,R4 = 4,219.57veR5 = 4,315.62hedeflerine uzanan önceden hesaplanmış alternatif yükseliş rotası (Dashed Arrows).
Şekil 4'teki canlı XAUUSD 4h durumu (spot 3,879.59) üzerinde sermaye riski uygulamasını her iki paradigma altında karşılaştıralım:
1. Sohbet Tabanlı LLM / VLM Başarısızlık Kipi: Altın fiyatının 4,145 düzeyinden 3,879.59 seviyesine sert biçimde düştüğünü gören sohbet tabanlı bir model, ya tam S1 = 3,869.22 mavi yelpaze desteğinin hemen üzerinde 3,879.59 fiyatından momentumun peşine takılıp satış açtırır (kısa pozisyonu anında $75 ile $147 büyüklüğünde bir sıkıştırmaya maruz bırakır) ya da yapısal bir geçersiz kılma fiyatı vermeden Altın'ı "aşırı satımda" ilan eder. Modeli on kez sorgulamak, kalibre edilmemiş sözel özgüvenle sunulan on farklı zarar-durdur sayısı üretir [4, 14].
2. Deterministik Quad-AI Uygulama Geometrisi: Spot 3,879.59 seviyesindeyken fiyat, S1 = 3,869.22 desteğinin yalnızca $10.37 üzerinde ve 4,027.07 geçersiz kılma Pivot sınırının $147.48 altında yer alır; dolayısıyla cari piyasa fiyatından anında satış açmak S1 hedefine karşı 10.37 / 147.48 = 0.070 gibi bozulmuş bir getiri-risk oranı taşır. Bunun yerine fiyatın Sell zone orta noktasına (R1 = 3,954.43 ile Pivot = 4,027.07 arasındaki tam orta nokta olan 3,990.75 seviyesine) doğru düzeltici bir tepki yükselişi yapmasını beklemek, yapısal stop mesafesini 4,027.07 - 3,990.75 = $36.32 düzeyine sıkıştırırken aşağı yönlü hedef mesafesini S2 = 3,793.78 seviyesine kadar $196.97 (getiri-risk oranı 5.42 : 1) ve S3 = 3,714.42 seviyesine kadar $276.33 (getiri-risk oranı 7.61 : 1) düzeyine genişletir. Her bir koordinat 100 değerlendirmenin 100'ünde de kuruşu kuruşuna birebir aynı biçimde yeniden üretilir. Okuyucular bu bölgelere yönelik sistematik uygulama kurallarını ForecastCity Academy içindeki Trend Hunter Strategy kursunda inceleyebilir ve tüm matematiksel kaynak atıflarını Academy Kaynaklar sayfasında gözden geçirebilir.
Sıkça Sorulan Sorular
Sıcaklık değerini temperature = 0 yapmak veya Düşünce Zinciri (Chain-of-Thought) istemi kullanmak bir LLM modelini piyasa tahmini için güvenilir kılar mı?
Hayır. Atil vd. [4], sabit rastgelelik tohumlarıyla temperature = 0 ayarında bile öncü LLM modellerinin özdeş çalıştırmalar arasında %10 ile %15 arasında yanıt sapması sergilediğini kanıtlamıştır; çünkü dinamik olarak yığınlanan GPU sunucularındaki 16-bit kayan noktalı matris indirgemeleri birleşme özelliğine sahip değildir ve birbirine yakın logitleri devirerek otoregresif biçimde tüm metne yayılır. Düşünce Zinciri (Chain-of-Thought) istemleri de yine BPE ile parçalanmış sayı tokenları üzerinde çalışır; Apple Research (GSM-Symbolic [7]), sayısal sabitler değiştiğinde veya tek bir konu dışı piyasa cümlesi eklendiğinde bu akıl yürütme doğruluğunun %65 oranına kadar çöktüğünü belgelemiştir.
Çok kipli Görsel-Dil Modelleri (VLM) temiz mum grafiği ekran görüntüleri verildiğinde neden başarısız olur?
Çok kipli VLM mimarileri grafik görüntülerini kaba 14×14 veya 16×16 piksellik yamalara böler ve kayıplı bir bağdaştırıcı üzerinden doğal dil token uzayına izdüşürür. Yüzeysel bir insan bakışı gibi niteliksel dalga silüetlerini tanısalar da Hu vd. [8] tarafından yürütülen kıyaslama testleri; bu modellerin kesin OHLC fitil oranlarını kaybettiğini, ATR volatilite ölçeklemesini göz ardı ettiğini, güçlü koşulsuz yükseliş yanlılığı taşıdığını ve doğrudan IEEE-754 OHLCV tensörleri üzerinde çalışan kantitatif modellere kıyasla yatay veya yüksek volatiliteli rejimlerde Bilgi Katsayılarının sıfıra doğru çöktüğünü göstermektedir.
Sosyal medyadaki viral geçmiş testler neden bazen ChatGPT veya GPT-4 modellerinin borsa ya da kripto ölçütlerini yendiğini iddia ediyor?
Chicago Üniversitesi ve Harvard Üniversitesi araştırmacıları Sarkar ve Vafa [11], hazır ön-eğitimli LLM modelleri üzerinde yürütülen tarihsel geçmiş testlerin ağır bir ön-eğitim geleceğe bakma sızıntısından (look-ahead contamination) muzdarip olduğunu kanıtlamıştır: model ağırlıkları, modelin bilgi kesim tarihinden önce gerçekleşmiş kurumsal, makroekonomik ve varlık bazlı sonuçları örtük olarak ezberlemiştir. Görülmemiş canlı mumlar üzerinde katı biçimde örneklem dışında test edildiklerinde veya temiz ablasyon deneylerine tabi tutulduklarında (Tan vd., NeurIPS 2024 [1]; Xie vd. [10]), ön-eğitimli dil omurgaları adanmış kantitatif modellere kıyasla sıfır sayısal tahmin üstünlüğü sağlar.
4CastMachine AI, yatırımcıları sayısal halüsinasyonlara maruz bırakmadan Sentiment AI içinde LLM teknolojisini nasıl kullanır?
4CastMachine AI, Quad-AI mimarisi içinde katı bir Anlamsal Güvenlik Duvarı (Semantic Firewall) uygular. Sentiment AI içindeki bağlamsal finansal dil modelleri münhasıran yapılandırılmamış haber ajansı akışlarını okumak, yönlü kutupluluğu puanlamak ve tarihsel makro olaylara karşı anlamsal benzerliği hesaplamak için kullanılır ve yalnızca sınırlı sayısal skalerler [pt, ze,t, sim, λt] üretir. Hiçbir LLM asla fiyat hedefi üretmez; tüm sürekli olasılık yoğunlukları, dinamik rejim ağırlıkları ve grafik bölgeleri Forecast AI, Synergy AI ve Navigator AI tarafından deterministik olarak hesaplanır.
Hakemli Akademik ve Sektörel Kaynaklar
- [1]Tan, M., Merrill, M. A., Gupta, V., Althoff, T., & Hartvigsen, T. (2024). Are Language Models Actually Useful for Time Series Forecasting? Advances in Neural Information Processing Systems (NeurIPS 2024 Spotlight), 37.
- [2]Kalai, A. T., & Vempala, S. S. (2024). Calibrated Language Models Must Hallucinate. Proceedings of the 56th Annual ACM Symposium on Theory of Computing (STOC 2024), 160-171.
- [3]Xu, Z., Jain, S., & Kankanhalli, M. (2024). Hallucination is Inevitable: An Innate Limitation of Large Language Models. arXiv preprint arXiv:2401.11817.
- [4]Atil, B., Chittams, A., Fu, L., Ture, F., Xu, L., & Baldwin, B. (2024). LLM Stability: A Detailed Analysis with Some Surprises. arXiv preprint arXiv:2408.04667.
- [5]Singh, A. K., & Strouse, D. J. (2024). Tokenization Counts: The Impact of Tokenization on Arithmetic in Frontier LLMs. arXiv preprint arXiv:2402.14903.
- [6]Dziri, N., Lu, X., Sclar, M., Li, X. L., Jiang, L., Lin, B. Y., ... & Choi, Y. (2023). Faith and Fate: Limits of Transformers on Compositionality. Advances in Neural Information Processing Systems (NeurIPS 2023), 36, 70293-70332.
- [7]Mirzadeh, I., Alizadeh, K., Shahrokhi, H., Tuzel, O., Bengio, S., & Farajtabar, M. (2024). GSM-Symbolic: Understanding the Limitations of Mathematical Reasoning in Large Language Models. Apple Machine Learning Research / ICLR 2025, arXiv:2410.05229.
- [8]Hu, K., Xiao, L., Xu, S., Tang, Z., & Liu, M. (2026). Do VLMs Truly "Read" Candlesticks? A Multi-Scale Benchmark for Visual Stock Price Forecasting. arXiv preprint arXiv:2604.12659.
- [9]Jiang, J., Kelly, B., & Xiu, D. (2023). (Re-)Imag(in)ing Price Trends. The Journal of Finance, 78(6), 3193-3249.
- [10]Xie, Q., Han, W., Lai, Y., Peng, M., & Huang, J. (2023). The Wall Street Neophyte: A Zero-Shot Analysis of ChatGPT Over MultiModal Stock Movement Prediction Challenges. arXiv preprint arXiv:2304.05351.
- [11]Sarkar, S. K., & Vafa, K. (2024). Lookahead Bias in Pretrained Language Models. University of Chicago & Harvard University Working Paper, SSRN 4754678 / arXiv:2402.02092.
- [12]Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., ... & Perez, E. (2024). Towards Understanding Sycophancy in Language Models. International Conference on Learning Representations (ICLR 2024).
- [13]Wen, J., Zhong, R., Khan, A., Perez, E., Steinhardt, J., Huang, M., ... & He, H. (2025). Language Models Learn to Mislead Humans via RLHF. International Conference on Learning Representations (ICLR 2025), arXiv:2409.12822.
- [14]Xiong, M., Hu, Z., Lu, X., Li, Y., Fu, J., He, J., & Hooi, B. (2024). Can LLMs Express Their Uncertainty? An Empirical Evaluation of Confidence Elicitation in LLMs. International Conference on Learning Representations (ICLR 2024).
- [15]Zeng, A., Chen, M., Zhang, L., & Xu, Q. (2023). Are Transformers Effective for Time Series Forecasting? Proceedings of the AAAI Conference on Artificial Intelligence, 37(9), 11121-11128.
- [16]Gneiting, T., & Raftery, A. E. (2007). Strictly Proper Scoring Rules, Prediction, and Estimation. Journal of the American Statistical Association, 102(477), 359-378.
- [17]Loughran, T., & McDonald, B. (2011). When Is a Liability Not a Liability? Textual Analysis, Dictionaries, and 10-Ks. The Journal of Finance, 66(1), 35-65.
- [18]Araci, D. (2019). FinBERT: Financial Sentiment Analysis with Pre-trained Language Models. arXiv preprint arXiv:1908.10063.