En los canales minoristas de YouTube, Instagram, TikTok y X, una oleada viral de creadores de contenido solicita a Grandes Modelos de Lenguaje (LLM) conversacionales y a Modelos de Visión y Lenguaje (VLM) multimodales como ChatGPT, Claude, Gemini y DeepSeek que pronostiquen las trayectorias del Bitcoin, el Oro y las divisas. Dado que los modelos lingüísticos post-entrenados producen narrativas sintácticamente pulidas y con tono institucional, el público no especializado confunde de manera rutinaria la fluidez retórica con una ventaja cuantitativa real. Apoyándose en resultados de ciencias de la computación teórica y bancos de pruebas empíricos de aprendizaje automático publicados en STOC, NeurIPS, ICLR, AAAI y The Journal of Finance, este artículo demuestra por qué los modelos generativos autorregresivos son estructuralmente ineptos para el pronóstico numérico de mercados. Formalizamos cinco mecanismos de fallo: (1) pérdida de continuidad métrica euclídea bajo la tokenización de dígitos en subpalabras, (2) proyección con pérdida desde parches espaciales hacia tokens léxicos cuando los VLM multimodales inspeccionan imágenes de velas, (3) divergencia entre ejecuciones ante consultas idénticas incluso a temperatura cero junto con cotas inferiores de Good-Turing sobre la alucinación inevitable, (4) complacencia inducida por RLHF y sofistería persuasiva agravadas por la memorización anticipatoria de preentrenamiento en backtests históricos, y (5) fracaso catastrófico de calibración bajo riesgo de capital. Por último, especificamos la frontera arquitectónica estricta dentro de 4CastMachine AI: confinar los modelos contextuales de lenguaje dentro de Sentiment AI para codificar la polaridad de noticias no estructuradas y la similitud con eventos históricos, delegando toda la geometría continua del precio, la ponderación de regímenes y las hojas de ruta sobre el gráfico a Forecast AI, Synergy AI y Navigator AI.
1. El error categorial viral y la falacia del periodista elocuente
Durante los últimos tres años, los Grandes Modelos de Lenguaje (LLM) conversacionales han alcanzado una notable fluidez en la redacción en lengua natural, la síntesis de código y el resumen documental. Esa capacidad lingüística ha desencadenado un error metodológico masivo en los medios financieros minoristas. Cada día en YouTube, Instagram, TikTok y X, creadores de contenido de gran alcance pegan tablas OHLC o suben capturas de pantalla de gráficos de velas en modelos conversacionales de propósito general y difunden los objetivos de precio generados ante millones de espectadores.
Para un observador sin formación cuantitativa, el resultado parece revestido de autoridad. En cuestión de segundos, el modelo de lenguaje enumera catalizadores macroeconómicos, cita formaciones gráficas conocidas como cuñas ascendentes o retrocesos de Fibonacci y redacta un párrafo impecable proyectando dónde cotizarán el Bitcoin (BTCUSD) o el Oro (XAUUSD) la semana siguiente. Cuando se le instruye para adoptar el tono de un estratega institucional sénior, el modelo reproduce el vocabulario institucional con absoluta seguridad gramatical.
Bajo ese barniz lingüístico subyace un error categorial fundamental en matemáticas aplicadas. Los mercados financieros son sistemas estocásticos de valores continuos, no estacionarios y de baja relación señal-ruido, gobernados por el vaciado del libro de órdenes límite, la volatilidad heterocedástica y procesos de salto de colas pesadas. Los modelos autorregresivos de lenguaje, por el contrario, son generadores de secuencias discretas entrenados para estimar qué fragmento léxico tiene mayor probabilidad de seguir a una cadena previa de fragmentos léxicos en corpus de texto humano.
Una analogía estructural concreta aclara por qué estos dos dominios matemáticos no son intercambiables. Pedirle a un LLM generativo que resuelva en vivo una trayectoria de mercado multihorizonte equivale a pedirle a un elocuente periodista de prensa escrita que resuelva un sistema acoplado de ecuaciones diferenciales estocásticas no lineales con capital real en riesgo. Un periodista hábil puede escribir un ensayo cautivador de mil palabras sobre la historia del cálculo infinitesimal, citar a matemáticos célebres y presentar la prosa con tal pulcritud que un lector profano dé por hecho que las ecuaciones han sido resueltas.
Sin embargo, la fluidez literaria no ejecuta integración numérica. Peor aún: dado que la decodificación generativa muestrea distribuciones de probabilidad aplanadas y padece tasas de alucinación que jamás se anulan, ese narrador se comporta bajo presión como un periodista ebrio que nunca admite incertidumbre. Formúlese exactamente la misma pregunta dos veces y el narrador puede invertir la dirección sin previo aviso. Formúlese exactamente la misma pregunta cien veces y varias respuestas inventarán niveles de soporte inexistentes o errarán en aritmética elemental manteniendo idéntico aplomo retórico.
Para formalizar con rigor este desajuste, comparamos el objetivo de optimización de un modelo autorregresivo de lenguaje frente al objetivo de optimización de un motor cuantitativo calibrado de pronóstico. Antes de plantear las ecuaciones, obsérvese qué premia y qué castiga cada función de pérdida durante el entrenamiento. Un modelo de lenguaje minimiza la sorpresa léxica sobre identificadores discretos de tokens, mientras que un motor cuantitativo en espacio de estados minimiza la distancia métrica y el error de calibración probabilística sobre resultados reales continuos de precio.
Sea 𝒱 un vocabulario finito de subpalabras de tamaño |𝒱| ≈ 32,000..200,000, y sea v1:K ∈ 𝒱K una secuencia textual tokenizada. Un LLM autorregresivo con parámetros θ minimiza la entropía cruzada discreta de tokens ℒLLM(θ). En contraste, sea 𝐗t-L:t ∈ ℝL×d un tensor real del estado del mercado y Pt+τ ∈ ℝ+ el precio futuro en el horizonte τ. Un motor cuantitativo con parámetros ψ emite una distribución acumulada Fψ(y | 𝐗t-L:t) que minimiza el Continuous Ranked Probability Score (CRPS, Gneiting y Raftery [16]):
En la Ecuación (1), ℒLLM(θ) evalúa un indicador categórico one-hot sobre el índice de vocabulario vk: cualquier token erróneo recibe exactamente la misma penalización de log-verosimilitud negativa con independencia de la magnitud numérica del error. En cambio, CRPS(Fψ, Pt+τ) integra el error cuadrático de probabilidad acumulada a lo largo de toda la recta real ℝ, penalizando de forma estricta tanto la distancia métrica respecto al precio realizado Pt+τ como la dispersión mal calibrada.
Supóngase que Bitcoin cotiza en 64,570 y que el valor razonable verdadero mañana es 65,000. Bajo la entropía cruzada discreta de tokens ℒLLM, emitir la cadena "64,999" (errando por solo $1) puede acarrear una pérdida de token mayor que emitir "95,000" (errando por $30,000) siempre que "95"+",000" comparta bigramas frecuentes en textos corporativos. Bajo el criterio continuo CRPS, un desvío de $30,000 recibe en esperanza matemática una penalización treinta mil veces más severa que un desvío de $1, anclando cada actualización paramétrica al riesgo financiero real.
Los bancos de pruebas empíricos confirman que entrenar sobre billones de palabras no otorga pericia alguna en el pronóstico de series temporales. En un estudio de referencia distinguido como Spotlight en NeurIPS 2024, Tan, Merrill, Gupta, Althoff y Hartvigsen [1] auditaron destacadas arquitecturas de series temporales basadas en LLM -incluyendo Time-LLM, OneFitsAll (GPT4TS) y CALF- sobre conjuntos estándar de evaluación. Los autores ejecutaron ablaciones sistemáticas en las que eliminaron por completo los pesos preentrenados del LLM o sustituyeron el modelo lingüístico troncal de miles de millones de parámetros por una única capa ligera de atención o de parcheo lineal entrenada desde cero.
El hallazgo desmanteló la premisa central del pronóstico mediante LLM. Suprimir el esqueleto del modelo de lenguaje produjo cero degradación en la exactitud de los pronósticos y con frecuencia mejoró el Error Cuadrático Medio (MSE) y el Error Absoluto Medio (MAE), reduciendo simultáneamente el número de parámetros y el costo computacional de inferencia entre dos y tres órdenes de magnitud [1]. Incluso en regímenes de pocos ejemplos (few-shot), donde sus defensores sostenían que el preentrenamiento lingüístico transfiere razonamiento secuencial, los pesos preentrenados del LLM no aportaron ganancia medible frente a codificadores numéricos diminutos. Un trabajo previo de Zeng, Chen, Zhang y Xu en AAAI [15] demostró de modo análogo que las aplicaciones lineales directas simples superan a los transformadores secuenciales complejos cuando el orden temporal y la escala quedan distorsionados por la proyección en tokens.
2. Colapso métrico por tokenización de subpalabras y por qué la visión multimodal percibe ondas de Gestalt sin medir el riesgo
Para comprender por qué escalar un LLM desde siete mil millones hasta más de un billón de parámetros jamás lo convierte en un motor cuantitativo fiable, debemos examinar qué ocurre con los números brutos del mercado en la primera capa de la red. Los algoritmos cuantitativos ingieren series de precios, volúmenes y volatilidad como escalares en coma flotante IEEE-754 de 64 bits. Los números reales constituyen un cuerpo métrico completo: la suma, la multiplicación, el orden y la distancia euclídea son operaciones primitivas exactas en hardware.
Los modelos de lenguaje no ingieren escalares en coma flotante. Antes de que un transformador observe un solo precio, un tokenizador Byte-Pair Encoding (BPE) o SentencePiece trocea la cadena de caracteres en fragmentos de subpalabras de longitud variable según la frecuencia de compresión en el corpus. Singh y Strouse [5] demostraron que los LLM de frontera dividen cifras de varios dígitos en tokens inconsistentes de 1, 2 o 3 dígitos de izquierda a derecha, chocando frontalmente con la aritmética posicional de derecha a izquierda y con la lógica de acarreo por valor posicional.
Considérese lo que la tokenización BPE provoca sobre cotizaciones reales de divisas y criptomonedas. En EURUSD, los precios 1.0849 y 1.0850 distan exactamente 0.0001 (1 pip), representando estados de mercado prácticamente idénticos. Bajo la tokenización en subpalabras, "0849" y "0850" se asignan a identificadores enteros distintos cuyos vectores iniciales de inmersión en ℝde no tienen por qué situarse más cerca entre sí que el token correspondiente a "1.9850" (a 9,000 pips de distancia). Formalizamos esta ruptura topológica mediante la razón de distorsión métrica local del operador de tokenización.
En la Ecuación (2), x, y ∈ ℝ son dos precios reales de mercado separados por un tick mínimo δ, str(·) convierte el escalar en caracteres decimales y ΦBPE(·) proyecta la secuencia resultante de subpalabras sobre el espacio agrupado de inmersiones de entrada. En un modelo cuantitativo suave, κ(x, y) está acotada por una constante de Lipschitz finita de modo que variaciones minúsculas de precio inducen perturbaciones minúsculas de estado. Bajo el troceado de cadenas BPE, κtok(x, y) salta de forma errática en las fronteras de acarreo de dígitos -como de 69,999.99 a 70,000.00- mientras colapsa artificialmente cada vez que precios muy lejanos comparten subcadenas finales.
La Ecuación (2) explica por qué los LLM fallan en cálculos elementales de riesgo sobre gráficos en vivo. Para un tokenizador de subpalabras, 67,248 y 57,248 lucen casi idénticos porque coinciden cuatro de sus cinco dígitos, aunque los separen $10,000 en Bitcoin. Entretanto, 69,999 y 70,001 no comparten ni un solo dígito pese a estar a tan solo $2 de distancia. Ningún motor cuantitativo de volatilidad o de stop-loss puede operar con fiabilidad cuando su sistema de coordenadas de entrada desordena las distancias numéricas.
Este defecto de representación se propaga en cascada hacia fallos de cálculo en múltiples pasos. Dziri et al. en NeurIPS [6] probaron que los transformadores autorregresivos abordan la aritmética multipaso y la programación dinámica mediante emparejamiento linealizado de patrones en subgrafos en lugar de aprender algoritmos generalizables, haciendo que la precisión decaiga exponencialmente conforme crece la profundidad composicional. En Apple Machine Learning Research, Mirzadeh et al. [7] introdujeron GSM-Symbolic, sustituyendo las constantes fijas de evaluación por variaciones numéricas simbólicas. El mero cambio de las cifras específicas de un problema matemático provocó oscilaciones notables de exactitud en los LLM de frontera, e insertar una sola cláusula contextual irrelevante hundió la precisión del razonamiento hasta en un 65% [7]. Los mercados financieros inyectan decenas de cláusulas macroeconómicas ruidosas e irrelevantes cada hora.
Ante los límites de la tokenización textual, los operadores en redes sociales suelen recurrir a un segundo argumento: «En lugar de teclear números, sube una captura de pantalla del gráfico de velas para que un Modelo de Visión y Lenguaje (VLM) multimodal lea las ondas visualmente igual que un chartista humano experimentado». En apariencia, la idea suena plausible. Cuando un ser humano observa un gráfico de precios, la corteza visual distingue al instante picos, valles alternos y contornos diagonales de tendencia. En efecto, los VLM multimodales imitan ese vistazo humano superficial, nombrando ondas aparentes, triángulos o siluetas de hombro-cabeza-hombro en una prosa fluida.
Sin embargo, percibir la silueta cualitativa de una onda es radicalmente distinto de calcular una esperanza matemática condicional cuantitativa. Cuando un VLM multimodal ingiere una captura de gráfico de 1440×900, un codificador Vision Transformer (ViT o SigLIP) fragmenta la imagen en parches gruesos de 14×14 o 16×16 píxeles y proyecta dichos parches visuales a través de un adaptador lineal con pérdida hacia el espacio de inmersión léxica del modelo de lenguaje. Los extremos subpíxel de las mechas, las razones exactas entre apertura y cierre del cuerpo, las no linealidades del eje vertical de precios y el escalado por el Rango Verdadero Medio de 14 periodos (ATRt(14)) quedan difuminados en tokens visuales semánticos optimizados para subtitular fotografías cotidianas, no para medir puntos básicos.
La evidencia reciente en bancos de pruebas confirma la gravedad con la que fracasan los VLM multimodales sobre gráficos de velas. Hu, Xiao, Xu, Tang y Liu [8] construyeron un banco de evaluación multiescala para el pronóstico sobre velas japonesas contrastando VLM de frontera frente a modelos base cuantitativos tabulares -como árboles potenciados por gradiente- en diversos regímenes de renta variable e índices. Su auditoría reveló cuatro rupturas estructurales: (1) los VLM exhiben un severo sesgo direccional incondicional (inclinándose por defecto hacia lecturas alcistas con independencia de la estructura), (2) su Coeficiente de Información (IC) fuera de muestra colapsa hacia cero en regímenes laterales o volátiles, (3) los VLM resultan en gran medida insensibles al horizonte de pronóstico solicitado (confundiendo ruido de 5 barras con estructura de 30 barras), y (4) los modelos base numéricos tabulares que operan directamente sobre variables brutas OHLCV superan de forma consistente a los VLM de propósito general [8].
Obsérvese el marcado contraste con la visión por computador cuantitativa diseñada específicamente para la valoración empírica de activos. Cuando Jiang, Kelly y Xiu publicaron su estudio sobre tendencias visuales de precios en The Journal of Finance [9], sus arquitecturas convolucionales triunfaron precisamente porque prescindieron por completo del lenguaje natural: matrices estandarizadas de píxeles codificaban coordenadas exactas normalizadas de máximo, mínimo y cierre junto con barras de volumen asociadas directamente a probabilidades calibradas de retorno transversal bajo una función de pérdida estadística supervisada. Proyectar un gráfico a través de un decodificador conversacional de lenguaje destruye esa precisión métrica. La Figura 1 contrasta la tubería generativa con pérdida de los LLM/VLM frente a una tubería cuantitativa en espacio de estados continuo.
14×14 antes de muestrear narrativas estocásticas cuyas respuestas derivan a lo largo de N = 100 consultas idénticas. El carril inferior (B) muestra cómo los motores cuantitativos en espacio de estados continuo preservan la geometría métrica exacta IEEE-754, la invarianza de volatilidad por ATRt(14) y una varianza nula entre ejecuciones (Varrun(ŷt) = 0).3. No determinismo entre consultas a lo largo de 100 ejecuciones y la cota inferior de alucinación de Good-Turing
Un axioma fundacional de la ingeniería institucional de riesgos es el determinismo funcional: dada una filtración fija del mercado ℱt al cierre de la vela t, un modelo matemático debe transformar ℱt en una distribución de probabilidad única y reproducible junto con fronteras únicas de riesgo. Si el calculador de control de vuelo de un avión comercial arrojara dos sendas de planeo contradictorias al recibir dos veces seguidas exactamente el mismo vector de sensores de altitud y cizalladura del viento, ningún ingeniero lo certificaría para volar. Los LLM conversacionales violan este axioma de reproducibilidad en dos niveles matemáticos diferenciados.
El primer nivel es el muestreo estocástico explícito durante la generación autorregresiva. Las interfaces de chat comerciales y por API decodifican cada token vk muestreando una distribución softmax sobre logits zk escalada por temperatura y truncada por núcleo (top-p). Al ser la generación causal y autorregresiva, cada token muestreado se incorpora al historial condicionante v1:k del paso k + 1.
Analícese lo que sucede cuando un operador pide dos veces a un LLM una perspectiva sobre Bitcoin en el cierre exacto de la misma vela. Supóngase que en la posición de token k = 14 las probabilidades de los logits asignan 0.44 al adjetivo "resilient" (resiliente) y 0.41 a "exhausted" (agotado). En la Consulta 1, el muestreo extrae "resilient", condicionando a todos los cabezales de atención posteriores a recuperar plantillas de ruptura alcista y proyectar $78,000. En la Consulta 2, tres segundos más tarde sobre datos de mercado idénticos, el muestreo extrae "exhausted", condicionando a los tokens subsiguientes a recuperar plantillas de techo distributivo y proyectar $56,000. A lo largo de N = 100 consultas idénticas, las trayectorias se abren en abanico formando una nube multimodal de relatos incompatibles, incluidas ejecuciones atípicas de cola pesada donde el muestreo secuencial se desvía hacia ramas de baja probabilidad y fabrica un historial de precios inexistente.
Una objeción habitual de ingeniería sostiene que fijar la temperatura de decodificación en cero (τ → 0+, decodificación voraz argmax) elimina esta inestabilidad. La investigación empírica en sistemas demuestra que ni siquiera temperature = 0 garantiza un razonamiento determinista en los clústeres modernos de inferencia sobre GPU. Atil et al. [4] evaluaron LLM de frontera a través de ejecuciones repetidas idénticas con temperature = 0 y semillas aleatorias fijas, definiendo la Tasa de Acuerdo Total sobre N ejecuciones tanto a nivel de cadena bruta (TARr@N) como a nivel de respuesta extraída (TARa@N). Documentaron oscilaciones de exactitud de hasta un 10% a un 15% en ejecuciones voraces idénticas, siendo las tareas matemáticas y de razonamiento en varios pasos las que sufrieron mayor deriva [4].
La causa física de la deriva con temperature = 0 reside en la no asociatividad de la aritmética en coma flotante IEEE-754 dentro de los árboles paralelos de reducción en GPU, combinada con la amplificación autorregresiva del error:
En la Ecuación (3), ⊕BF16 denota la suma Brain Floating-Point de 16 bits (con apenas 7 bits de precisión en la mantisa) ejecutada en servidores GPU con agrupamiento continuo dinámico de lotes (como vLLM o enrutadores Mixture-of-Experts). Dependiendo de cuántas solicitudes concurrentes de otros usuarios compartan el lote en ese milisegundo dentro de la GPU, los hilos paralelos de CUDA suman productos matriz-vector siguiendo un orden distinto en el árbol de reducción, desplazando los logits en 10-4..10-3. Cada vez que dos tokens financieros rivales presentan logits casi empatados (algo constante en regímenes ruidosos de mercado al 50/50), ese desplazamiento microscópico en coma flotante invierte el argmax voraz en un token y desencadena en cascada un párrafo analítico por completo diferente [4].
La Ecuación (3) deja al descubierto un defecto fatal para la asignación de capital. Incluso bloqueando una API de LLM en temperature = 0, la respuesta operativa obtenida depende de cuántos desconocidos estén conversando con el mismo clúster de GPU en la nube durante ese mismo milisegundo. En regímenes financieros ruidosos donde las tesis alcistas y bajistas portan probabilidades textuales cercanas, diminutos redondeos de GPU alteran una palabra inicial y reescriben toda la tesis de operación.
Más allá de la inestabilidad entre ejecuciones se alza una barrera teórica aún más profunda: la inevitabilidad matemática de la alucinación. Muchos profesionales suponen que las alucinaciones son fallos transitorios de ingeniería que conjuntos de entrenamiento más grandes acabarán erradicando. En el 56.º Simposio ACM sobre Teoría de la Computación (STOC 2024), Kalai y Vempala [2] demostraron exactamente lo contrario. Establecieron una cota inferior estadística rigurosa que prueba que todo modelo generativo de lenguaje calibrado debe alucinar a una tasa acotada inferiormente por la masa de ejemplares únicos (singletons) de Good-Turing correspondiente a hechos cuya veracidad no puede deducirse de forma determinista solo a partir de la gramática:
Desglosar cada término de la Ecuación (4) revela por qué los mercados financieros constituyen el peor escenario posible para la alucinación generativa. Aquí ℋfalse es el conjunto de afirmaciones verosímiles pero falsas, n1 / n es el estimador de Good-Turing de masa de distribución no observada (la fracción de realizaciones de estado que aparecen exactamente una sola vez en n ejemplos de entrenamiento), κcal(πθ) mide el desajuste estadístico de calibración durante el preentrenamiento y |𝒱ded| / |𝒱arb| representa la razón entre hechos deducibles lógicamente y realizaciones estocásticas. De manera complementaria, la teoría de la computabilidad desarrollada por Xu, Jain y Kankanhalli [3] demostró mediante límites de aprendizaje al estilo de Gold que ningún LLM computable puede eliminar la alucinación sobre estados abiertos del mundo.
¿Por qué golpea con tanta dureza la Ecuación (4) al pronóstico financiero? Cada estado diario multiactivo del mercado (precios cruzados exactos, profundidad del libro de órdenes, diferenciales de rendimiento y sorpresas macroeconómicas) constituye una realización continua irrepetible que ocurrió a lo sumo una vez (n1 / n → 1 en un espacio de estados continuo). Forzado a seguir redactando oraciones fluidas sobre estados continuos inéditos sin abstenerse, un modelo generativo de texto está matemáticamente obligado a inventar falsedades de apariencia plausible.
Realícese una comprobación numérica directa sobre la Ecuación (4). Supóngase que un operador envía N = 100 consultas solicitando a un LLM conversacional coordenadas intradía exactas de soporte, resistencia y stop-loss en regímenes de volatilidad poco habituales donde la tasa de novedad de ejemplares únicos verifica n1 / n ≥ 0.22 y la holgura de calibración es 0.04. Incluso bajo un preentrenamiento ideal, al menos entre 15 y 18 de cada 100 pronósticos generados contendrán afirmaciones numéricas abiertamente fabricadas (como citar una media móvil o un nivel de Fibonacci a cientos de puntos de donde cotiza realmente el activo). En la operativa apalancada, apenas dos o tres coordenadas alucinadas de stop-loss en cien operaciones bastan para desencadenar un severo drawdown en la cuenta.
4. Sofistería persuasiva por RLHF, inducción por prompts en redes sociales y contaminación anticipatoria en el preentrenamiento
Si los LLM generativos fracasan en la tokenización numérica, derivan en ejecuciones repetidas y alucinan niveles a tasas matemáticamente acotadas por debajo, ¿por qué se han propagado con tal rapidez en los canales minoristas de trading? La respuesta reside en la mecánica de alineación posterior al entrenamiento. Los modelos conversacionales modernos se someten a Aprendizaje por Refuerzo a partir de Retroalimentación Humana (RLHF) o a Optimización Directa de Preferencias (DPO), ajustando los parámetros θ para maximizar un modelo de recompensa de preferencia humana rφhuman(x, y) regularizado frente a una política de referencia πref:
Examínese qué mide en realidad rφhuman(x, y) en la Ecuación (5). Los evaluadores humanos que califican pares de respuestas de IA durante el post-entrenamiento no aguardan treinta sesiones bursátiles para comprobar si una trayectoria proyectada en BTCUSD o EURUSD minimizó la puntuación de Brier fuera de muestra. Los anotadores puntúan las respuestas en pocos segundos guiándose por el formato estructural, el tono seguro, la ausencia de matices dubitativos y la concordancia con la premisa sugerida en el prompt del usuario.
Dos estudios revisados por pares en ICLR documentan los peligrosos efectos secundarios de la Ecuación (5). Primero, Sharma et al. en Anthropic (ICLR 2024) [12] demostraron que los modelos de recompensa RLHF incentivan de forma sistemática la complacencia aduladora (sycophancy): adaptar las conclusiones para validar cualquier sesgo direccional implícito en la instrucción del usuario en lugar de defender la realidad objetiva. Si un operador pregunta: «Explica por qué el Oro parece listo para romper por encima de 4,200», el modelo construye diligentemente un argumento institucional alcista; si dos minutos después pregunta: «Explica por qué el Oro está formando un techo previo a un desplome bajo 3,600», exactamente el mismo modelo elabora una tesis bajista igual de convincente.
Segundo, Wen et al. (ICLR 2025) [13] demostraron que el RLHF entrena activamente a los modelos de lenguaje en sofistería no intencionada (U-Sophistry): los modelos se vuelven mediblemente más hábiles para persuadir a evaluadores humanos con límite de tiempo de que un razonamiento defectuoso es correcto, inflando la confianza humana en falsos positivos incluso cuando la exactitud real de la tarea es cero. Para agravar esa trampa persuasiva, Xiong et al. (ICLR 2024) [14] evaluaron la elicitación de probabilidades verbalizadas en LLM de frontera y hallaron un exceso severo de confianza: los modelos declaran de manera habitual una "confianza del 80% al 85%" en tareas donde la precisión empírica realizada apenas ronda el 50% equivalente a lanzar una moneda al aire.
La Ecuación (5) explica el bucle viral de las redes sociales. Un creador en Instagram, YouTube o TikTok redacta un prompt estilizado ordenando a un LLM que hable como el analista cuantitativo de un fondo de cobertura. El ajuste RLHF optimiza la salida para maximizar la persuasión humana rφhuman, generando viñetas deslumbrantes que convencen a seguidores minoristas de arriesgar dinero real sobre una prosa carente de todo fundamento matemático.
¿Qué ocurre con los artículos de blog o preprints que afirman que ChatGPT o GPT-4 batieron a los índices de referencia del mercado en backtests históricos entre 2018 y 2023? Dos rigurosos estudios empíricos desmontan tales afirmaciones. En primer lugar, Xie, Han, Lai, Peng y Huang [10] evaluaron ChatGPT sin ajuste previo (zero-shot, incluyendo prompts Chain-of-Thought y texto social multimodal) sobre bancos de pruebas de movimiento bursátil en "The Wall Street Neophyte", comprobando que ChatGPT rindió por debajo no solo de las arquitecturas neuronales especializadas, sino incluso de los modelos base numéricos lineales y autorregresivos elementales.
En segundo lugar, Sarkar y Vafa en la Universidad de Chicago y la Universidad de Harvard [11] probaron que el aparente alfa histórico de pronóstico en LLM preentrenados padece una grave contaminación por sesgo anticipatorio de preentrenamiento (look-ahead bias). Dado que los modelos fundacionales se preentrenan con volcados de internet que abarcan hasta su fecha de corte de conocimiento, sus miles de millones de pesos memorizan implícitamente resultados corporativos trimestrales, desplomes pandémicos, repuntes inflacionarios y ciclos alcistas cripto ocurridos después de la fecha histórica simulada en el prompt. Instruir al modelo para que «ignore el conocimiento futuro» no logra borrar las correlaciones paramétricas memorizadas [11]. En el instante en que el reloj supera la fecha de corte de preentrenamiento del modelo y se adentra en velas en vivo genuinamente inéditas, ese pseudo-alfa memorizado se evapora. La Tabla 1 sintetiza estas siete dimensiones estructurales a través de los distintos paradigmas de modelado.
| Dimensión de evaluación | LLM conversacional de texto (ChatGPT / Claude / DeepSeek) |
VLM multimodal general sobre capturas de gráficos | Series temporales envueltas en LLM (Time-LLM / GPT4TS) |
4CastMachine AI (Quad-AI separado por dominios) |
|---|---|---|---|---|
| Representación nativa de entrada | Cadenas discretas de subpalabras BPE; rompe la distancia euclídea numérica [5] | Parches visuales de 14×14 proyectados con pérdida a tokens léxicos [8] |
Parches numéricos proyectados sobre inmersiones lingüísticas congeladas [1] | Tensores exactos IEEE-754 OHLCV + codificador PNL aislado de atributos |
| Objetivo de pérdida en entrenamiento | Entropía cruzada léxica + preferencia humana RLHF [12, 13] | Pérdida contrastiva / entropía cruzada imagen-subtítulo | Reconstrucción de parches enrutada por capas de lenguaje | Puntuación continua estrictamente propia (CRPS, Brier) + geometría de riesgo |
| Reproducibilidad en 100 ejecuciones | Falla: diverge bajo muestreo y deriva un 10-15% incluso en τ=0 [4] |
Falla: sensible al recorte, zoom, tema visual y redacción del prompt [8] | Determinista solo si se anula el muestreo LLM; 100x desperdicio de cómputo [1] |
100% determinista: Varrun(ŷt) = 0 sobre idéntica filtración ℱt |
| Vulnerabilidad a alucinaciones | Acotada inferiormente por la tasa de ejemplares únicos de Good-Turing [2, 3] | Inventa directrices y lee mal coordenadas de ejes en gráficos densos | Los pesos preentrenados del LLM añaden cero exactitud frente a atención simple [1] | Cortafuegos semántico: el módulo PNL jamás emite coordenadas de precio |
| Riesgo de complacencia ante el prompt | Alto: alterna entre alcista y bajista para complacer el encuadre del usuario [12, 13] | Alto: fuerte sesgo alcista incondicional e insensibilidad al horizonte [8] | Bajo, pero expuesto a fugas de la fecha de corte del preentrenamiento | Cero: cálculo matemático de estado no conversacional |
| Integridad de auditoría histórica | Contaminada por fuga anticipatoria (look-ahead) del corpus preentrenado [11] | Contaminada si las fechas o marcas del gráfico caen antes del corte | Exige aislamiento walk-forward estricto; elevado costo computacional | Archivo causal walk-forward estricto (auditado de forma continua desde 2015) |
| Salida accionable de riesgo | Prosa narrativa infalsable con sobreconfianza verbalizada [14] | Etiquetas cualitativas de ondas sin invalidación calibrada | Escalar puntual o cuantílico sin mapa estructural de regímenes | Buy/Sell Zone explícita, invalidación Pivot, TP1-TP5 y DTO |
5. Dónde pertenecen realmente los modelos de lenguaje: el cortafuegos semántico dentro de Sentiment AI frente a los motores cuantitativos
Demostrar que los LLM generativos fracasan en el cálculo cuantitativo de precios no significa que los transformadores de lenguaje natural carezcan de lugar dentro de una pila moderna de ingeniería financiera. Utilizar un LLM para calcular probabilidades de velas o resolver la geometría multitemporal de soportes es como emplear un micrófono de precisión como gato hidráulico: el fallo proviene de aplicar un instrumento especializado a la modalidad física equivocada. Cuando se restringen de manera estricta al lenguaje humano no estructurado, los codificadores transformadores adaptados al dominio ejecutan una tarea que los filtros numéricos puros de series temporales no pueden realizar por sí solos.
Cada jornada bursátil, los gobernadores de bancos centrales publican comunicados de política monetaria, los institutos estadísticos difunden revisiones de inflación y empleo, las agencias geopolíticas emiten despachos urgentes sobre interrupciones imprevistas de suministro y miles de crónicas financieras interpretan giros macroeconómicos. Antes de que esos acontecimientos terminen de vaciarse en los libros de órdenes límite, su contenido semántico existe únicamente como texto no estructurado Dt. Los modelos de lenguaje financiero calibrados por dominio (basados en los hallazgos léxicos financieros de Loughran y McDonald [17] y en las inmersiones contextuales de FinBERT propuestas por Araci [18]) sobresalen al leer miles de titulares por minuto, resolver negaciones y matices de banca central y medir si el flujo entrante de texto porta presión macroeconómica positiva o negativa.
Dentro de 4CastMachine AI, desplegamos exactamente esa capacidad lingüística en el Motor 2 (Sentiment AI) imponiendo al mismo tiempo una frontera arquitectónica innegociable que denominamos el Cortafuegos Semántico (Semantic Firewall). En Sentiment AI, al modelo de lenguaje jamás se le pregunta dónde cotizarán mañana el Bitcoin o el Oro, jamás se le permite trazar una zona de soporte y jamás se le autoriza a dirigirse al operador con relatos persuasivos. Por el contrario, Sentiment AI opera estrictamente como un sensor semántico acotado que transforma flujos de texto no estructurado Dt y archivos históricos de eventos macroeconómicos ℋhist en un vector numérico calibrado de baja dimensión:
Sígase paso a paso cada componente de la Ecuación (6) para observar cómo cada motor de Quad-AI permanece rigurosamente dentro de su dominio matemático de validez:
- Motor 2 · Sentiment AI (ℰSentiment, responde a «El Porqué»): Lee cables informativos multifuente en vivo Dt mediante modelado contextual del lenguaje para extraer polaridad direccional acotada pt ∈ [-1, +1], sorpresa estandarizada del calendario macroeconómico ze,t, similitud coseno semántica simcos(𝐞(Dt), 𝐞(ℋhist)) frente a episodios macro históricos con impacto conocido en volatilidad realizada e intensidad de llegada de Hawkes λt. Su salida es exclusivamente un vector numérico estructurado 𝐳tnews, nunca un objetivo de precio.
- Motor 1 · Forecast AI (𝒬Fcst, responde a «El Qué»): Opera exclusivamente sobre tensores continuos precio-volumen IEEE-754 𝐗t-L:t a lo largo de nueve temporalidades (de
1maM), calculando estructura de mercado multitemporal, proporciones armónicas y geométricas de ondas, zonas de oferta y demanda y probabilidades calibradas de velas Daily Trading Opportunity (DTO) sin tocar un solo token verbal. - Motor 3 · Synergy AI (𝒢Syn, responde a «El Cómo»): Arbitra de forma continua entre
Forecast AIySentiment AImediante una compuerta softmax condicionada por el régimen (detallada en nuestro artículo sobre ponderación dinámica de regímenes en Synergy AI), suprimiendo el ruido mediático durante las horas difusivas tranquilas y elevando el peso de 𝐳tnews durante los choques de salto de alta sorpresa. - Motor 4 · Navigator AI (𝒩Nav, responde a «Qué Hacer»): Resuelve una optimización prescriptiva determinista sobre la superficie reconciliada de probabilidades para trazar una única hoja de ruta falsable en el gráfico ℛt:
Buy zoneoSell zoneexplícita, frontera estructural de invalidación (Pivot), escalera gradual deProfit zone(TP1aTP5),Reverse zonecondicional y flechas direccionalesGreen Arrows.
Volvamos a nuestra analogía del periodista de prensa escrita. En la Ecuación (6), contratamos al periodista (Sentiment AI) únicamente para leer despachos urgentes en cincuenta milisegundos, puntuar si el tono del comunicado es restrictivo (hawkish) o acomodaticio (dovish) y recuperar titulares históricos análogos del archivo. Jamás permitimos que el periodista toque las ecuaciones diferenciales. Todo el cálculo de trayectorias, la ponderación de regímenes y la geometría del stop-loss son resueltos aguas abajo por motores cuantitativos dedicados (Forecast AI, Synergy AI y Navigator AI).
Esta división del trabajo se extiende al conjunto del ecosistema ForecastCity de nueve sistemas especializados de IA. Las interfaces conversacionales de explicación, como AI Trading Assistant, ayudan a los usuarios a navegar por las herramientas del entorno o a traducir reglas escritas de estrategia en lenguaje claro, mientras que AI Strategy Studio, Virtual Accounts y 4CastMachine AI ejecutan matemáticas cuantitativas 100% deterministas sobre velas históricas y en tiempo real. La Tabla 2 resume qué tareas corresponden a la IA lingüística frente a la IA cuantitativa continua.
| Tarea del sistema financiero | Modalidad matemática | Paradigma correcto de IA | Consecuencia de aplicar erróneamente un LLM generativo |
|---|---|---|---|
| Análisis de comunicados de bancos centrales y titulares macro | Lenguaje natural discreto no estructurado Dt ∈ 𝒱* | PNL financiero adaptado al dominio / LLM codificador (Sentiment AI) |
Dominio válido cuando la salida se restringe a escalares numéricos calibrados de polaridad y analogía histórica |
| S/R multitemporal, armónicos y probabilidades de velas | Tensor real continuo 𝐗t-L:t ∈ ℝL×d | Espacio de estados continuo y estimadores de rango (Forecast AI) |
Distorsión métrica BPE, colapso del 65% ante distractores [7] y niveles de soporte o resistencia inventados |
| Arbitraje entre estructura técnica y velocidad de noticias urgentes | Espacio conjunto de difusión con saltos e intensidad de Hawkes | Mezcla de expertos Softmax continua (Synergy AI) |
Cambio arbitrario de relato; sesgo de recencia hacia el último titular incluido en el prompt |
| Especificación de zonas de entrada, invalidación Pivot y TP1-TP5 | Optimización de riesgo con restricción de tiempos de parada | Optimización prescriptiva en gráfico (Navigator AI) |
Prosa infalsable, ausencia de fronteras de invalidación y ruina por drawdown asimétrico |
6. Evidencia en gráficos en vivo: hojas de ruta deterministas de Quad-AI en BTCUSD (D) y XAUUSD (4h) frente a la deriva narrativa generativa
Para concretar el contraste entre la prosa conversacional de un LLM y el pronóstico cuantitativo determinista, examinamos dos gráficos reales de producción capturados en 4CM-AI Charts a través de dos clases de activos y horizontes temporales diferenciados: Bitcoin (BTCUSD) en el horizonte Diario (D) y Oro (XAUUSD) en el horizonte de 4 horas (4h).
Considérese primero qué sucede cuando un operador o presentador en redes sociales solicita a un LLM de propósito general (o sube una imagen bruta de velas) una perspectiva sobre Bitcoin mientras BTCUSD cotiza cerca de 64,570.00 tras retroceder desde un máximo otoñal próximo a 87,000. A lo largo de consultas repetidas, los modelos conversacionales se escinden en relatos incompatibles. Una ejecución se fija en las pronunciadas velas rojas de noviembre y advierte de un desplome inminente hacia $50,000; una segunda ejecución recita argumentos macroeconómicos sobre la adopción institucional de Bitcoin y anuncia un rebote inmediato en V hasta $90,000; una tercera ejecución inventa niveles aproximados de Fibonacci que no coinciden con el máximo ni con el mínimo reales de la cinta de precios. Ninguno de esos párrafos define una frontera exacta de invalidación ni reconcilia por qué las temporalidades intradía discrepan de la tendencia diaria.
Inspecciónese ahora la Figura 3, que muestra la hoja de ruta determinista de 4CastMachine AI sobre BTCUSD (D) calculada a partir de coordenadas continuas exactas OHLCV y reconciliada entre temporalidades.
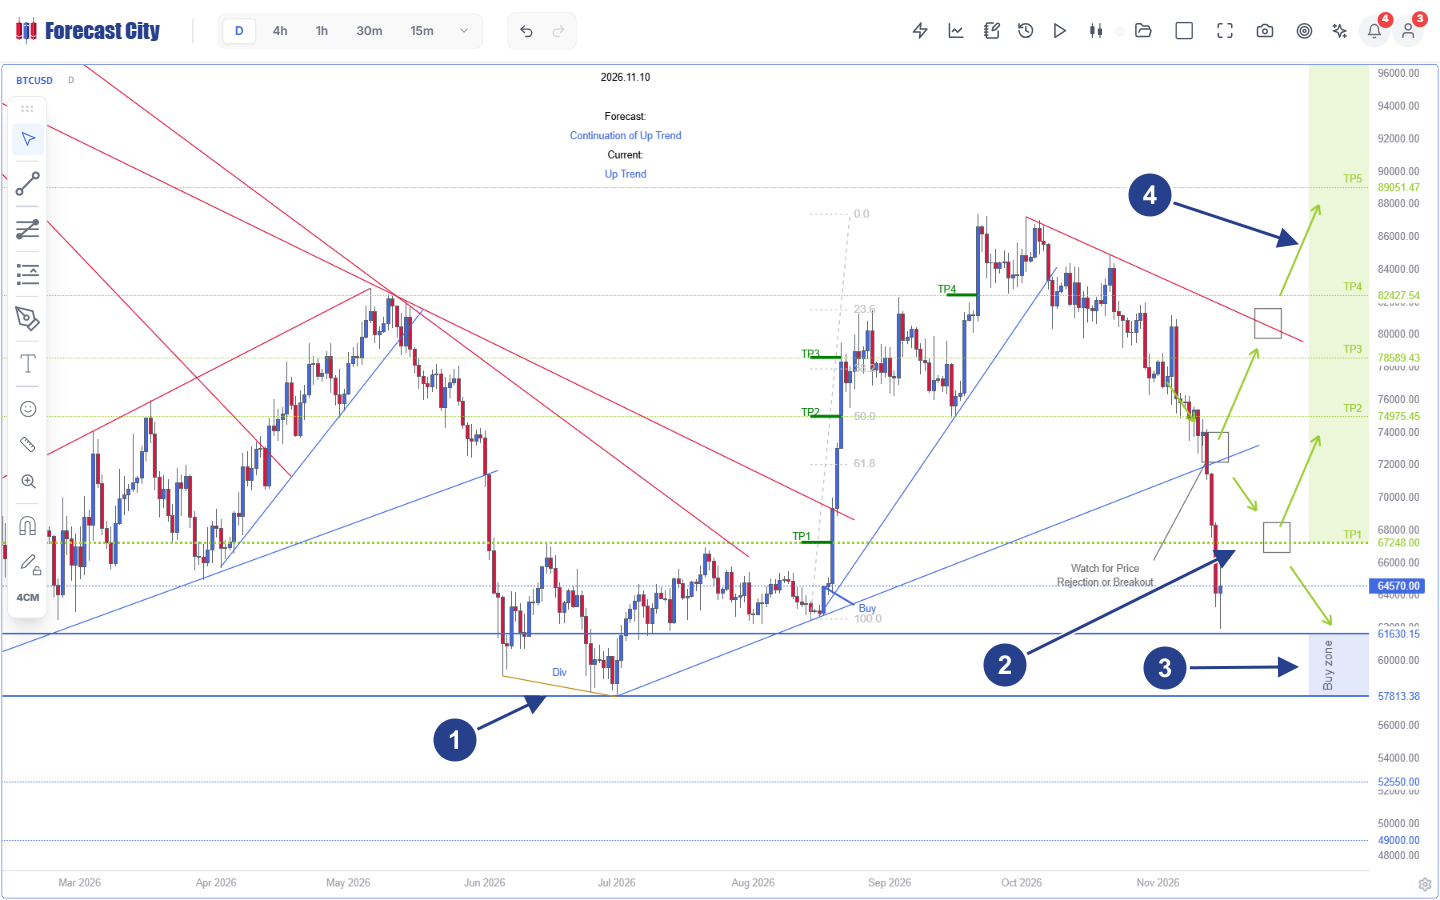
BTCUSD, temporalidad Diaria D, contado 64,570.00): A diferencia de la generación estocástica de texto que deriva entre consultas, Quad-AI proyecta una geometría exacta y reproducible de coordenadas anclada a giros históricos auditados y nodos condicionales explícitos de decisión.
- 1Base estructural auditada (
Divy tramo Fibonacci100.0-0.0): Divergencia alcista de junio-julio en57,813.38seguida por la configuraciónBuyde agosto que alcanzó de manera secuencial los objetivos históricosTP1,TP2,TP3yTP4. - 2Nodos condicionales de decisión: Tres bifurcaciones explícitas
Watch for Price Rejection or Breakouta lo largo del soporte azul ascendente perforado y la directriz roja descendente de resistencia, sustituyendo la prosa ambigua por condiciones geométricas verificables. - 3
Buy zonecuantificada (57,813.38-61,630.15): Banda exacta de demanda institucional bajo el precio de contado64,570.00, respaldada por suelos estructurales inferiores en52,550.00y49,000.00. - 4Escalera gradual de
Profit zone(TP1-TP5): Objetivos alcistas reproducibles enTP1 = 67,248.00,TP2 = 74,975.45,TP3 = 78,589.43,TP4 = 82,427.54yTP5 = 89,051.47.
Examínese en detalle la coherencia multitemporal que sustenta la Figura 3. Con el precio al contado en 64,570.00, las correcciones de corto plazo permanecen activas en los horizontes inferiores (30m bajista por debajo de 66,422.24, 1h bajista por debajo de 67,566.58 y 4h bajista por debajo de 72,769.47), mientras que la estructura macro semanal se mantiene alcista por encima de 48,879.14 y la continuación diaria se torna decididamente alcista al superar 67,248.00 (TP1). En lugar de adivinar si la vela roja correctiva se detendrá en 64,570.00 o profundizará antes, Navigator AI traza explícitamente ambas ramas: o bien el precio pone a prueba y rechaza dentro de la Buy zone de 57,813.38 a 61,630.15, o bien recupera el nodo de decisión en 67,248.00 para reanudar el ascenso principal hacia 74,975.45 (TP2) y 89,051.47 (TP5).
La brecha entre la conjetura visual de Gestalt y el cálculo continuo de coordenadas resulta aún más nítida en temporalidades intradía inferiores como 4h, donde las directrices secantes, las inversiones de polaridad y los estrechos umbrales de invalidación exigen exactitud al dólar. La Figura 4 muestra el Oro (XAUUSD) en la temporalidad 4h con cotización al contado en 3,879.59.
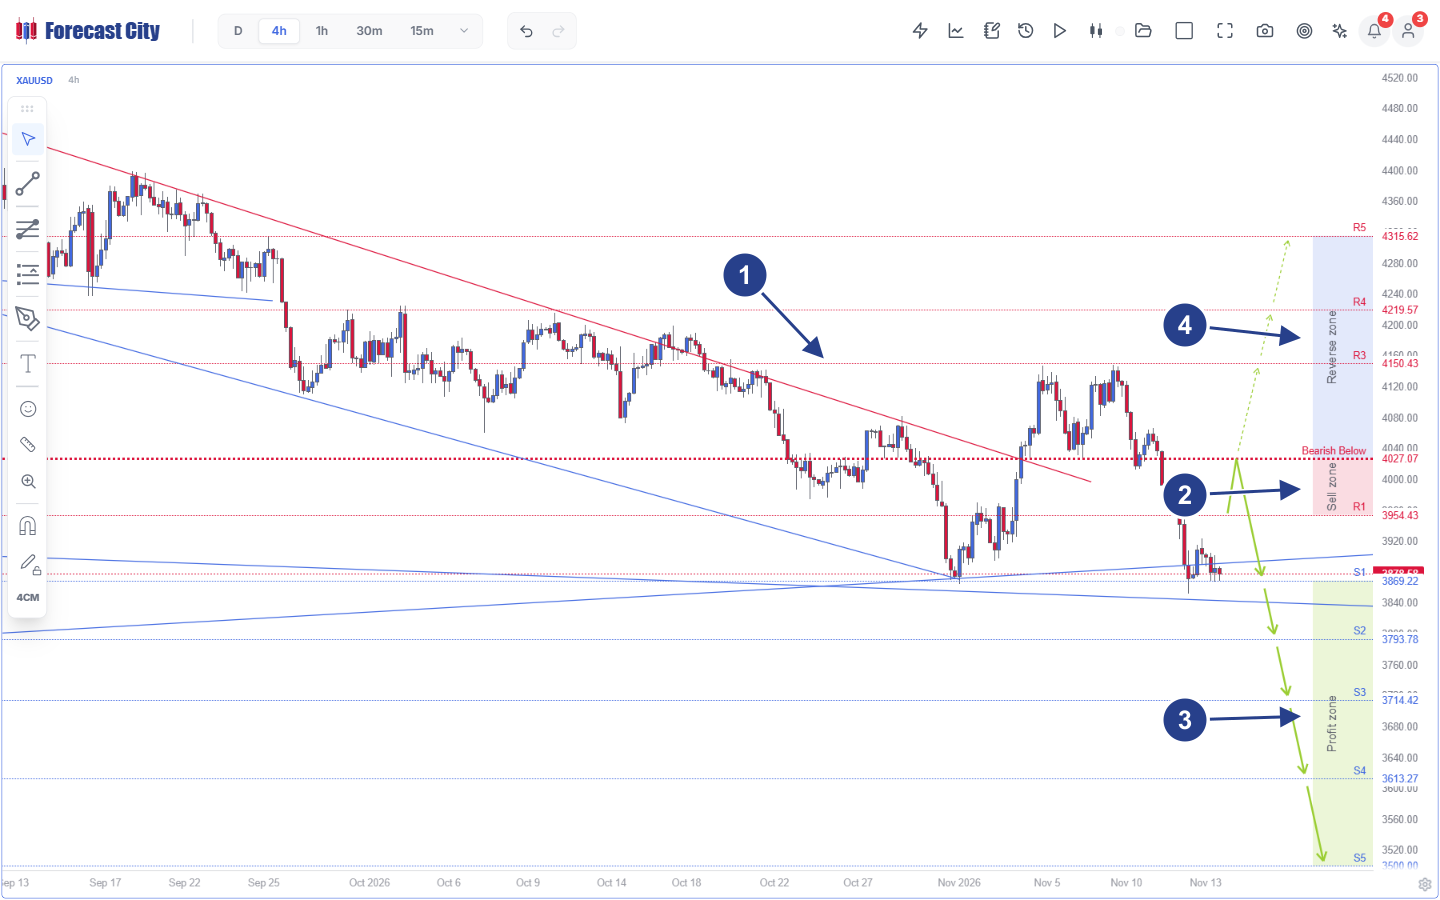
XAUUSD, temporalidad 4h, contado 3,879.59): Allí donde los codificadores multimodales de parches VLM difuminan los rechazos finos de mecha y la geometría de abanicos convergentes, Quad-AI resuelve coordenadas exactas de doble escenario desde R5 (4,315.62) hasta S5 (3,500.00).
- 1Geometría plurisemanal de ondas y directrices: Línea roja descendente de resistencia desde septiembre superada a comienzos de noviembre, seguida de un rechazo de doble techo bajo
4,150.43y ruptura bajista de regreso hacia el abanico azul convergente de soporte cerca de3,869.22. - 2
Sell zonee invalidación estrictaPivot: Zona superior de oferta para retrocesos que comienza enR1 = 3,954.43y queda estrictamente invalidada por encima deBearish Below 4,027.07. - 3
Green Arrowsprimarias yProfit zone(S1-S5): Trayectoria bajista principal con objetivos escalonados enS1 = 3,869.22,S2 = 3,793.78,S3 = 3,714.42,S4 = 3,613.27yS5 = 3,500.00. - 4
Reverse zonecondicional (R3-R5): Ruta alcista alternativa precalculada (Dashed Arrows) haciaR3 = 4,150.43,R4 = 4,219.57yR5 = 4,315.62si y solo si el precio invalida4,027.07.
Compárese la ejecución del riesgo de capital sobre el estado en vivo de XAUUSD en 4h de la Figura 4 (contado 3,879.59) bajo ambos paradigmas:
1. Modo de fallo del LLM / VLM conversacional: Al observar la brusca caída del Oro desde 4,145 hasta 3,879.59, un modelo conversacional o bien persigue el impulso vendiendo de inmediato en 3,879.59 justo encima del soporte del abanico azul en S1 = 3,869.22 (exponiendo una posición corta a un estrangulamiento alcista inmediato de entre $75 y $147), o bien declara que el Oro está «sobrevendido» sin ofrecer un precio estructural de invalidación. Consultar diez veces al modelo arroja diez cifras distintas de stop-loss acompañadas de una confianza verbal sin calibrar [4, 14].
2. Geometría determinista de ejecución en Quad-AI: En el contado 3,879.59, el precio se ubica apenas $10.37 por encima de S1 = 3,869.22 y $147.48 por debajo del Pivot de invalidación en 4,027.07, de modo que abrir cortos a mercado de forma inmediata conlleva una relación beneficio-riesgo degradada de 10.37 / 147.48 = 0.070 hasta S1. Esperar un rebote correctivo hacia el punto medio de la Sell zone (3,990.75, a mitad de camino entre R1 = 3,954.43 y Pivot = 4,027.07) comprime la distancia al stop estructural hasta 4,027.07 - 3,990.75 = $36.32 al tiempo que amplía el recorrido bajista hacia S2 = 3,793.78 hasta $196.97 (relación beneficio-riesgo 5.42 : 1) y hacia S3 = 3,714.42 hasta $276.33 (relación beneficio-riesgo 7.61 : 1). Cada coordenada se reproduce al centavo exacto en 100 de cada 100 evaluaciones. Los lectores pueden estudiar las reglas sistemáticas de ejecución para estas zonas en el curso Trend Hunter Strategy en ForecastCity Academy y consultar la bibliografía matemática completa en la página de Fuentes de la Academia.
Preguntas frecuentes
¿Fijar temperature = 0 o emplear prompts Chain-of-Thought vuelve fiable a un LLM para el pronóstico de mercados?
No. Atil et al. [4] demostraron que incluso con temperature = 0 y semillas aleatorias fijas, los LLM de frontera exhiben entre un 10% y un 15% de deriva en sus respuestas a lo largo de ejecuciones idénticas, debido a que las reducciones matriciales en coma flotante de 16 bits sobre GPU con agrupamiento dinámico de lotes no son asociativas, invirtiendo logits empatados que se propagan autorregresivamente. Asimismo, los prompts Chain-of-Thought siguen operando sobre tokens numéricos fragmentados por BPE, donde Apple Research (GSM-Symbolic [7]) documentó colapsos de precisión de hasta un 65% al variar las constantes numéricas o añadir una sola cláusula irrelevante del mercado.
¿Por qué fallan los Modelos de Visión y Lenguaje (VLM) multimodales cuando reciben capturas limpias de gráficos de velas?
Los VLM multimodales dividen las imágenes del gráfico en parches gruesos de 14×14 o 16×16 píxeles y los proyectan mediante un adaptador con pérdida hacia el espacio de tokens del lenguaje natural. Aunque reconocen siluetas cualitativas de ondas de modo similar a un vistazo humano superficial, las pruebas de referencia de Hu et al. [8] demuestran que pierden las proporciones exactas de mechas OHLC, ignoran el escalado de volatilidad por ATR, presentan un marcado sesgo alcista incondicional y colapsan hacia un Coeficiente de Información cercano a cero en regímenes laterales o volátiles frente a los modelos cuantitativos que operan directamente sobre tensores IEEE-754 OHLCV.
¿Por qué algunos backtests virales en redes sociales afirman que ChatGPT o GPT-4 superaron a los índices bursátiles o cripto?
Sarkar y Vafa en las universidades de Chicago y Harvard [11] probaron que los backtests históricos realizados con LLM preentrenados comerciales sufren una severa contaminación anticipatoria (look-ahead bias): los pesos del modelo memorizaron implícitamente desenlaces corporativos, macroeconómicos y de precios ocurridos antes de la fecha de corte de su entrenamiento. Cuando se evalúan estrictamente fuera de muestra sobre velas inéditas en vivo o mediante ablaciones controladas (Tan et al., NeurIPS 2024 [1]; Xie et al. [10]), los modelos troncales de lenguaje preentrenados aportan cero ventaja numérica de pronóstico frente a los motores cuantitativos dedicados.
¿Cómo utiliza 4CastMachine AI modelos de lenguaje dentro de Sentiment AI sin exponer a los operadores a alucinaciones numéricas?
4CastMachine AI impone un estricto Cortafuegos Semántico dentro de su arquitectura Quad-AI. Los modelos contextuales de lenguaje financiero dentro de Sentiment AI se emplean exclusivamente para leer agencias de noticias no estructuradas, puntuar la polaridad direccional y calcular la similitud semántica frente a eventos macroeconómicos históricos, emitiendo escalares numéricos acotados [pt, ze,t, sim, λt]. Ningún LLM genera jamás objetivos de precio; todas las densidades continuas de probabilidad, los pesos dinámicos de régimen y las zonas sobre el gráfico son calculados de forma determinista por Forecast AI, Synergy AI y Navigator AI.
Referencias académicas y del sector
- [1]Tan, M., Merrill, M. A., Gupta, V., Althoff, T., & Hartvigsen, T. (2024). Are Language Models Actually Useful for Time Series Forecasting? Advances in Neural Information Processing Systems (NeurIPS 2024 Spotlight), 37.
- [2]Kalai, A. T., & Vempala, S. S. (2024). Calibrated Language Models Must Hallucinate. Proceedings of the 56th Annual ACM Symposium on Theory of Computing (STOC 2024), 160-171.
- [3]Xu, Z., Jain, S., & Kankanhalli, M. (2024). Hallucination is Inevitable: An Innate Limitation of Large Language Models. arXiv preprint arXiv:2401.11817.
- [4]Atil, B., Chittams, A., Fu, L., Ture, F., Xu, L., & Baldwin, B. (2024). LLM Stability: A Detailed Analysis with Some Surprises. arXiv preprint arXiv:2408.04667.
- [5]Singh, A. K., & Strouse, D. J. (2024). Tokenization Counts: The Impact of Tokenization on Arithmetic in Frontier LLMs. arXiv preprint arXiv:2402.14903.
- [6]Dziri, N., Lu, X., Sclar, M., Li, X. L., Jiang, L., Lin, B. Y., ... & Choi, Y. (2023). Faith and Fate: Limits of Transformers on Compositionality. Advances in Neural Information Processing Systems (NeurIPS 2023), 36, 70293-70332.
- [7]Mirzadeh, I., Alizadeh, K., Shahrokhi, H., Tuzel, O., Bengio, S., & Farajtabar, M. (2024). GSM-Symbolic: Understanding the Limitations of Mathematical Reasoning in Large Language Models. Apple Machine Learning Research / ICLR 2025, arXiv:2410.05229.
- [8]Hu, K., Xiao, L., Xu, S., Tang, Z., & Liu, M. (2026). Do VLMs Truly "Read" Candlesticks? A Multi-Scale Benchmark for Visual Stock Price Forecasting. arXiv preprint arXiv:2604.12659.
- [9]Jiang, J., Kelly, B., & Xiu, D. (2023). (Re-)Imag(in)ing Price Trends. The Journal of Finance, 78(6), 3193-3249.
- [10]Xie, Q., Han, W., Lai, Y., Peng, M., & Huang, J. (2023). The Wall Street Neophyte: A Zero-Shot Analysis of ChatGPT Over MultiModal Stock Movement Prediction Challenges. arXiv preprint arXiv:2304.05351.
- [11]Sarkar, S. K., & Vafa, K. (2024). Lookahead Bias in Pretrained Language Models. University of Chicago & Harvard University Working Paper, SSRN 4754678 / arXiv:2402.02092.
- [12]Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., ... & Perez, E. (2024). Towards Understanding Sycophancy in Language Models. International Conference on Learning Representations (ICLR 2024).
- [13]Wen, J., Zhong, R., Khan, A., Perez, E., Steinhardt, J., Huang, M., ... & He, H. (2025). Language Models Learn to Mislead Humans via RLHF. International Conference on Learning Representations (ICLR 2025), arXiv:2409.12822.
- [14]Xiong, M., Hu, Z., Lu, X., Li, Y., Fu, J., He, J., & Hooi, B. (2024). Can LLMs Express Their Uncertainty? An Empirical Evaluation of Confidence Elicitation in LLMs. International Conference on Learning Representations (ICLR 2024).
- [15]Zeng, A., Chen, M., Zhang, L., & Xu, Q. (2023). Are Transformers Effective for Time Series Forecasting? Proceedings of the AAAI Conference on Artificial Intelligence, 37(9), 11121-11128.
- [16]Gneiting, T., & Raftery, A. E. (2007). Strictly Proper Scoring Rules, Prediction, and Estimation. Journal of the American Statistical Association, 102(477), 359-378.
- [17]Loughran, T., & McDonald, B. (2011). When Is a Liability Not a Liability? Textual Analysis, Dictionaries, and 10-Ks. The Journal of Finance, 66(1), 35-65.
- [18]Araci, D. (2019). FinBERT: Financial Sentiment Analysis with Pre-trained Language Models. arXiv preprint arXiv:1908.10063.